
Claude Opus 4.7: Programmeringsevne +13%, uændret pris
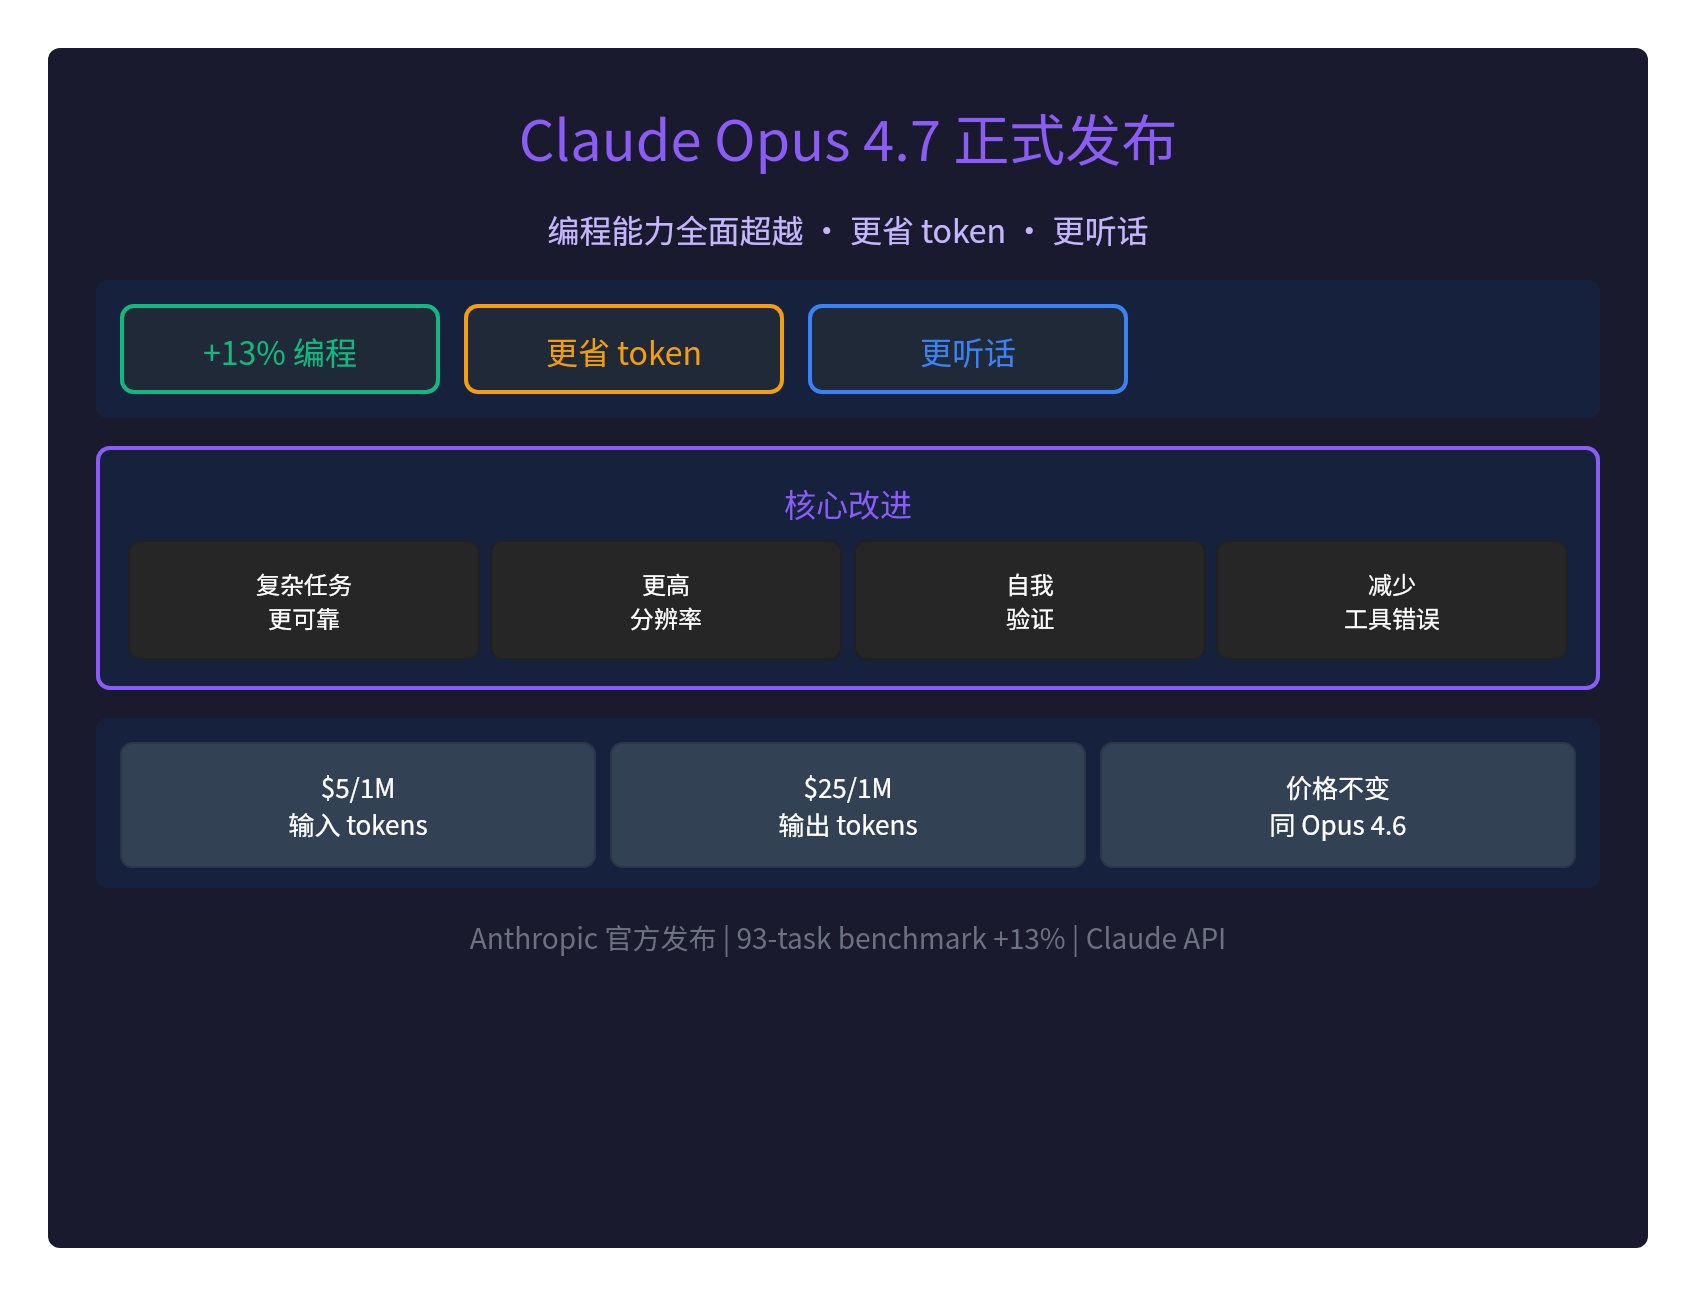
🔥 Claude Opus 4.7 officielt lanceret: Programmeringsevnen slår alt
Anthropic lancerer officieltClaude Opus 4.7, den nyeste version i Opus-serien:
- Programmeringsevnen slår alt: 93-task benchmark forbedret med 13%
- Sparer flere tokens: Opus 4.7 med low effort ≈ Opus 4.6 med medium effort
- Lydigere: følger instruktioner nøje og laver færre værktøjsfejl
Opus 4.7 har markante forbedringer inden foravanceret softwareudvikling og yder særligt godt på de allersværeste opgaver.
📊 Nøgletal
| Måling | Opus 4.7 vs Opus 4.6 |
|---|---|
| 93-task programmeringsbenchmark | +13% forbedret |
| Værktøjsfejlrate | reduceret 1/3 |
| CursorBench | 70% vs 58% |
| Benchmark for visuel præcision | 98.5% vs 54.5% |
🧠 Centrale forbedringer
1. Mere pålidelig ved komplekse opgaver
Opus 4.7 klarer sig bedre påkomplekse, langvarige opgaver:
- Nøjagtig konsistens: bevarer nøjagtighed og konsistens ved komplekse opgaver
- Præcis instruktionsfølgning: følger brugerens instruktioner strengt
- Selvverifikation: designer metoder til at verificere sine egne output
2. Visuel med højere opløsning
De visuelle evner er kraftigt forbedret:
- Højere opløsning: kan se billeder i højere opløsning
- Bedre smag: mere smag og kreativitet ved professionelle opgaver
- Højere kvalitet: genererer bedre brugerflader, slides og dokumenter
3. Færre værktøjsfejl
Opus 4.7s værktøjskald er mere pålidelige:
- Værktøjsfejl reduceret med 1/3: mere stabile værktøjskald
- Fejlrecovery: fortsætter, når et værktøj fejler, i stedet for at stoppe
- Højere kvalitet/værktøjskald-ratio: højere kvalitet pr. værktøjskald
💰 Prisen er uændret
Opus 4.7 har samme prissætning som Opus 4.6:
| Type | Pris |
|---|---|
| Input-tokens | $5/mio. |
| Output-tokens | $25/mio. |
Sparer flere tokens: Opus 4.7 med low effort ≈ Opus 4.6 med medium effort, hvilket betyderlavere omkostninger.
🎯 Forholdet til Mythos Preview
Anthropic gør det tydeligt:
- Mythos Preview er stærkere end Opus 4.7, menudgives kun i begrænset omfang
- Opus 4.7 er den første model, der testes med de nye sikkerhedsværn
- Cybersikkerhedsevner: Opus 4.7 er ikke så stærk som Mythos Preview
- Sikkerhedsværn: opdager og blokerer automatisk højrisiko-ansøgninger om cybersikkerhed
Cybersikkerhedsverifikationsprogram
Sikkerhedsprofessionelle kan ansøge omcybersikkerhedsverifikationsprogrammet:
- Sårbarhedsforskning
- Penetrationstest
- Red team-test
💡 Brugerfeedback
Vercel:
- »Enkellige kodningsopgaver er fremragende – mere korrekte og mere komplette end Opus 4.6«
- »Anerkender sine egne begrænsninger mere ærligt«
- »Beviser endda systemets kode, før arbejdet begynder«
Cursor:
- »Tydelig fremgang på CursorBench: 70% vs 58%«
- »Selvstændighed og mere kreativ ræsonnering«
Devin:
- »Kan arbejde i flere timer i træk«
- »Vedholder med svære problemer i stedet for at give op«
- »Har åbnet for dybdegående efterforskningsarbejde, der tidligere ikke kørte pålideligt«
Notion:
- »+14% successrate, færre tokens«
- »Den første model, der består testen af implicitte krav«
- »Fortsætter, når værktøjer fejler, i stedet for at stoppe«
Rakuten:
- »Rakuten-SWE-Bench løser3xflere produktionsopgaver«
- »Forbedringer i dobbelte procentpoint af både kodekvalitet og testkvalitet«
📝 Opsummering
Claude Opus 4.7 eret stort spring fremad i programmeringsevne:
- +13% på programmeringsbenchmark, 70% vs 58% på CursorBench
- Sparer flere tokens: lav omkostning, høj kvalitet
- Lydigere: følger instruktioner nøje, færre værktøjsfejl
- Selvverifikation: verificerer sine egne output
- Visuel forbedring: 98.5% vs 54.5% visuel præcision
- Uændret pris: $5/1M input, $25/1M output
Programmeringsevnen slår alt – men prisen er uændret. Det er Opus 4.7.
Officiel meddelelse:https://www.anthropic.com/news/claude-opus-4-7
Claude API:https://platform.claude.com/docs/en/about-claude/models/overview