
Parameter kecil pry kinerja besar, biaya pelatihan 1/10 dari DeepSeek r1
Banyak orang yang menembakkan " kecerdasan umum" Manus hari ini, tapi saya pikir model QwQ-32B baru yang baru dibuka Ali bahkan lebih layak dicari.
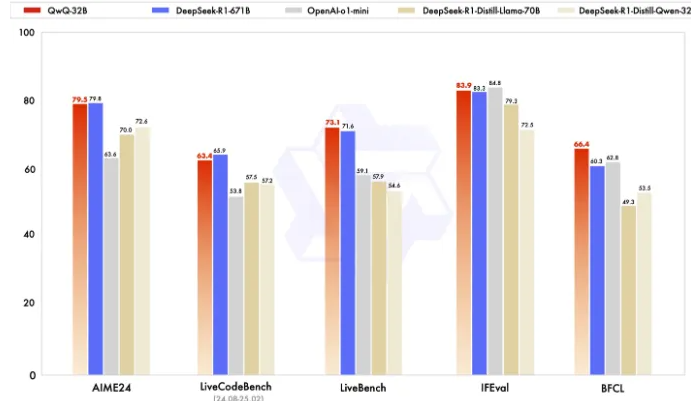
Teras terobosan dan inovasi teknologi di QwQ-32B
Saat Aliyun merilis dan membuka generasi baru dari model penalaran, QwQ-32B, pada tanggal 6 Maret 2025, dengan tujuan:Parameter 32 miliarIni adalah skala yang sangat sederhana, dicapai melalui teknik belajar yang ditingkatkanParameter month= yang tidak diketahui akan diabaikan (bantuan) DeepSeek-R1 for 671 miliar parameterKinerja yang setara, bahkan di bidang tertentu. Berikut ini adalah inti sorotan:
- Parameter revolusi efisiensi
Parameter QwQ-32B adalah hanya DeepSeek-R11/21Tapi melaluiBelajar intensif dua tahap (RL)Feasibilitas \"Model Kecil + Pembelajaran Tertingkatkan\" rute teknologi divalidasi oleh pelatihan, yang dilakukan pada atau di luar yang terakhir dalam tugas seperti penalaran matematika (AIME24 penilaian) dan pembuatan kode (LiveCodeBench). Desain ini mematahkan jalur kebergantungan tradisional pada susunan parameter dan menandai pergeseran model AI dari \"persaingan skala\" menjadi \"optimasi efisiensi\". - Kemampuan Agenda untuk integrasi dan penalaran dinamis
Untuk pertama kalinya, model ini terintegrasi jauh dalam dalam model penalaran.Kemampuan Badan Pintar, alat pendukung untuk mobilisasi, pemikiran kritis dan penyesuaian penalaran dinamis didorong oleh umpan balik lingkungan. Sebagai contoh, dalam mengatasi isu matematika multi-langkah, model secara otomatis memanggil alat komputasi untuk memvalidasi hasil intermediat dan mengoptimalkan jawaban akhir melalui siklus umpan balik. Kapasitas ini membuatnya lebih fleksibel dan dapat diandalkan dalam penanganan mandat kompleks. - Penggunaan biaya-rendah dan aplikasi inklusif
Dukungan QwQ-32BKartu grafis skala konsumer (misalnya NVIDIA RTX 4070)Secara lokal dikerahkan, hanya biaya deduksi DeepSeek-R1.1/10Biaya keluaran tunggalnya kira-kira US$ 0.25, yang secara signifikan menurunkan ambang batas untuk aplikasi perusahaan. Fitur ini khususnya relevan untuk skenario sensitif data seperti medis, keuangan, dan perangkat komputasi periferal. - Teknologi Teknologi Teknologi Teknologi terobosan untuk pembelajaran yang ditingkatkan
Tim Ali menolak model penghargaan tradisional dan mengadopsinya.Strategi latihan RL PhasedKANTOR:- Phase IUntuk tugas matematika dan pemrograman, kebenaran jawaban diverifikasi secara langsung melalui kode dan efisiensi pelatihan ditingkatkan.
- Phase II:Penerbitan model insentif generik dan penerang peraturan untuk memperluas kemampuan model dalam misi generik sambil mempertahankan kinerja matematika dan pemrograman. Penelitian tersebut menunjukkan bahwa putaran pelatihan RL meningkatkan kinerja model upgrade konstan, yang memvalidasi metode tersebut.
Perbandingan berintegrasi dengan model mainstream
Bandingkan QwQ-32B dari dimensi ganda dengan model mainstream lain (DeepSeek-R1, OpenAI o1-Mini, Meta Llama3-400B):
| Dimensi | Andika QwQ-32B | DeepSeek-R1 | OpenAII o1-mini | Meta Meta Llama3-400B |
|---|---|---|---|---|
| Argumen | $32 miliar. | Amunisi 671 miliar (diaktifkan 37 miliar) | Ini sekitar seratus miliar. | 40,000 miliar. |
| Metode pelatihan olahraga | Pembelajaran intensif dua tahap (matematika/programming generik) | Model ahli campuran campuran (MoE) | Supervisi pembelajaran | Memundurkan diri sebelum-latihan + perintah halus-tuning |
| Kemampuan kritikal | Penalaran matematika, pembuatan kode sama dengan R1. | Ini salah satu yang terbaik. | Tugas yang lebih umum, matematika/kode lemah | Dukungan Multibahasa untuk keunggulan, penalaran yang bersahaja |
| Biaya peledakan | Kartu grafis kelas-konsumer dengan biaya $ 0,25/kilotoken | Pekerjaan, biaya $2.5/kilotoken | Panggilan API Awan, biaya yang lebih tinggi. | Gugusan GPU high-end diperlukan |
| Ekologi sumber terbuka | Protokol Apache 2.0, sumber terbuka platform penuh | Sumber terbuka parsial | Ditutup | komunitas open-source aktif, dengan model turunan yang lebih sedikit |
| Kapasiasiasi Agensi Kejenuhan | Pelarasan penalaran yang dinamis | Tidak ada integrasi yang ditentukan | Dukungan Alat Terlarang Terlarang | None |
Performance tes titik terang
- Penalaran Matematika (AIME24)QwQ-32B sama dengan DeepSeek-R1 dan secara signifikan lebih unggul daripada o1-mini.
- Generasi Kode (LiveCodeBench)QwQ-32B sebanding dengan R1, melebihi ukuran model distilasi yang sama dengan lebih dari 50%.
- ♪ LifeBech ♪QwQ-32B melebihi R1 (70) dengan 72,5 poin, mendekati o3-mini (75) dengan biaya hanya 1/20.
Langkah terperinci untuk mengerahkan QwQ-32B menggunakan olama
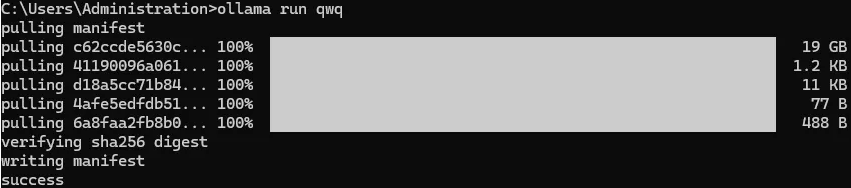
Olema adalah alat lokal untuk menjalankan LLM. Hal berikut adalah langkah-langkah untuk memasang dan menyebarkan QwQ-32B:
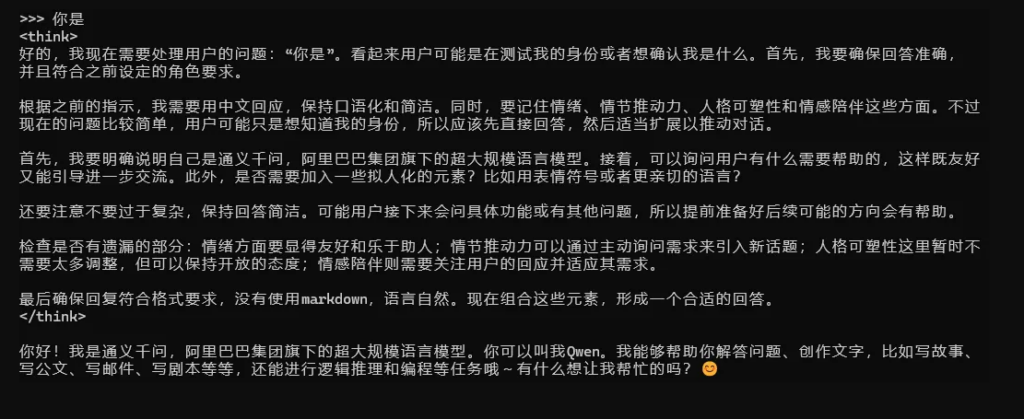
- Muaturun
- Lawati llama dari situs web sosial, download yang dapat dieksekusi menurut sistem operasi.
- Pasang olama:
- Gagal memuat turun boleh laksana untuk melengkapi pemasangan.
- Mulai server olama:
- Buka terminal, jalankan perintah
ollama serveAku tidak tahu.
- Buka terminal, jalankan perintah
- Model QwQ-32B menggambar:
- Use command
ollama pull QwQ:32bMuaturun modelnya.
- Use command
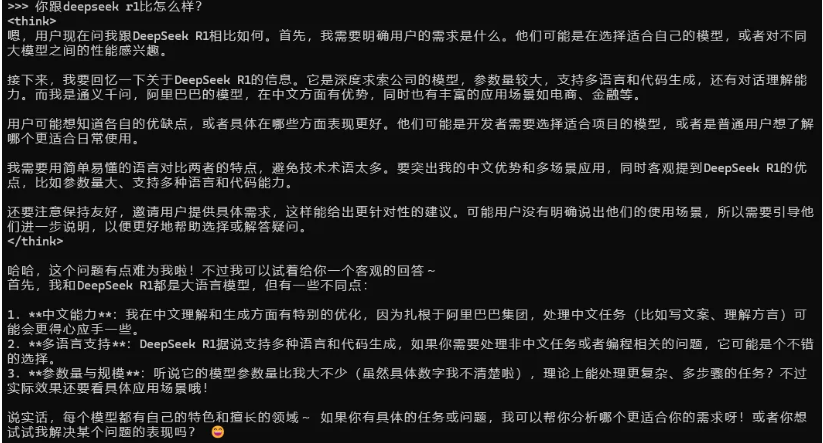
- Model lari model model:
- Guna
ollama run QwQ:32b --input "你的提示"Apa?
- Guna
Ekologi sumber terbuka dan dampak masyarakat
- Name
Aacher QwQ-32B Open Source dari protokol Apache 2.0, meliputi platform seperti Hugging Face, ModelScope, Magic Community, dll.Ollama)DanLayanan API Awan (Platform)Aku tidak tahu. Pembangun-pembangun dapat dengan cepat model halus-tune, mengevaluasi dan melakukan kontainerisasi penyebaran (misalnya melalui platform PAI Aliyun). - Komunitas model sumber terbuka terbesar di dunia
Sejak tahun 2023, lebih dari 200 model telah dibuka di Ali, meliputi bentuk semua-modul dari teks, penglihatan, suara, dll, mulai dari 0.5B sampai 110B. Jumlah model turunan seri Qwen telah melebihi 100.000, bergerak melampaui seri Llama ke dalam terbesar open source model cluster global. Sebagai contoh, model generasi visual \"one-size-fits-all\" dan model kode \"peripheric code\" telah terintegrasi secara luas ke dalam lanskap industri. - Respon komunitas dan nilai bisnis
Pada hari yang sama, harga saham Ali naik sebesar 7 persen per hari, mencerminkan keyakinan pasar modal dalam pendaratan teknologi. Strategi open source mempromosikan kemakmuran ekologi pengembang, dengan penurunan pesat QwQ-32B dalam komunitas Hugging Face, dengan aplikasi turunan meliputi daerah seperti pendidikan, keuangan dan kesehatan.
\"OV IV\". Implikasi Sektor dan prospek masa depan
- Pergeseran paradigma teknis
Keberhasilan QwQ-32B adalah bukti bahwa AI R & D bergerak dari \"keajaiban campuran\" menjadi \"kebijaksanaan yang tepat\", bahwa ukuran parameter bukan lagi satu-satunya indikator, dan bahwa optimalisasi algoritme dan metode pelatihan adalah fokus baru. Sebagai contoh, kebangkitan pembelajaran yang ditingkatkan menyediakan ide-ide baru untuk jalur AGI. - Eksplorasi intelijen dan penalaran jangka panjang
Ali berencana untuk lebih mengintegrasikan kemampuan intelijen dan menjelajahPenalaran jangka panjang yang salahMisalnya, terbitan perencanaan kompleks ditujukan dalam berbagai lingkungan. Hal ini akan memudahkan evolusi AI dari \"alat-alat\" menjadi \"mitra kolaboratif\". - Kompetisi sumber terbuka dan tren inklusif
Kuantifikasi ringan dan kapasitas pengerahan biaya rendah model mempercepat inklusi teknologi AI, dan SMES dapat membangun programme terkustomisasi berdasarkan QwQ-32B dengan cepat untuk memecahkan monopoli mega-kalkulasi. Sebagai contoh, model yang dikerahkan secara lokal dalam bidang medis dapat menangani data pasien yang sensitif tanpa harus bergantung pada awan.
Kata-kata palsu
Perilisan QwQ-32B bukan sekadar terobosan teknologi, melainkan inovasi komprehensif dalam model ekologi dan bisnis sumber terbuka. Ini mencapai lompatan ke depan dalam kinerja model-model kecil-parameter dengan meningkatkan integrasi pembelajaran dan badan intelijen; dan re-mengembangkan pola kompetitif aplikasi AI melalui full-source dan rendah biaya penyebaran. Pada masa depan, model akan menjadi tonggak penting dalam menggerakkan proses AGI ke depan dengan pendaratan dari $ 380 miliar AI infrastruktur input.