
阿里開源QwQ-32B大模型:小參數撬動大性能,訓練成本只有DeepSeek r1的1/10
今天很多人在炒一款“通用智能體”Manus(全球首款通用AI助手),不過我覺得阿里剛開源的QwQ-32B新推理模型,更值得上熱搜。
一、QwQ-32B的核心突破與技術創新
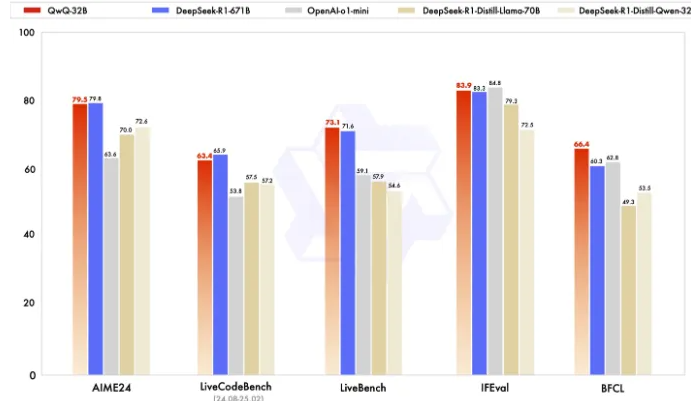
阿里雲於2025年3月6日發佈並開源了新一代推理模型QwQ-32B,其以320億參數的極簡規模,通過強化學習技術實現了與6710億參數的DeepSeek-R1相媲美的性能表現,甚至在某些領域實現超越。以下是其核心亮點:
- 參數效率革命
QwQ-32B的參數量僅爲DeepSeek-R1的1/21,但通過兩階段大規模強化學習(RL)訓練,在數學推理(AIME24評測集)、代碼生成(LiveCodeBench)等任務中表現與後者持平或超越,驗證了“小模型+強化學習”技術路線的可行性。這種設計打破了傳統依賴參數堆疊的路徑,標誌着AI模型從“規模競爭”轉向“效率優化”。 - 智能體(Agent)集成與動態推理能力
該模型首次在推理模型中深度集成智能體能力,支持工具調用、批判性思考及環境反饋驅動的動態推理調整。例如,在解決多步驟數學問題時,模型可自動調用計算工具驗證中間結果,並通過反饋循環優化最終答案。這種能力使其在複雜任務處理中更具靈活性和可靠性。 - 低成本部署與普惠化應用
QwQ-32B支持在消費級顯卡(如NVIDIA RTX 4070)上本地部署,推理成本僅爲DeepSeek-R1的1/10(單次輸出成本約0.25美元),大幅降低了企業應用門檻。這一特性尤其適合醫療、金融等數據敏感場景,以及邊緣計算設備。 - 強化學習的技術突破
阿里團隊摒棄傳統獎勵模型,採用分階段RL訓練策略:- 第一階段:針對數學和編程任務,直接通過代碼執行服務器驗證答案正確性,提升訓練效率。
- 第二階段:引入通用獎勵模型和規則驗證器,擴展模型在通用任務中的能力,同時保持數學和編程性能。研究顯示,RL訓練輪次增加持續提升模型性能,驗證了該方法的有效性。
二、對標主流模型的綜合對比
從多個維度對比QwQ-32B與其他主流模型(DeepSeek-R1、OpenAI o1-mini、Meta Llama3-400B):
| 維度 | QwQ-32B | DeepSeek-R1 | OpenAI o1-mini | Meta Llama3-400B |
|---|---|---|---|---|
| 參數量 | 320億 | 6710億(激活370億) | 推測約千億級 | 4000億 |
| 訓練方法 | 兩階段強化學習(數學/編程→通用) | 混合專家模型(MoE) | 監督學習爲主 | 自迴歸預訓練+指令微調 |
| 關鍵性能 | 數學推理、代碼生成與R1持平 | 綜合性能頂尖 | 通用任務較強,數學/代碼較弱 | 多語言支持優,推理能力中等 |
| 部署成本 | 消費級顯卡,成本$0.25/千token | 需專業算力,成本$2.5/千token | 雲端API調用,成本較高 | 需高端GPU集羣 |
| 開源生態 | Apache 2.0協議,全平臺開源 | 部分開源 | 閉源 | 開源社區活躍,衍生模型較少 |
| Agent能力 | 支持工具調用、動態推理調整 | 無明確集成 | 有限工具支持 | 無 |
性能測試亮點
- 數學推理(AIME24):QwQ-32B與DeepSeek-R1持平,顯著優於o1-mini。
- 代碼生成(LiveCodeBench):QwQ-32B與R1相當,超越同尺寸蒸餾模型50%以上。
- 複雜評測(LiveBench):QwQ-32B以72.5分超越R1(70分),接近o3-mini(75分),但成本僅爲後者1/20。
使用 ollama 安裝部署 QwQ-32B 的詳細步驟
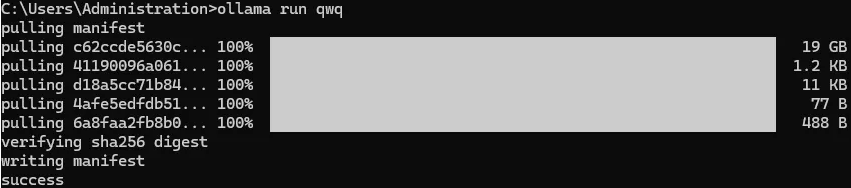
ollama 是一個運行 LLM 的本地工具,以下是安裝和部署 QwQ-32B 的步驟:
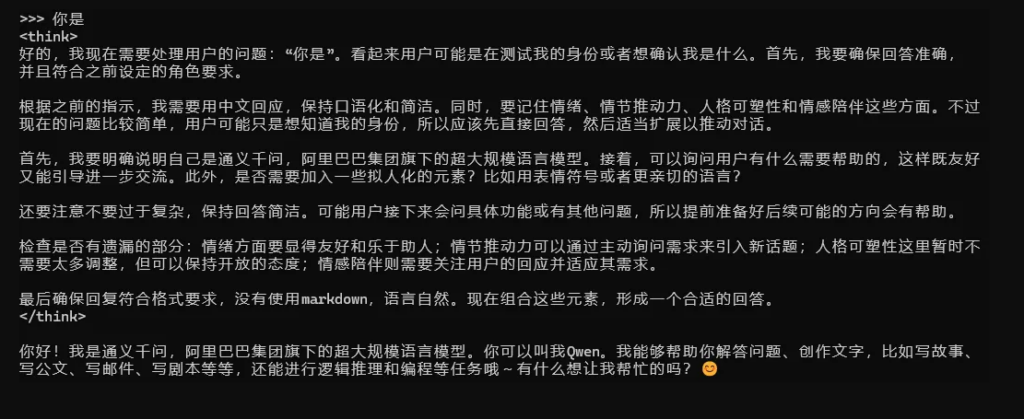
- 下載 ollama:
- 訪問 ollama official website,根據操作系統下載可執行文件。
- 安裝 ollama:
- 運行下載的可執行文件完成安裝。
- 啓動 ollama 服務器:
- 打開終端,運行命令
ollama serve。
- 打開終端,運行命令
- 拉取 QwQ-32B 模型:
- 使用命令
ollama pull QwQ:32b下載模型。
- 使用命令
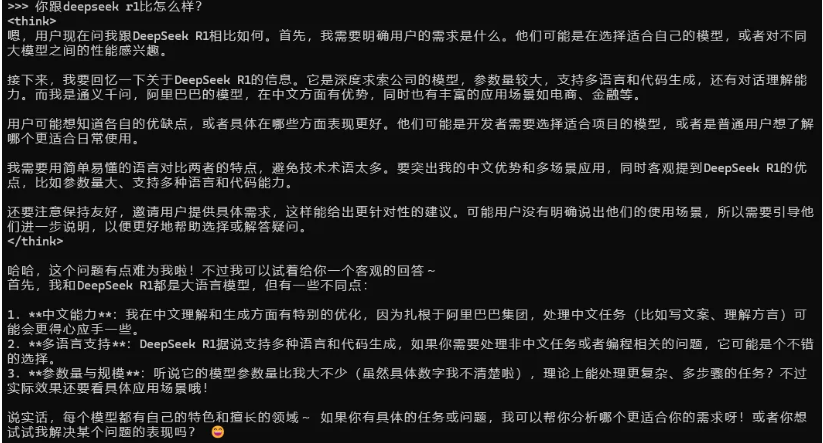
- 運行模型:
- 使用
ollama run QwQ:32b --input "你的提示"與模型交互。
- 使用
三、開源生態與社區影響
- 全棧開源與開發者支持
QwQ-32B以Apache 2.0協議開源,覆蓋Hugging Face、ModelScope、魔搭社區等平臺,配套提供本地部署工具鏈(如Ollama)和雲端API服務(百鍊平臺)。開發者可快速實現模型微調、評測及容器化部署(如通過阿里雲PAI平臺)。 - 全球最大開源模型族羣
自2023年至今,阿里已開源200多款模型,涵蓋文本、視覺、語音等全模態,參數範圍從0.5B到110B。Qwen系列衍生模型數量突破10萬,超越Llama系列成爲全球最大開源模型集羣。例如,視覺生成模型“萬相”與代碼模型“通義靈碼”已廣泛集成至工業場景。 - 社區響應與商業價值
發佈當日,阿里股價單日上漲7%,反映資本市場對技術落地的信心。開源策略推動開發者生態繁榮,Hugging Face社區中QwQ-32B下載量迅速破百萬,衍生應用覆蓋教育、金融、醫療等領域。
四、行業意義與未來展望
- 技術範式轉變
QwQ-32B的成功證明,AI研發正從“大力出奇跡”轉向“精巧出智慧”,參數規模不再是唯一指標,優化算法與訓練方法成爲新焦點。例如,強化學習的復興爲AGI路徑提供了新思路。 - 智能體與長時推理的探索
阿里計劃進一步集成智能體能力,探索長時推理(long-horizon reasoning),例如通過多輪環境交互解決複雜規劃問題。這將推動AI從“工具”向“協作夥伴”演進。 - 開源競爭與普惠化趨勢
模型輕量化與低成本部署能力加速了AI技術普惠化,中小企業可基於QwQ-32B快速構建定製化方案,打破巨頭算力壟斷。例如,醫療領域可本地部署模型處理敏感病歷數據,無需依賴雲端。
五、結語
QwQ-32B的發佈不僅是技術突破,更是一場開源生態與商業模式的綜合革新。其通過強化學習與智能體集成,實現了小參數模型的性能躍升;通過全棧開源與低成本部署,重構了AI應用的競爭格局。未來,隨着阿里3800億元AI基礎設施投入的落地,這一模型或將成爲推動AGI進程的關鍵里程碑。