
安全圈都在談Agentic SOC:CrowdStrike 憑什麼敢讓 AI 做判斷?
最近半年,安全圈的會議圓桌、廠商發佈會、甲方 CISO 的朋友圈,出現頻率最高的詞大概就是 Agentic SOC(代理化安全運營中心)。而真正把這個詞定義成行業敘事的,是 CrowdStrike。問題也隨之而來:SOC 裏讓 AI 自動分流告警、判斷惡意與否,出了錯誰負責?CrowdStrike 憑什麼敢讓 AI 做判斷?
先看清背景:響應窗口從”周”壓縮到”秒”
CrowdStrike 在 Fall 2025 發佈中給出的判斷是:攻擊者正在 AI 化,突破時間(breakout time)已經從小時級縮到分鐘級,分析師的反應窗口被壓縮。SOC 團隊每天淹沒在告警、工單隊列和重複調查中——靠人海戰術排序誤報,已經跑不過機器發起的攻擊。這是 agentic SOC 被提出的一線壓力:不是想讓 AI 替代人,而是人已經處理不完。
第一個底氣:數百萬條專家決策的訓練數據護城河
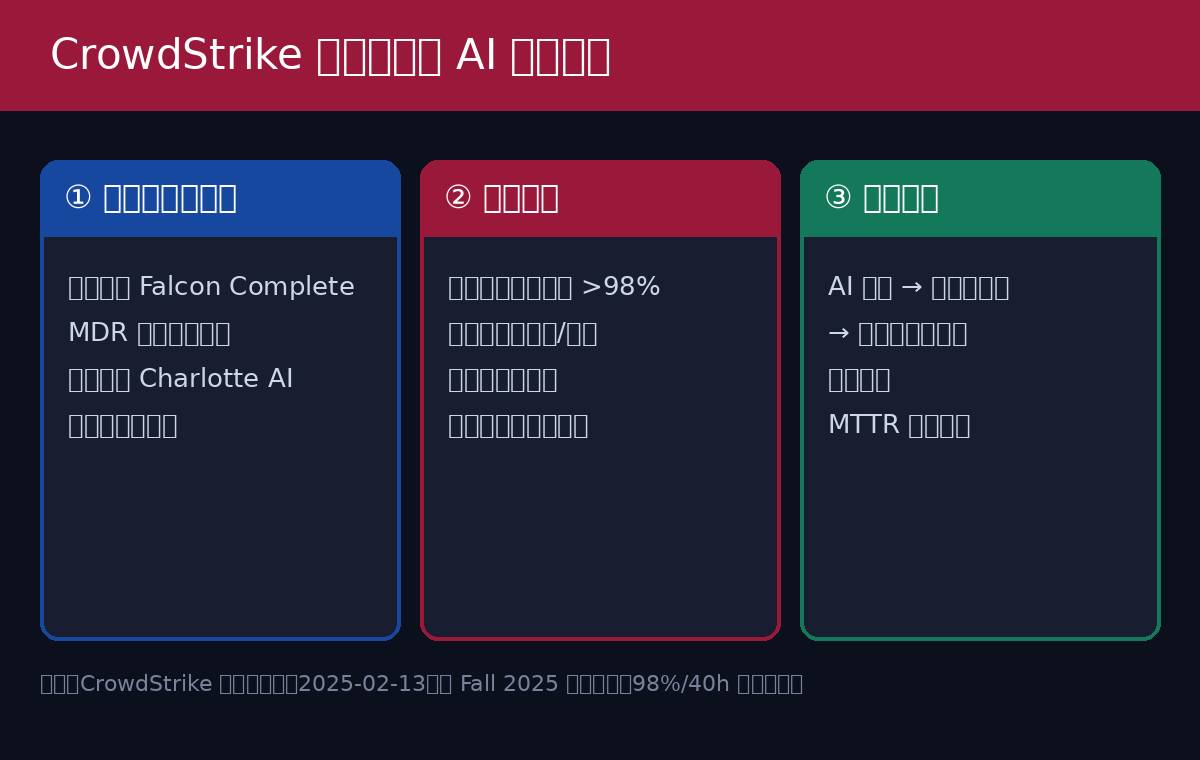
讓 AI 做判斷,最怕的是判斷質量沒有依據。CrowdStrike 給出的答案藏在它最不起眼的資產裏:Falcon Complete Next-Gen MDR 服務。過去十多年,這支”黃金標準”託管檢測與響應團隊在真實客戶環境裏做了數百萬次人工分診決策——每一條都是帶上下文、帶專家標註的對抗樣本。
Charlotte AI 正是用這些數據訓練的,而不是通用互聯網語料。官方在 Detection Triage 新聞稿裏強調:與在寬泛知識庫上訓練的通用模型不同,Charlotte AI 基於專有數據集,判斷依據來自真實對手戰術。換句話說,它敢讓 AI 學着”拍板”,是因爲 AI 學的是一線安全專家多年積累的判斷本身。這就是數據飛輪的第一環:訓練數據來自人類專家,而不是公開文本。
第二個底氣:有界自治(Bounded Autonomy),邊界由客戶劃
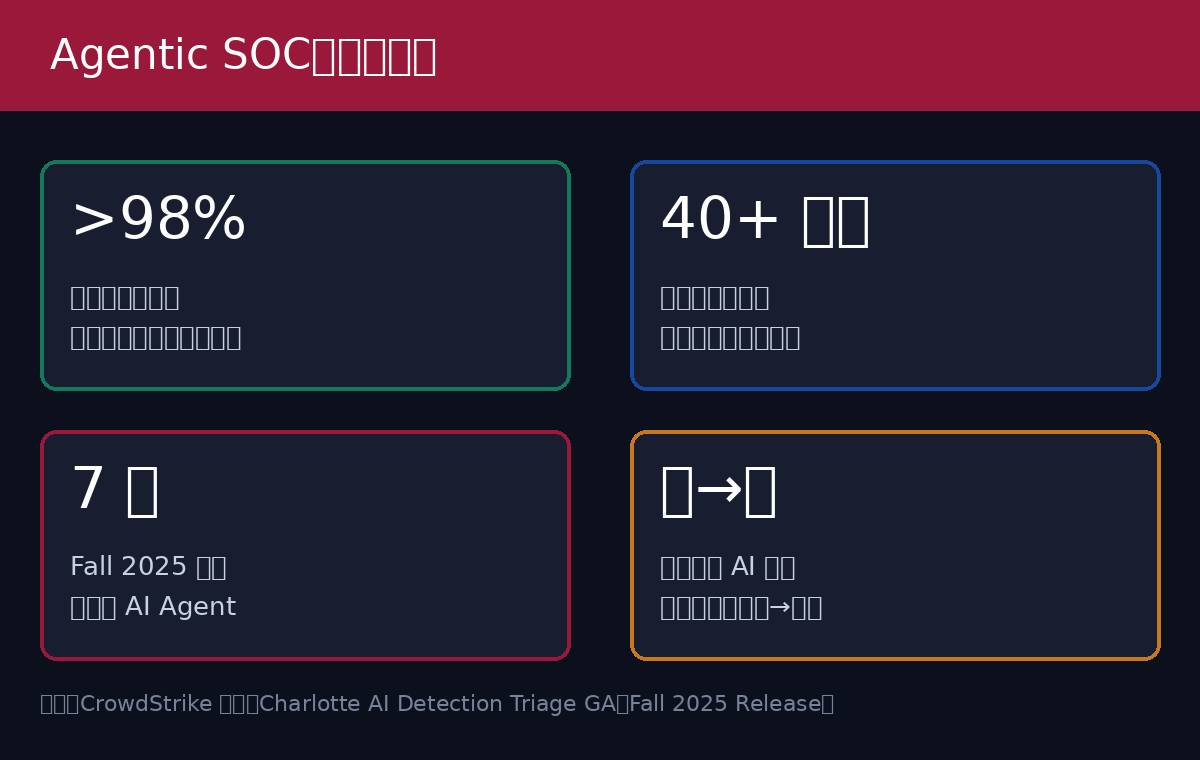
這是整個故事裏最關鍵的工程設計。2025 年 2 月 GA 的 Charlotte AI Detection Triage,官方口徑是:在客戶定義的有界自治模型下運行,檢測分診準確率超過 98%,平均每週爲 SOC 消除 40 小時以上的手工工作。
注意”有界”兩個字:AI 不是拿到一把萬能鑰匙,而是安全團隊自己定義什麼時候、以什麼方式允許自動化動作發生——從分診到最終響應,護欄內置,人類保留完全監督權。CrowdStrike CTO Elia Zaitsev 的說法很直白:讓組織”控制何時以及如何發生自動化動作,保持 AI 可信、可問責、處於人類代理之下”。
這套設計回應了甲方最大的顧慮:不是 AI 行不行,而是出了事能不能兜住。高置信度的低危告警讓 AI 直接關單;涉及處置動作(隔離主機、封禁賬號)則升級給人類審批。AI 做的是”按你劃的線內自主判斷”,不是”無人駕駛”。
第三個底氣:分析師複覈構成閉環,越用越準
有界自治還帶來一個副產品:每一次人類複覈、推翻、修正 AI 的判斷,都會迴流成新的訓練信號,形成官方所說的”閉環反饋流程,持續改進安全結果”。AI 判斷 → 專家校準 → 數據回灌,模型在人機協作中不斷逼近專家水平。這也是爲什麼 CrowdStrike 在 Fall 2025 把分析師的定位從”操作員”抬升爲”編排者(orchestrator)”——人指揮一支會推理、決策、行動的 agent 艦隊,而不是人肉過濾告警。
 數據層與 Agent 軍團:光有判斷還不夠
敢讓 AI 判斷,前提是 AI 看得懂全局。Fall 2025 發佈中,CrowdStrike 同步推出了三塊拼圖:
- Enterprise Graph:統一端點、身份、雲、SaaS、XIoT 和第三方工具遙測的 AI-ready 數據層,官方自稱”行業最豐富的 AI 就緒數據層”,配單一查詢語言,人和 agent 都能即時調用每個信號。
- 七個任務型 Agent:暴露面優先級、惡意軟件分析、威脅狩獵、關聯規則生成、搜索分析、工作流生成、數據轉換——分別對應 SOC 裏最耗人力的七類流程。
- Charlotte AI AgentWorks(2026 年 3 月上線生態):讓安全團隊用自然語言自建、測試、部署專屬 agent,自帶企業級治理;把”造 agent”的能力交給客戶自己。
再疊加 Threat AI(自稱行業首個代理化威脅情報系統)、Agentic MDR(RSA 2026 上發佈,Falcon Complete 分析師親自編排智能體對抗 AI 加速的威脅),以及 AIDR(AI 檢測與響應,反過來保護企業自己用的 AI)——判斷力、數據、編排、治理四層齊備,才構成”敢”的完整邏輯。
冷靜一句:98% 是廠商口徑
值得提醒的是,98% 準確率、每週省 40 小時均爲 CrowdStrike 官方宣稱,基於其內部評估與客戶協作數據,尚未見第三方獨立驗證。安全決策的誤報代價天然不對稱:放過一個真陽性的成本,遠高於多審一個誤報。所以行業當前的共識姿態是:讓 AI 幹”排序、分流、摘要”這類高容錯環節,把”關停、處置、定性”留給有界自治框架內的人類審批。Agentic SOC 不是無人駕駛,而是有安全員盯着的自動駕駛。
一點觀察
CrowdStrike 的”敢”,本質上是十年 MDR 數據積累 + 有界自治工程設計 + 人機閉環的組合拳。它真正賣的不是”AI 會判斷”,而是”AI 按專家的判斷學、在你劃定的邊界內判斷、並且每次判斷都可被人類校準”。對甲方來說,評估 agentic SOC 的清單也可以照這三條來問:訓練數據從哪來?邊界誰定義?閉環怎麼轉?——答不上這三問的”AI 安全運營”,多半隻是聊天機器人換了個皮膚。