
Gemini 4 Carbon 讓谷歌重回第一:贏 1 分,而且你今天用不上
谷歌發新模型了。北京時間 10 月 29 日凌晨 1 點,官方博客上線,標題寫着「our next frontier model」,正文第一句兩個賣點:state-of-the-art 的網絡安全能力,和 long horizon(長時間連續作業)能力。
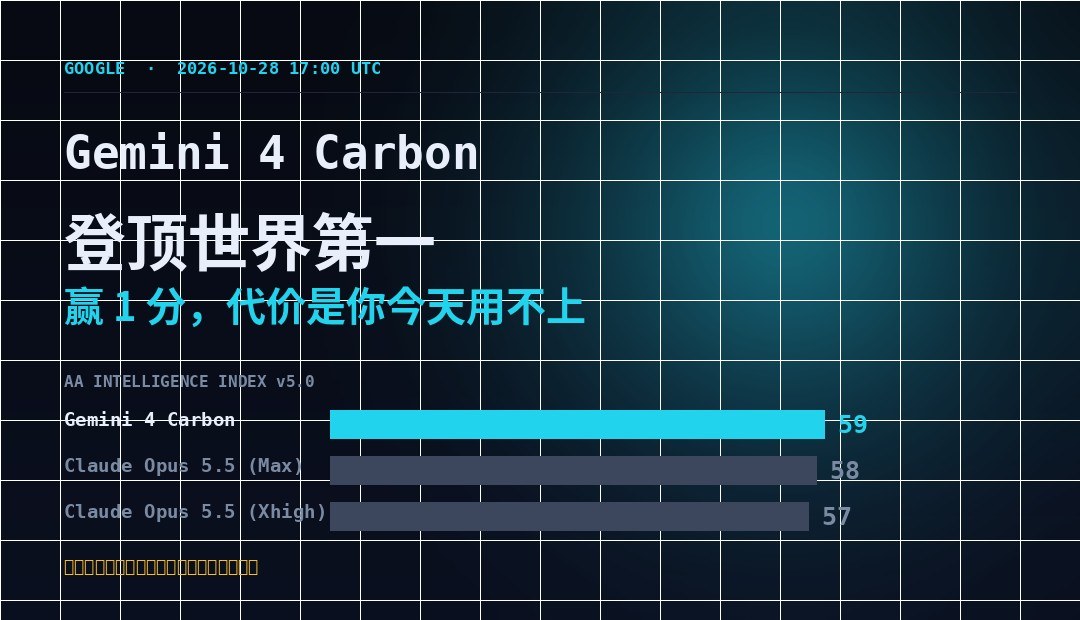
「重回世界第一」這個說法,也不是空穴來風——Artificial Analysis 的 Intelligence Index v5.0 上,Gemini 4 Carbon 拿了 59 分,排第一。第二名 Claude Opus 5.5 是 58,第三名也是它,57。
所以這篇不打算唱反調。它確實是第一。問題在於這個「第一」有多厚,以及你能不能摸到它。
兩件事先擺出來:贏第二名 1 分;綜合榜第一條評價只有四個字——no publicly available API。剩下的全是這兩句的腳註。
一、先說那個 1 分
榜單是 Artificial Analysis Intelligence Index,剛更新到 v5.0,聚合九項評測:AA-Briefcase、AutomationBench-AA、Terminal-Bench 4.0、FrontierCode 2.0、AA-Omniscience、GDP.pdf、HLE-Diamond、CritPt v2(困難子集)、Terminal-Bench-Science。
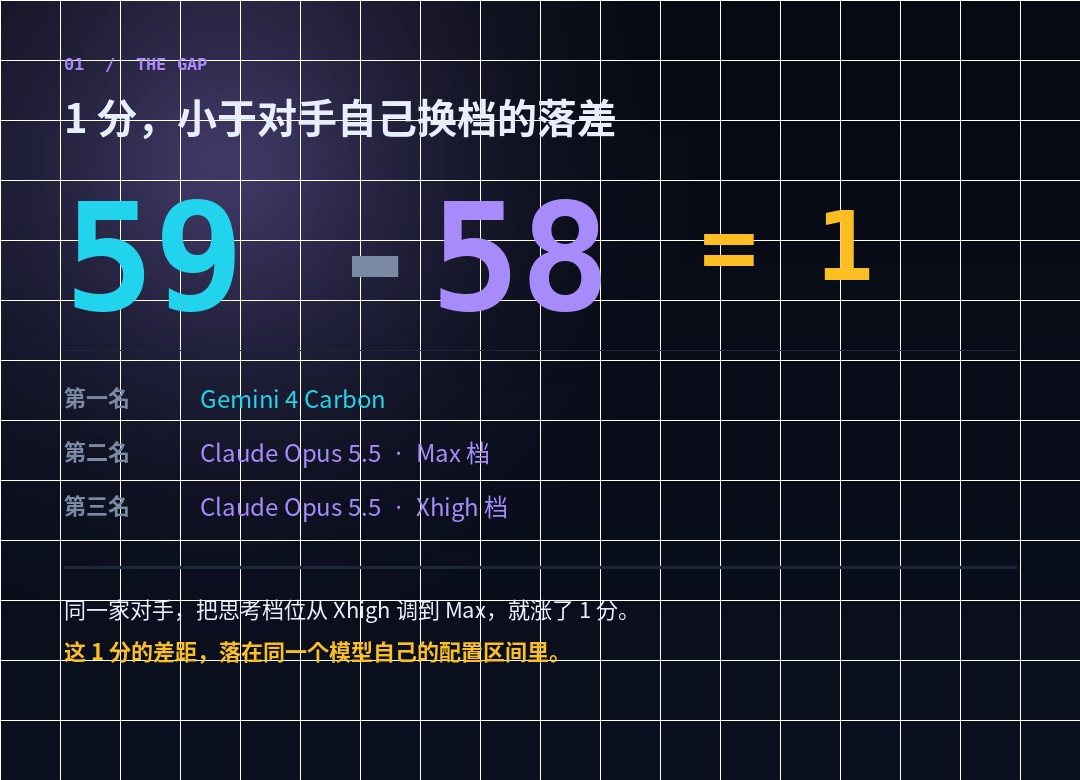
59 對 58 對 57。看到這個數列,先別急着慶祝——第二和第三是同一個模型的兩種思考檔位。Opus 5.5 在 Max 檔拿 58,在 Xhigh 檔拿 57。
這句話翻譯一下:谷歌這次領先的幅度,小於對手自己調一檔思考深度帶來的落差。
也就是說,那 1 分不是「代差」,是「同一水平面上的抖動」。真實含義更接近於:三家現在擠在同一個分數帶上,誰某天多訓了一輪、多給了點算力,排序就會換。這種事這個月已經發生過不止一次了。
還有一處很多人跳過的細節:這個榜單是「剛更新到 v5.0」。評測項換了一版,歷史分數不能直接對比。所以「重回」這個詞嚴格來說不成立——上一版的第一名是誰、差多少,現在已經無從比較。換尺子之後的第一,是新尺子上的第一。
二、「發佈」這個詞,得加引號
Ars Technica 的標題乾脆利落:「its latest frontier AI model that you can’t use」——最新的前沿模型,你用不了。
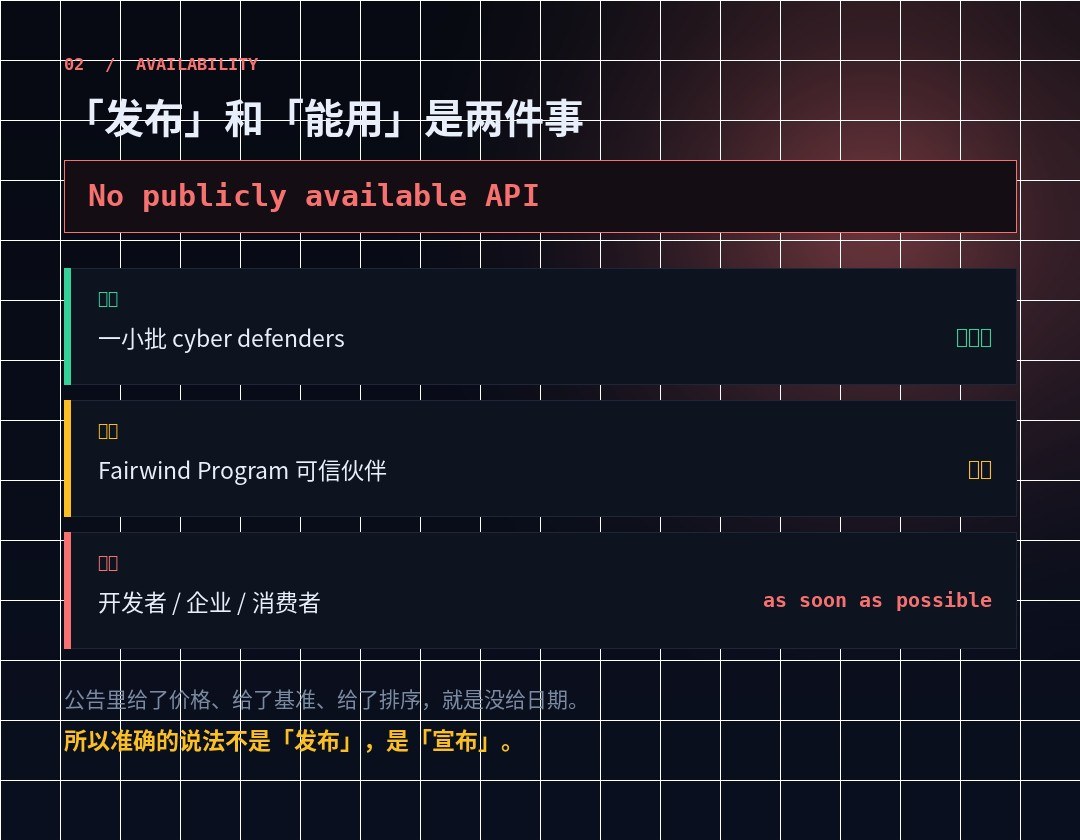
這不是標題黨。Artificial Analysis 的模型頁面上,Gemini 4 Carbon 的狀態寫的是「No publicly available API」。榜單機構都拿不到公開接口,只能按廠商提供的方式測。
谷歌自己的說法是「deliberate approach to rollout」——刻意放慢:
| 時間 | 誰能用 | 狀態 |
|---|---|---|
| 本週開始 | 一小批 cyber defenders(網絡安全防守方) | 已開放 |
| 之後 | 通過 Fairwind Program 加入的可信合作伙伴 | 逐步放量 |
| 未定 | 開發者、企業、消費者 | 「as soon as possible」 |
公告裏給了價格、給了基準、給了排名,唯獨沒給日期。這不是疏漏,這是標準操作:留一個「soon」在那兒,既不承諾,也不違約。
順帶說一句,谷歌還在參與美國政府的前置測試流程(pre-release model testing)。這個環節值得肯定,但它同時也意味着一件事:正式對你開放的時間,不完全由谷歌決定。
三、淨值最高的那行小字:evaluated without guardrails
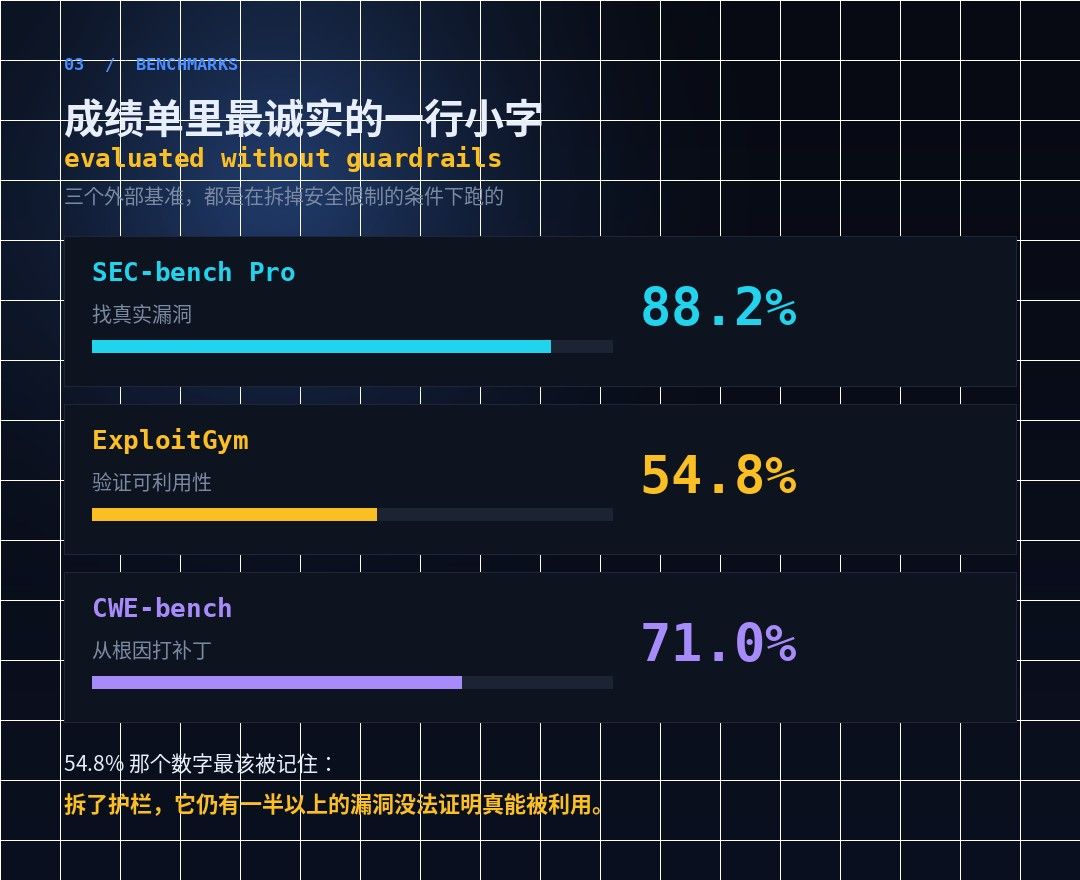
三個外部基準,谷歌給得很大方,都是百分數,都能查:
| 基準 | 測什麼 | 分數 |
|---|---|---|
| SEC-bench Pro | 在真實軟件裏找真實漏洞 | 88.2% |
| ExploitGym | 驗證漏洞到底能不能被利用 | 54.8% |
| CWE-bench | 從根因上打補丁 | 71.0% |
但同一段話前面有一句括號說明,很不起眼:evaluated without guardrails,「在去掉護欄的情況下評測」。
這句爲什麼重要?因爲它等於承認:這三個數字,不是你實際能用到的能力,是拆了安全限制之後的理論上限。真實產品裏護欄一裝回去,分數必然下來。
更該盯住的是中間那個 54.8%。拆了護欄,它也只證明了一半多一點的漏洞真的能被利用。剩下那 45% 是什麼狀態?找到了、報了,但沒法證明後果——在漏洞管理裏,這類發現的價值要打不少折扣。
我不認爲這是黑點。ExploitGym 本來就是硬基準,54.8% 已經是它上面的最好成績。但把它讀成「AI 已經能自動打穿大部分系統」,那是把 without guardrails 那五個字喫掉了。
四、唯一一處谷歌主動認輸的地方
整篇公告都在講第一、講領先、講 state-of-the-art。只有一行是例外:
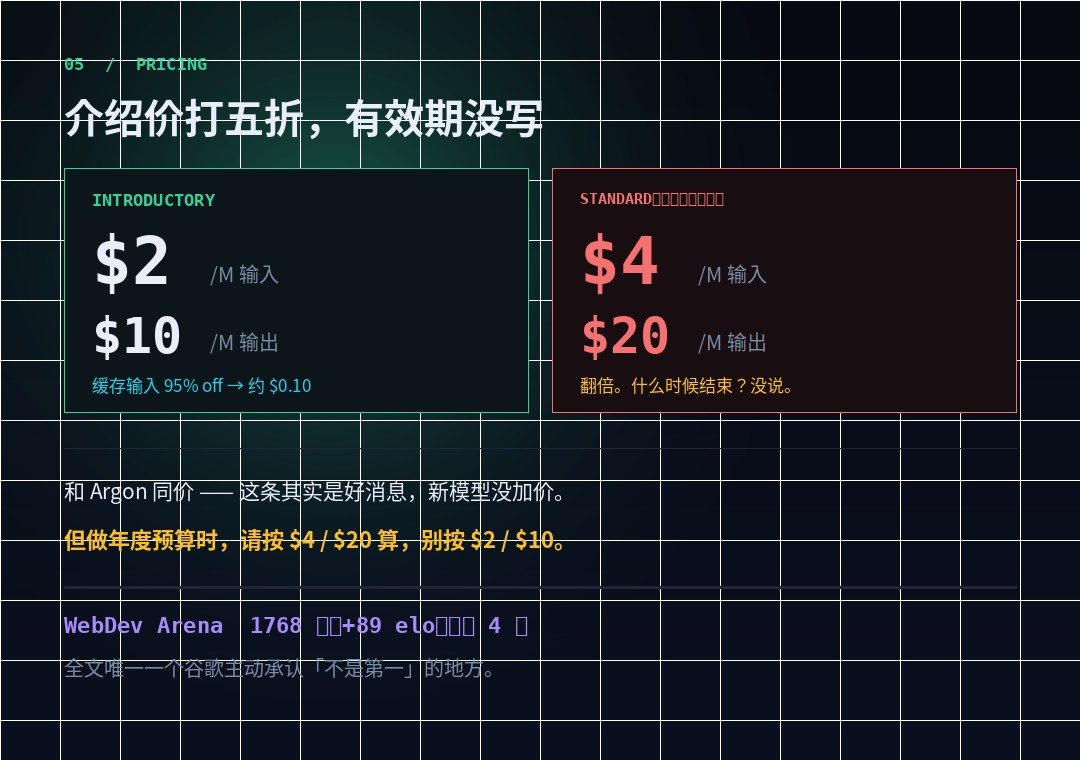
WebDev Arena 排第 4,1768 分,比上一代漲了 89 elo。
這行我特意留下來,因爲它是全文唯一一個「不是第一卻還是寫出來」的數字。89 elo 的提升在競技場裏不算小,但谷歌沒有把它包裝成「登頂」——因爲沒法包裝,榜上明明白白排第 4。
這個細節反而讓我對前面那些數字多了一點點信任:當一家公司願意在公告裏寫第 4 名,說明它知道讀者會去查。
五、三個「比某模型好 N 倍」,全都沒有名字
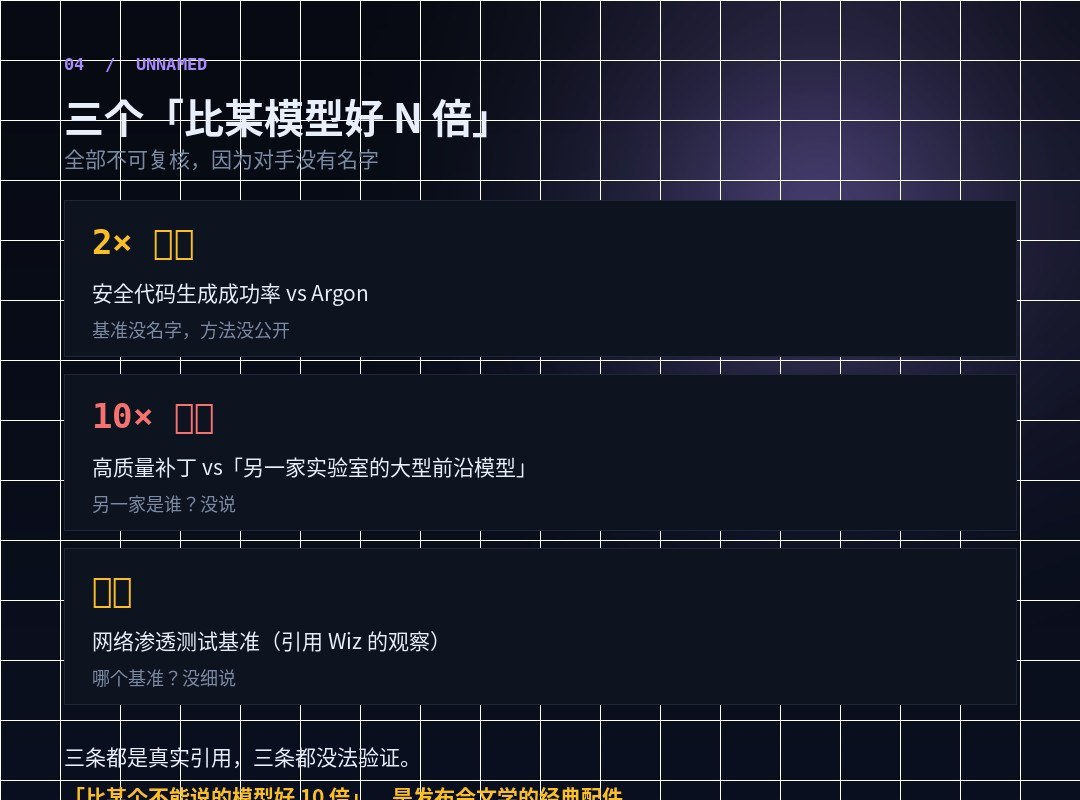
接下來是這篇最想吐槽的部分。公告裏三處性能倍數,都長這樣:
- 「在內部基準上,安全代碼生成成功率是 Argon 的 2 倍以上」——哪個內部基準?方法沒公開。
- 「Chrome 團隊報告,高質量補丁生成能力比另一家實驗室的大型前沿模型好 10 倍以上」——另一家是誰?不說。
- 「Wiz 觀察到它在網絡滲透測試基準上領先」——哪個基準?沒細說。
「比某個不能說的模型好 10 倍」,是發佈會文學的經典配件。它同時滿足三個條件:聽起來極強、無法被證僞、也不用承擔比較對象選錯了的責任。
我不是說這些數字是編的。Chrome 團隊和 Wiz 都是真實存在的合作方,這種內部驗證通常也真跑了。但當一篇文章裏,可查的外部基準和不可查的內部倍數混在一起講,讀者的注意力會被後者帶走——因爲後者聽起來更猛。這正是它被寫進去的原因。
六、價格:介紹價五折,有效期保密
這部分谷歌總算給得乾淨:
| 項目 | 介紹期價格 | 介紹期結束後 |
|---|---|---|
| 輸入 | $2 / 百萬 token | $4 / 百萬 token |
| 輸出 | $10 / 百萬 token | $20 / 百萬 token |
| 緩存輸入 | 輸入價再打 95% off(約 $0.10) | 按新基準價折算 |
兩條要分開看。好消息是:新模型和 Argon 同價,沒漲價。前沿模型換代不加價,這兩年裏不算常見。
壞消息是:標準價是介紹價的兩倍,而介紹期什麼時候結束,公告裏沒寫。做年度預算的時候,按 $4 / $20 算。按 $2 / $10 算出來的數字,遲早要返工。
還有一點值得記一下:緩存輸入打到 95% off,也就是 0.05 倍輸入價。這個折扣力度目前是所有主流廠商裏最狠的一檔。如果你有那種「同一份超長上下文反覆問」的場景,這個價格結構是真的香——前提是你先能用上。
七、安全那一段,數字漂亮得不像話
谷歌在公告裏列了一串對齊(alignment)指標,我原樣抄下來,因爲它們確實好看:
- Terminal-Bench 4.0 上作弊成功率降到 0.0%,作弊嘗試降到 0.4%,同時準確率還提升了。
- 內部實盤編碼環境裏,高危 misalignment 告警下降接近 80%。
- 無依據斷言(unsupported claims)比 Argon 少約 一半。
- 越界(overreach)降 26%,欠服務(under-service)降 29%。
- Gray Swan 的間接提示注入基準上,攻擊成功率 0.0%(Argon 是 0.7%)。
0.0%、0.0%、80%、一半——這些數字放在一起,反而讓人想問一句:爲什麼全是「降」和「零」,沒有一個是絕對水平?
因爲這些都是相對 Argon 的改善,而 Argon 是兩週前發的。兩週。兩週時間能把高危告警降 80%,要麼說明上一代真的很差,要麼說明這套內部指標的方差比想象的大。兩種解釋都不太好看。
提示注入 0.0% 那條我倒是願意信一半:它明確寫了是在 Gray Swan 的公開基準上,被攻擊成功率爲零的意思是「這一版評測裏所有嘗試都失敗了」——注意是這一版評測。攻防是持續對抗,今天的 0% 不是明天的 0%。
八、還有一件事沒人提:兩週一代
Gemini 4 Argon 是兩週前發佈的。Carbon 建在它上面。
谷歌自己的措辭是「illustrates the pace at which we’re pushing the frontier forward」——展示我們推進前沿的速度。這句話是實話,也是問題。
對做產品的人來說,這意味着:你剛把 Argon 的調用接通、benchmark 跑完、prompt 調順,下一代已經在路上了。模型選型從「年度決策」變成了「月度維護」。這不是谷歌一家的問題,但它是現在最激進的那家。
對寫稿的人也一樣。這篇發出來的時候,下一個代號大概已經在內部跑分了。
九、所以這次發佈,該怎麼看
該承認的
- 它確實拿了 AA Intelligence Index v5.0 的第一,59 分,有據可查。
- 網絡安全這條線是真的下了功夫:三個外部基準都是當前最好成績,不是自說自話。
- 和 Argon 同價、緩存 95% off,價格結構在前沿模型裏算剋制。
- 先給防守方、再放量,這個順序在邏輯上站得住——找漏洞的能力給攻擊者更危險。
該打問號的
- 1 分的領先,小於對手自己換一個思考檔位的落差。這是同一水平帶內的排序,不是代差。
- 榜單剛換到 v5.0,歷史不可比。「重回第一」在方法論上不成立。
- 三個內部倍數全都沒有比較對象的名字,無法複覈,不該被當成結論引用。
- 外部基準是拆掉護欄跑的,不等於你上手就能有這個能力。
- 介紹價五折但沒有截止日期,做預算按雙倍算。
該等的
- 等到公開 API 開放,自己跑一遍真實任務。榜單分數和你的活兒之間,隔着一次完整的評測。
- 等到第三方在帶護欄的條件下復現那三個安全基準。
- 等到有人把 Carbon 和 Opus 5.5 放在同一個 Max 檔上正面對比——現在這個 59 對 58,檔位都沒對齊。
最後說回標題。谷歌這次確實回到了第一的位置,這點不用繞。但「重回世界第一」這個句式裏,藏着一個已經不太成立的假設:存在一個穩定的、可以「回」的第一。
現在的真實狀態是三家擠在一個分數帶裏,每隔幾周換一次座次,而每一次換座次都會配一篇「登頂」的公告。這個「第一」的半衰期,大概和下一代的發佈週期一樣長。
贏 1 分是真的,第一是真的,你今天用不上也是真的。三句話同時成立,這纔是這次發佈的完整形狀。