
Gemini 4 Argon Release: 1M output token, halve prijs plaat Opus, maar je kunt het niet gebruiken voor een tijdje
Op 30 september, Google DeepMind officieel vrijgegeven Gemini 4 Argon, de officiële locatie van de volgende generatie van de grens intelligentie. Dit is het eerste model van de Gemini 4-serie en het eerste vlaggenschip gelanceerd zeven maanden na Gemini 3.1 Pro in februari van dit jaar. In het midden van de periode, Google stuurde slechts een paar kleine modellen van de Flash-serie, die werden ooit gezien door de buitenwereld als vallen uit een front-line model competitie. Argon reageerde, het deed niet voor iedereen de deur open.
Ten eerste kun je het nu niet gebruiken.
Op de dag van de lancering werd Argon alleen geopend voor "geloofwaardige cyberverdedigingen" in het Google Fairwind project. Het plan is op 2 september van start gegaan en is gericht op overheden en nationale netwerkinstellingen, belangrijke infrastructuurbeheerders zoals medische/telecommunicatie/energie/financiering, kerntechnologieplatforms en academische laboratoria die defensieve benchmarkingtests uitvoeren. Aanvragers moeten een controle ondergaan, multifactoriële visbestendige certificering gebruiken en mogen geen toegang delen of doorverkopen. Officieel zijn er momenteel meer dan 650 samenwerkende agentschappen.
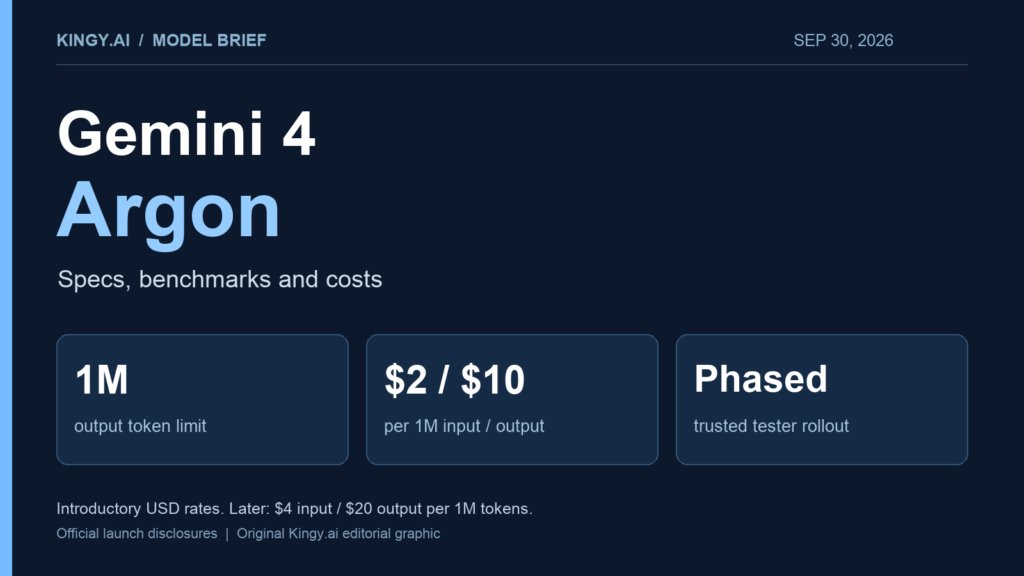
API klanten en Google AI Ultra abonnees, vervolgens ontwikkelaars, bedrijven en gewone consumenten, officieel genoemd "zo snel mogelijk," maarGeen datum opgegeven.Ik weet het niet. Wat belangrijker is, is dat we voorzichtig moeten zijn.API model ID is nog niet gepubliceerdEr zijn geen modelkaarten en geen data om kennis af te sluiten. Dus je ziet een prijs als "$2 input" die alleen kan worden begrepen als een officieel gepubliceerde potentiële commerciële prijsstelling, wat niet betekent dat het vandaag kan worden genoemd.
Tussen haakjes, dit komt overeen met OpenAI, Antropic - OpenAI's Daybreak, Anthropic's Project Glasswing, allemaal het opsluiten van de sterkste cyber security mogelijkheden in de gecontroleerde passage. Google heeft ook deelgenomen aan het proces van vrijwillige toetsing door de regering van de Verenigde Staten voorafgaand aan de release van het front-line model.
1M uitvoer token: deze inzet is lang
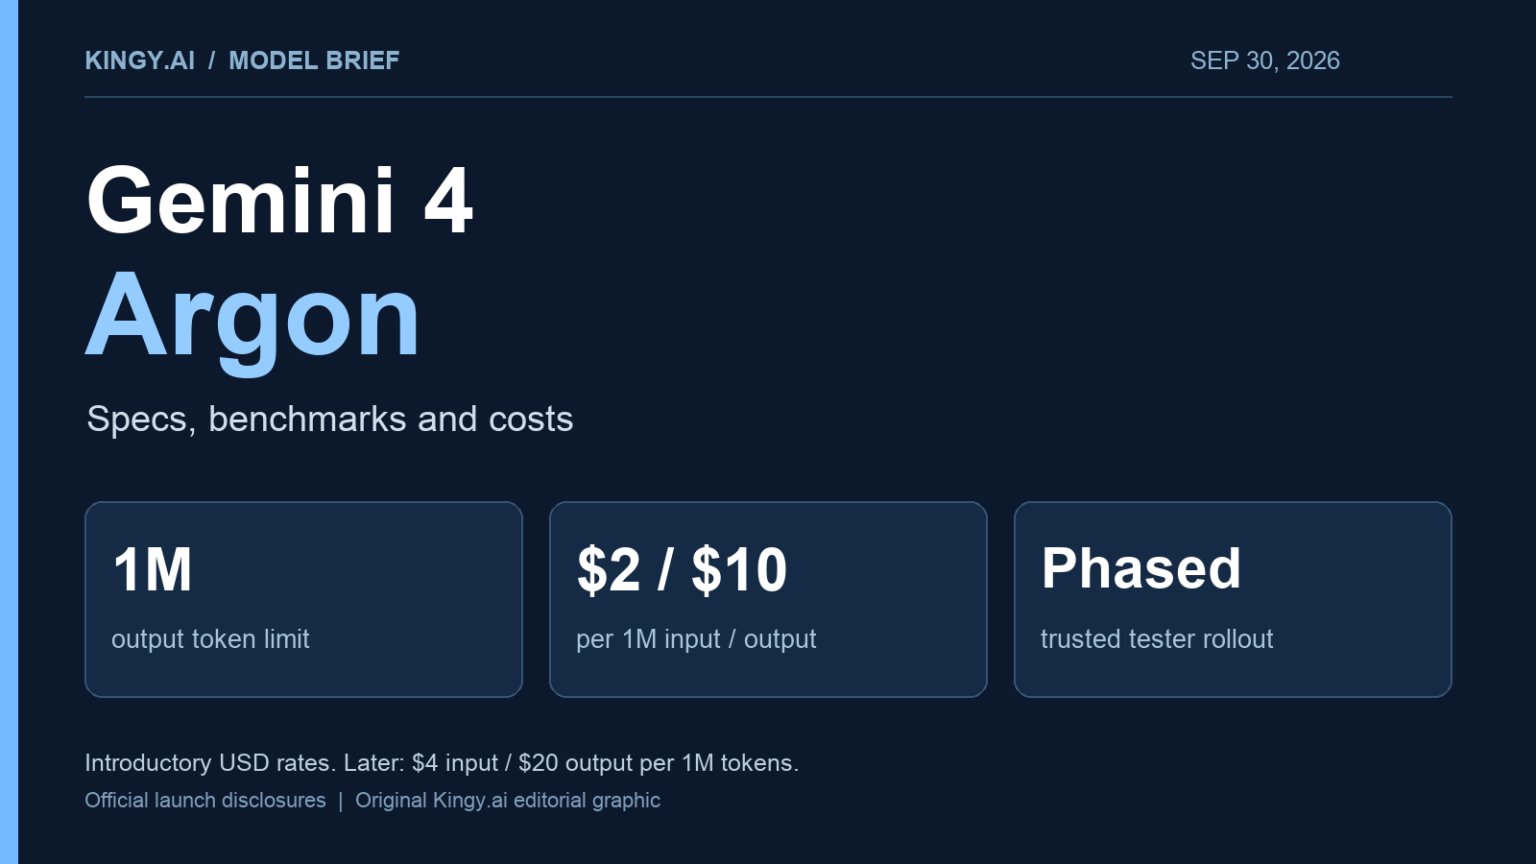
Argon, de moeilijkste technische indicator is niet context, maar context.Outputlimiet vermeld van 64K 1M tokenEn Google zegt dat het toonaangevend is in de industrie. Attentie, uitgang, geen invoer.
Dit verschil is belangrijk voor de persoon die agent deed. In het verleden was je bezorgd over hoeveel kan gelezen worden en nu over hoe lang kan het duren? Een grootschalige code migratie missie kan herhaalde lezing van het magazijn, veranderingen, lopende tests, lezer output, herprogrammering en nieuwe fouten vereisen. Wanneer het output budget groot is, hoeft het model niet te stoppen met vroeg en retour controle. Google zegt dat wanneer er ruimte is voor modellen om diep na te denken en honderdduizenden tokens te genereren een stap in een vergadering over de mogelijkheid om een probleem op te lossen.
Maar zie het niet als een wondermiddel. Het hoge plafond betekent niet dat het herinnert eerdere details, selecteert de juiste gereedschappen, patches zijn goed en snelheid is sneller. Deze hangen af van de context van de input, het Agent framework, de taak zelf en de authenticatie link. Met een hoog plafond kun je een fortuin verbranden voor een mislukte poging.Met 1M als standaard budget voor elke aanvraag is het tarief niet goed.Het is het taakniveau, de registratie van de werkelijke consumptie en de tijdige stopzetting van schade aan pogingen zonder meetbare vooruitgang die worden gebruikt.
Win breed, niet allemaal.
Google publiceerde vergelijkende tabellen met GPT-6 Astra, Claude Fable 5.1 en Claude Opus 5.5. Geïntegreerde mediastatistieken: van de 18 benchmarks die bekend werden gemaakt, was Argon de eerste van één 12 en was de eerste; Astra was de eerste 3 en Opus 5.5 was de eerste 2. Met andere woorden,De top van de drie front-line modellen, Argon, maar het spel is nog steeds aan.Ik weet het niet.
Loodplaatsen:
- DeepSWE v1.177,9 procent (echte software voor de lange cyclus) hoger dan 74,2% voor Opus 5,5 en 74,1% voor Astra
- Vals Index(Financial/programming/legal/tax economic impact, gemeten naar BBP-gewichten in de Verenigde Staten)
- AutomationBech51,3%, eerst 8,8 punten hoger dan Opus
- Benchmark Harvey Law Age19,6 procent, terwijl Astra slechts 5,4%, Opus 5,5 slechts 3,8 procent een overdrijvingspercentage, maar opmerkend dat de absolute waarde nog steeds minder dan 20% is een substantiële stijging van de zeer lage basis kan gemakkelijk meer zeker dan het is.
- LVBnch91,7%, SOTA
- CWE-bench v168% (voorzieningen gerepareerd), eerst met Astra
Waar het achteruit is, is het hetzelfde:
- FrontiersWE v2Astra 65,5 procent vs Argon 55,0 procent, 10,5 punten
- Terminal-Bench Science 0.1Astra 68,1% vs Argon 57,6%, zelfde 10,5 punten
- Terminal-bench 4.066,4% vs Argon 57,4%, 9 punten
- PostTrainBench: Obus 49,3% vs Argon 45,3%
Daarom is het kiezen van wie nog steeds afhankelijk is van wat je doet. DeepSWE's lead betekent niet dat FrontiersWE aan de leiding is, met twee sets gebenchmarkte magazijnen, missielengtes, taal, gereedschapsgedrag.Als uw lading meer als FrontiersWE of terminal-intensieve taken is, is er geen reden om Astra en Opus uit de kandidaten te verplaatsen.
De derde partij, Artificial Analysis, geeft Inteligence Index 53 punten, die hetzelfde is als GPT-6 Astra en ligt achter Claude Opus 5.5 en Sonet 5.5; in tegenstelling, Gemini 3.1 Pro is 30. Fello AI zei ook dat het in het hoofd model getest door kunstmatige analyse.De laagste hallucinatie.Ja. Tegelijkertijd meldde Bloomberg dat sommige medewerkers van Google voelden dat ze nog steeds worstelen met echte programmering.
Google gebruikt het al zwaar
Er zijn verschillende interne gevallen genoemd, het meest informatieve deel van de tekst, aangezien het gaat om de landing van de werkelijke productieomgeving in plaats van laboratoriumruns:
- KwantumalgoritmeoptimalisatieKwantumcalculatorteams helpen tijd- en ruimtebronnen (qubit x gate) te optimaliseren voor kritische toepassingen, waarbij één geval de gepubliceerde baseline in minuten overschrijdt 40%
- Geheugenefficiëntie: een groep Argon Agent analyseert de gehele vloot profilering telemetrie, identificeert en past automatisch geheugenoptimalisatie toe, geeft meer dan 300 TiB RAM vrij na verspreiding, en verwacht totale besparingen van 500 Tib tot 1 PiB
- C/C++ Draai Rust: Van de tienduizenden lijnen in kernbibliotheken zoals re2, libgav1 tot meer dan 800.000 lijnen in de Fuchsia OS Zircon innerlijke kern. Deze systemen zijn zo kritisch dat grootschalige herschrijven een strikte geautomatiseerde benadering van handmatige auditing, simulatie testen en evaluatie voor productie vereist.
De meest specifieke is libgav1-Google Open Source Video decoder. Argon Agent neemt een bestaande Rust-poort over, die wordt geëxporteerd via meerdere rondes van profielgestuurde experimenten en onderzoekscompilers.Vervangen 32K-lijn SILD-code, kan de uitvoer compiler automatisch de beveiliging van Rust kwantificeren. Het resultaat is een veilige geheugen decor, in vergelijking met de originele Rust poort versieKom op, 2,7 keer.De video-uitvoer is precies hetzelfde.
Cybersecurity: Argon's tweede belangrijkste slagveld
Argon is getraind voor cyberbeveiliging.Zelf-detecteren, valideren en repareren belangrijke software omissies HoleIk weet het niet. Voor een geloofwaardig defensief en Google intern team, zal GoogleDoe het hek af.Stuur het en geef ze alle voorwaartse verdedigingsmogelijkheden.
Ontdekt prestaties: Wiz via zijn Scan voor Goed plan om kritieke openbare infrastructuur gratis te beschermen met Argon, gemodelleerd opDe medische software die werd gebruikt in het Global Hospital vond een ernstige maas die gevoelige persoonlijke informatie blootlegde, en geen van de vorige front-line modellen vond het.Ik weet het niet. Daarnaast vond Argon blootstellingen in een complexe code repository met 20 programmeertalen op een samengestelde gap benchmark binnen Google; en in Wiz op een zwarte doos penetratie test benchmark, het overtrof Gemini 3.8 Flash Cyber op de ontdekking van aanval oppervlakken, het identificeren van mazen, en het produceren van PoC bewijs.
De eerste levering van het Fairwind project was Gemini 3.8 Flash Cyber met de CodeMender framework, die hielp de verdediging te identificeren, valideren en herstellen van de mazen.
Prijzen: Halve prijs begint, dan dubbele
De introductieprijs is ...Token 2 dollar per miljoen, output 10 dollar95% korting op input prijs voor cache input, dat is ongeveer $0,10 miljoen cache-invoerIk weet het niet. Verhoging tot het einde van de introductieperiode US$ 4 input / US$ 20 output, de cache input is ongeveer $0.20. Google zegt niet hoe lang deze
Zet het in dezelfde prijslijst: Argon in de introductieperiode is GPT-6 Astra ($10/50).Een vijfde.Claude Opus 5.5.De helft.Ik weet het niet. Deze prijs Google twee verschillende verhalen... De promotieperiode is een van de goedkoopste hoofdmodellen, en de promotie eindigt op dezelfde prijs als Opus 5.5.
Beveiligingspoort voor de vrijlating.
Google heeft veiligheidsmaatregelen in vier richtingen toegevoegd:
- Preventie van misbruikOntworpen om schadelijke netwerken en CBRN-verzoeken af te wijzen met behoud van legitiem onderzoek voor tweeërlei gebruik; verbeterde technologie voor interne activering van surveillancemodellen om misbruik te identificeren. Het hek werd getest met een handmatige + automatische aanvalsmethode door interne en externe rode teams.
- VoorzorgsinjectieGoogle beschrijft Argon als "het meest veerkrachtige model tot nu toe om indirecte tips te injecteren." Gray Swan's IPI benchmark succespercentage 0.7%Vergeleken met 1,0% voor Opus 5.5 en Fable 5.1, 8,5% voor GPT-6 Astra, 27,0% voor GPT-6 Sol, 5,3 31,5% voor GLM, en tot 51,8% voor Grok 4.8 - Het is nogal een gat.
- Controleer de afwijking.: Monitor de gedachteketen en acties van Argon en onderbreek de uitvoering indien nodig. Google gebruikte een soortgelijk systeem tijdens het trainingsproces om gespecialiseerde noodresponsteams te waarschuwen en bewust te voorkomen dat omgeleide detecties de redenering vormen die surveillance zou omzeilen.
- Versterkingssysteem: Segregatie en opslag van zandbakomgeving vóór het begin van een hoogrisicotraining of -beoordeling, zoals aangegeven in de routekaart Agent Control
Het artikel "Intensively failing to feed surveillance bevindingen terug naar training" is een van de mooiste woorden van het bulletin: Het wijst op een reëel probleem: als je modellen met surveillance resultaten traint, kunnen modellen leren hoe niet worden gedetecteerd door surveillance te worden in plaats van te worden verspreid.
Hoe zit het met deze release?
Voor bedrijven is het punt van deze release niet om een andere chatrobot te zijn, maar om Google, na enkele maanden van druk van OpenAI en Antropic, opnieuw te bewijzen dat hij nog steeds aan de voortafel zit. Het is gekozen voor drie druppels -- softwareontwikkeling, professionele expertise, netwerkbeveiliging. Dat is precies waar bedrijven al geld uitgeven.
Maar het hoeft niet een "win-win" om het patroon van de concurrentie te veranderen.In 18, de lead of 13 parallellen zijn genoeg om Google te pleiten voor de "verbreding lead"En degenen die het achterloopt achter de FrontiersWE v2, Terminal-Bench Science, Terminal-Bench 4.0 herinnert u er ook aan dat OpenAI en Antropic nog steeds duidelijke technische gebieden hebben.
De praktische conclusie is slechts één zin:Het model is nog steeds afhankelijk van uw werklast.Neem je echte baan mee naar de piloot, en neem geen mooie ruzie. De echte watershed is wanneer Argon is open voor ontwikkelaars, bedrijven en consumenten
Er is geen einde aan de voorkant, alleen de volgende ronde.