
Gemini 4 Argon 發佈:1M 輸出 token、半價叫板 Opus,但你暫時用不了
9月30日,Google DeepMind 正式發佈 Gemini 4 Argon,官方定位是”下一代前沿智能”。這是 Gemini 4 系列的第一個模型,也是 Google 自今年 2 月 Gemini 3.1 Pro 之後,時隔七個月推出的第一款旗艦。中間這段時間 Google 只發了幾個 Flash 系列的小模型,一度被外界認爲在前沿模型競賽裏掉了隊。Argon 就是回應——但它沒有對所有人大開大門。
先說最重要的一件事:你現在用不了
Argon 發佈當天,只面向 Google Fairwind 計劃裏的”可信網絡防禦者”開放。這個計劃 9 月 2 日啓動,面向各國政府與國家級網絡機構、醫療/電信/能源/金融等關鍵基礎設施運營方、核心技術平臺,以及做防禦性基準測試的學術實驗室。申請方需要經過審查、必須使用抗釣魚的多因素認證,且不得分享或轉售訪問權限。官方稱目前有超過 650 家合作機構。
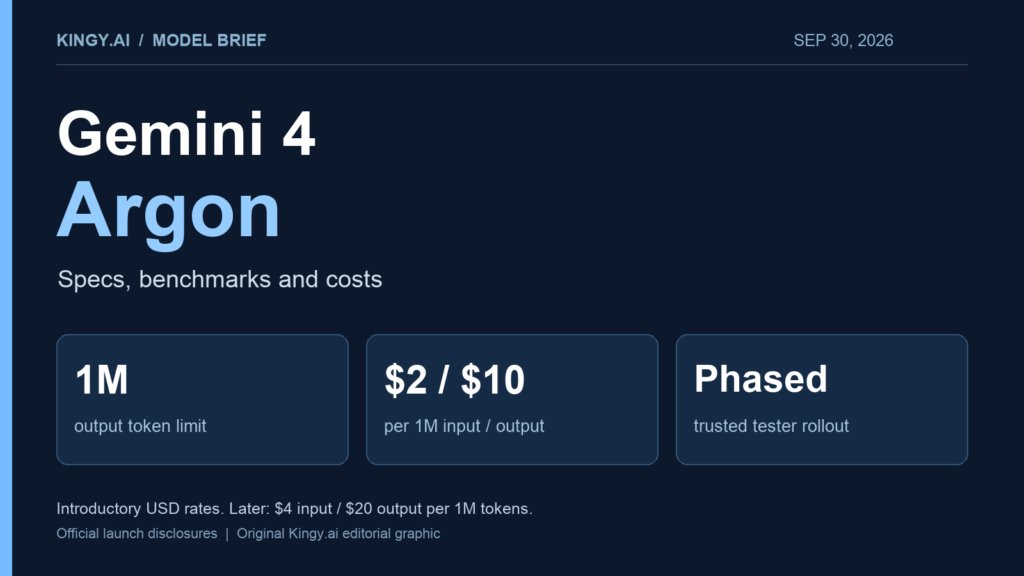
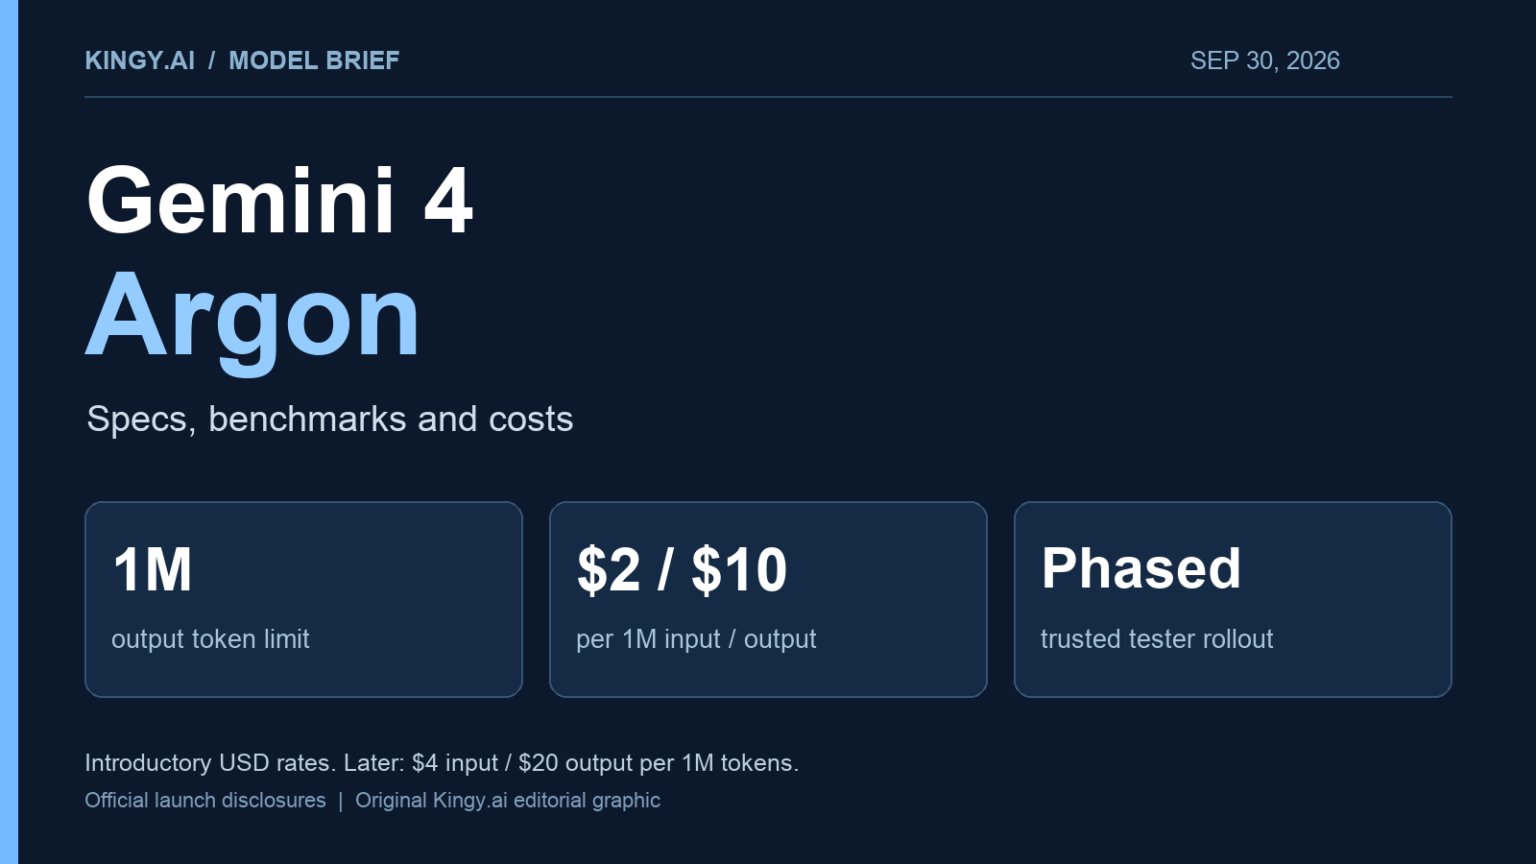
接下來才輪到付費 API 客戶和 Google AI Ultra 訂閱用戶,然後是開發者、企業和普通消費者,官方說法是”儘快”,但沒給具體日期。更關鍵的是,API 模型 ID 至今沒有公佈,也沒有模型卡和知識截止日期。所以你看到”$2 輸入”這種價格,只能理解爲官方公佈的預期商業定價,不代表今天就能調用。
順帶一提,這也跟 OpenAI、Anthropic 的做法一致——OpenAI 的 Daybreak、Anthropic 的 Project Glasswing,都是把最強的網絡安全能力先關在受控通道里。Google 還參加了美國政府的前沿模型發佈前自願審查流程。
1M 輸出 token:這次賭的是”長”
Argon 最硬的技術指標不是上下文,而是輸出上限從 64K 提到了 1M token,Google 說這是業界領先。注意,是輸出,不是輸入。
這個區別對做 Agent 的人很重要。以往大家關心”能讀多少”,現在關心的是”一次能持續幹多久”。一個大型代碼遷移任務,可能要反覆看倉庫、提改動、跑測試、讀編譯器輸出、改方案、再看新報錯。輸出預算大,模型就不用過早收手、把控制權還給人。Google 的說法是:當模型有空間”深度思考、單次生成幾十萬 token”,一次解決難題的能力會上一個臺階。
但別把它當成萬能藥。輸出天花板高,不代表它記得住更早的細節、選得對工具、補丁就正確、速度就更快——這些取決於輸入上下文、Agent 框架、任務本身和驗證環節。而且一個高上限也允許你燒掉一筆錢換來一次失敗的嘗試。把 1M 當成每個請求的默認預算,大概率不是好工程。按任務設額度、記錄實際消耗、對沒有可測進展的嘗試及時止損,纔是用法。
跑分:贏在廣度,不是全勝
Google 公佈的對比表裏,對手是 GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5。綜合媒體的統計:在披露的 18 項基準裏,Argon 單獨第一的有 12 項、並列第一 1 項;Astra 單獨第一 3 項,Opus 5.5 單獨第一 2 項。也就是說,三大前沿模型裏 Argon 拿到的最多榜首,但比賽依然膠着。
領先的地方:
- DeepSWE v1.1(真實長週期軟件工程)77.9%,高於 Opus 5.5 的 74.2% 和 Astra 的 74.1%
- Vals Index(按美國 GDP 權重衡量的金融/編程/法律/稅務經濟影響)68.9%,第一
- AutomationBench(Zapier 的端到端業務執行)51.3%,第一,比 Opus 高 8.8 個點
- Harvey 法律 Agent 基準19.6%,而 Astra 只有 5.4%、Opus 5.5 只有 3.8%——倍率很誇張,但注意絕對值仍然不到 20%,”從很低基數出發的大幅提升”容易顯得比實際更確定
- LVBench(長視頻理解)91.7%,SOTA
- CWE-bench v1(漏洞修復)68%,與 Astra 並列第一
落後的地方,同樣要擺出來:
- FrontierSWE v2:Astra 65.5% vs Argon 55.0%,差 10.5 個點
- Terminal-Bench Science 0.1:Astra 68.1% vs Argon 57.6%,同樣差 10.5 個點
- Terminal-bench 4.0:Opus 5.5 的 66.4% vs Argon 57.4%,差 9 個點
- PostTrainBench:Opus 49.3% vs Argon 45.3%
這就是爲什麼”選誰”依然取決於你的活兒長什麼樣。DeepSWE 領先不代表 FrontierSWE 也領先,兩套基準抽的倉庫、任務長度、語言、工具行爲都不一樣。如果你的負載更像 FrontierSWE 或終端密集型任務,就沒有理由把 Astra 和 Opus 移出候選。
第三方那邊,Artificial Analysis 給出 Intelligence Index 53 分,與 GPT-6 Astra 持平,只落後 Claude Opus 5.5 和 Sonnet 5.5;作爲對照,Gemini 3.1 Pro 是 30 分。Fello AI 還提到它是 Artificial Analysis 測過的頭部模型裏幻覺率最低的。同時彭博報道,一些 Google 內部員工認爲它在真實編程工作上仍有喫力。
Google 自己已經在重度使用
官方舉了幾個內部案例,這是全文裏最有信息量的部分,因爲它們是真實生產環境的落地,而不是實驗室跑分:
- 量子算法優化:幫助量子計算團隊優化關鍵應用裏子程序的時空資源(qubit × gate),有一個案例在幾分鐘內超過已發表基線 40%
- 內存效率:一組 Argon Agent 分析全機隊 profiling 遙測,自動找出並應用內存優化,鋪開後釋放超過 300 TiB 內存,預計總節省 500 TiB 到 1 PiB
- C/C++ 轉 Rust:從 re2、libgav1 這類核心庫的幾萬行,一路到 Fuchsia OS Zircon 內核的 80 萬行以上。這些系統太關鍵,所以大規模重寫在上生產前要走嚴格的自動化+人工審計、仿真測試和評審
最具體的是 libgav1——Google 開源視頻解碼器。Argon Agent 接手一個已有的 Rust 移植版,通過多輪 profile-guided 實驗、研究編譯器輸出,替換了 32K 行 SIMD 代碼,產出編譯器能自動向量化的安全 Rust。結果是內存安全的解碼器,比原 Rust 移植版快 2.7 倍,視頻輸出完全一致。
網絡安全:Argon 的第二個主戰場
Argon 被專門訓練來做網絡安全防禦,能力是自主發現、驗證並修復關鍵軟件漏洞。對可信防禦者和 Google 內部團隊,Google 會去掉網絡安全護欄發佈,讓他們用滿前沿級的防禦能力。
已披露的戰績:Wiz 通過它的 Scan for Good 計劃用 Argon 免費保護關鍵公共基礎設施,模型在全球醫院使用的醫療軟件裏發現了一個暴露敏感個人信息的嚴重漏洞,而之前的前沿模型都沒發現。此外在 Google 內部的綜合漏洞基準上,Argon 在橫跨 20 種編程語言的複雜代碼庫裏找出了一批暴露面;在 Wiz 內部的黑盒滲透測試基準上,它在發現攻擊面、識別漏洞、產出 PoC 證據這幾項上都超過了 Gemini 3.8 Flash Cyber。
Fairwind 計劃的第一批交付,是 Gemini 3.8 Flash Cyber 搭配 CodeMender 框架,幫防禦方發現、驗證和修復漏洞。
定價:半價開場,之後翻倍
引入期價格是每百萬輸入 token 2 美元、輸出 10 美元,緩存輸入按輸入價的 95% 折扣,也就是約 $0.10/百萬緩存輸入。引入期結束後漲到 4 美元輸入 / 20 美元輸出,緩存輸入約 $0.20。Google 沒說這個”引入期”有多長,不過行業慣例是——有時候這種”促銷價”會一直留着當正式價。
放在同一張價格表裏就看得清楚:引入期的 Argon 是 GPT-6 Astra($10/$50)的五分之一,是 Claude Opus 5.5($4/$20)的一半。這個定價給了 Google 兩個不同的故事——促銷期它是最便宜的頭部模型之一,促銷結束就和 Opus 5.5 同價了。
發佈前的安全閘門
Google 在四個方向加碼了前沿安全措施:
- 防濫用:設計上拒絕有害的網絡與 CBRN 請求,同時保留正當的雙用途科研;改進了監控模型內部激活來識別濫用的技術。護欄經內部和外部紅隊用人工+自動化攻擊方法做了魯棒性測試
- 防提示注入:Google 稱 Argon 是”迄今對間接提示注入最有韌性的模型”。Gray Swan 的 IPI 基準上攻擊成功率 0.7%,對比 Opus 5.5 和 Fable 5.1 的 1.0%、GPT-6 Astra 的 8.5%、GPT-6 Sol 27.0%、GLM 5.3 31.5%、Grok 4.8 高達 51.8%——這個差距相當懸殊
- 監控目標偏離:監控 Argon 的思維鏈和動作,必要時中斷執行。Google 還在訓練過程中用了類似系統,跑偏就告警給專門的應急響應團隊,並特意避免把發現迴流進訓練,以免塑造出會規避監控的推理方式
- 加固系統:按”Agent 控制路線圖”,在高風險訓練或評估開始前,把沙箱環境隔離並封存
其中”故意不把監控發現喂回訓練”這一條,是這份公告裏最值得品的一句——它指向一個真問題:如果你用監控結果去訓練模型,模型可能學會的是”如何不被監控發現”,而不是”如何不發散”。
怎麼看這次發佈
對企業來說,這次發佈的意義不在於”又一個聊天機器人”,而是 Google 在 OpenAI 和 Anthropic 持續施壓幾個月後,重新證明自己還坐在前沿牌桌上。它選的三個落點——軟件開發、專業知識工作、網絡安全運營——恰好是企業已經在花錢的地方。
但它不需要”全勝”就能改變競爭格局。在 18 項裏領先或並列 13 項,已經足夠讓 Google 主張自己”在廣度上領先”;而它落後的那幾項——FrontierSWE v2、Terminal-Bench Science、Terminal-bench 4.0——也提醒大家,OpenAI 和 Anthropic 各自仍有明確的技術強區。
實用的結論只有一句:模型選型還是取決於你的工作負載。拿你真實的活兒去試點,別拿一張好看的跑分表來選型。真正的分水嶺是 Argon 什麼時候對開發者、企業和消費者開放——那纔是這場發佈從新聞變成生產力的時刻。
前沿競賽沒有終點,只有下一輪。