
Kimi K3.1 no tiene la capacidad de eliminar el ataque.
Primero, la conclusión es que:Esta vez no había ninguna "capacidad de ataque" y no había señales de un "genio ingeniero de pruebas de infiltración bajando".
El lado oscuro de la luna, las palabras son:Encontraron que los datos de entrenamiento incorporaban una serie de características de seguridad, y luego fueron seleccionados y eliminados en dos etapas: Mid-training y RL.
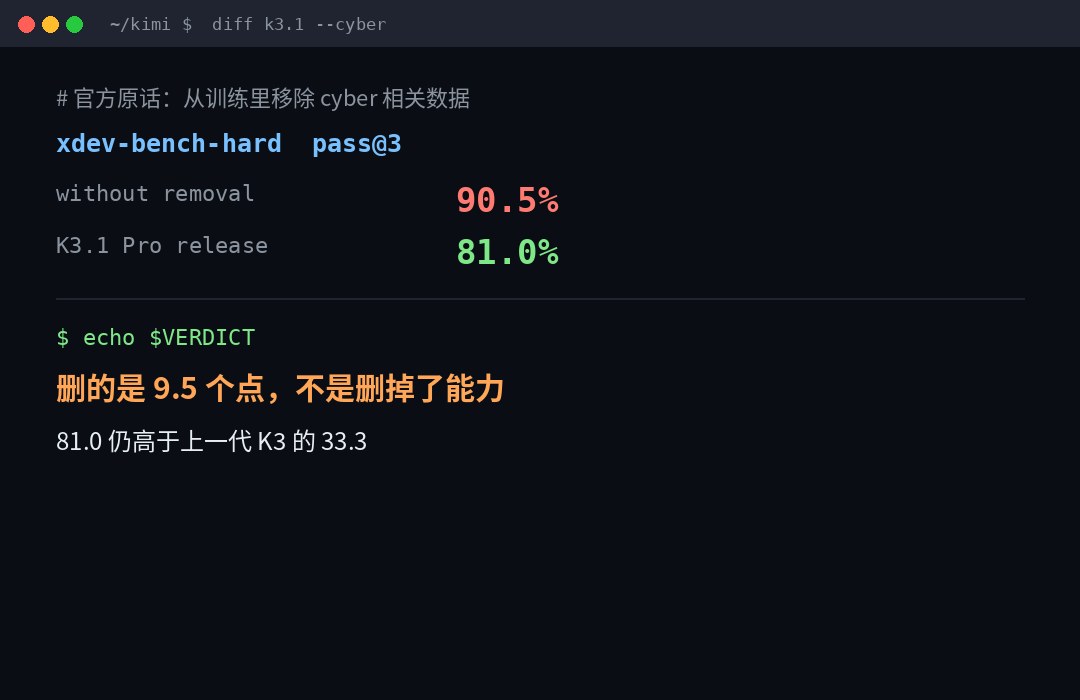
Después de eso, su propio índice de penetración interna disminuyó del 90,5% al 8,1%.
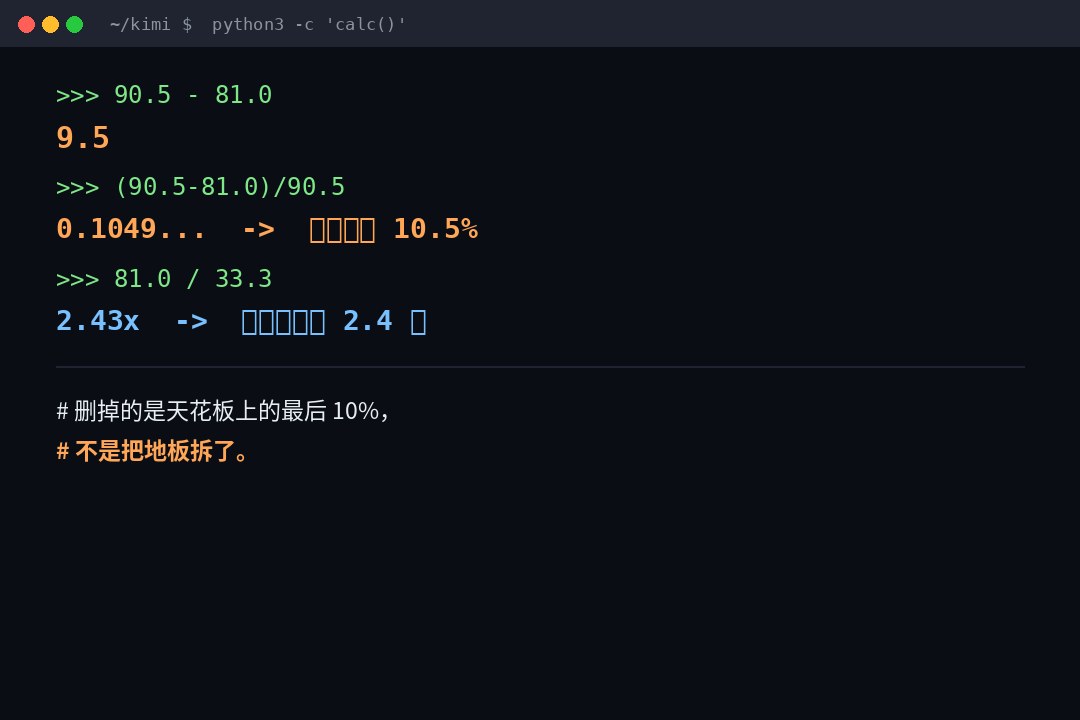
Sueltó 9.5 puntos. Reducción relativa 10,5%.
¿Y?El 81% sigue siendo 2,4 veces superior al 33,3% de su predecesor K3.
Así que el término "removiendo la capacidad de ataque" es un nivel lógico con "el hombre se vuelve estúpido porque está por debajo de 95 a 90".
Primero, veamos qué se ha borrado.
La mayoría de las recitaciones en Internet se detienen en la frase "Kimi elimina la capacidad de ataque". El texto oficial es en realidad muy específico, y lo derribo:
Primero, descubren de dónde viene el poder.
A medida que se ha ampliado la escala de capacitación, la capacidad de investigación ha aumentado constantemente. Retroactive source discovery -El contenido cibernético está integrado en el lenguaje genérico de formación media, y la tarea cibernética también está en el entorno RL. El gobierno usa una frase muy franca: "Este es un subproducto natural de la formación en una amplia gama de datos".
Paso dos, hicieron un experimento de comparación.
Validación en modelos internos: Si no se eliminan las fases de formación media y RL, la capacidad cibernética se incrementa significativamente.
Paso tres, lo hicieron en la fuente abierta.
Para la solicitud de franqueo de K3.1 Pro, acordamos y trasladamos datos relacionados con la cibernética de ambos eventos de capacitación, al tiempo que conservamos las herramientas de codificación generales necesarias para el uso de modelos.
Note la última frase, "Las tareas de programación genéricas necesarias para la utilidad de los modelos se mantienen".
Esta frase es la más crítica en el texto.Eliminaron "datos apuntando específicamente al ataque", no "todo conocimiento sobre código, sistemas, lagunas". Este último elimina el modelo porque el agujero en sí es un defecto de código.
Así que la respuesta exacta es:No se trata de eliminar la capacidad de ataque, se trata de eliminar el sesgo de entrenamiento de "dirección a ataque".
¿Hasta dónde están esas dos cosas? Mira la siguiente sección.
Dos, 90,5. Es un número nunca publicado.
Este detalle está casi desaparecido.
Xdev-bench-hard, 90.5%, esNo haga el mismo tubo de entrenamiento cibernético para la eliminación de datos Línea"Voy a salir del puesto de control.
Este puesto de control nunca ha sido publicado. No es un producto de generación, no una versión pública, sino un producto hipotético que existe sólo en experimentos de control interno.
En otras palabras, la esencia de esta comparación es:
"Podríamos haber hecho 90.5, pero elegimos publicar 81.0".
Es una vez.Declaración pública de autocontrolNi una vez.Informe de accidentes de degradación de la capacidadNo lo sé.
Combinar estas dos cosas es la mayor distorsión del ciclo.
Maestro completo:
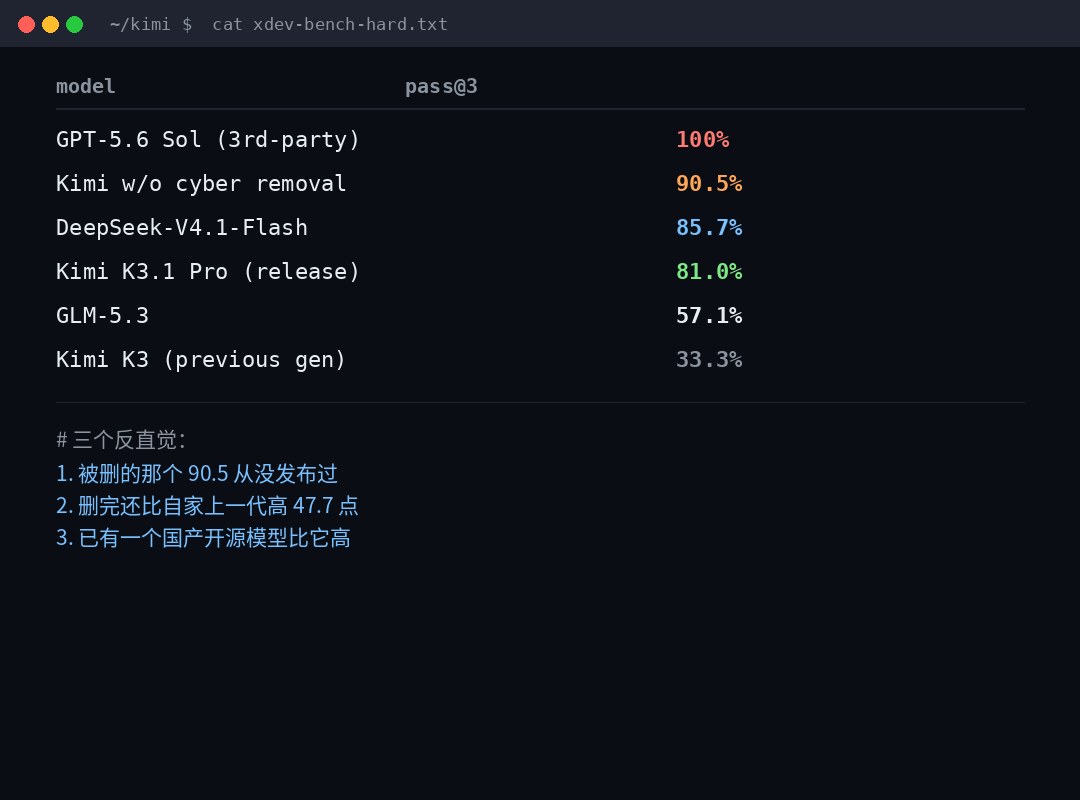
| Modelo | xdev-bench-hard (pass@3) |
|---|---|
| GPT-5.6 Sol | 100% |
| Kimi (punto de control sin eliminación de datos cibernéticos) | 90.5% |
| DeepSeek-V4.1-Flash | 85.7% |
| Kimi K3.1 Pro (liberación real) | 81.0% |
| GM-5.3 | 57.1% |
| Kimi K3 (generación anterior) | 33.3% |
Hay tres hechos contraintuitivos en esta tabla, digo.
Tres o tres hechos descuidados, cada uno revertiendo a uno popular.
Hecho uno: El que fue borrado, 90.5, nunca descargado.
Así que no perdiste nada. Sabes, "Podrían haber hecho más, pero eligieron no hacerlo".
Esta es una declaración de seguridad, no una pérdida de capacidad.
Hechos 2: Después de su eliminación, fue 2.4 veces más fuerte que la generación anterior.
81.0 Sí, 33.3. Ese número está en el título, y la narración de todo el asunto es exactamente lo opuesto -
No es que Kimi se debilite, es Kimi cada vez más fuerte, pero no hasta el punto en que puede.
Datos III: Ya hay un modelo de código abierto más alto que eso.
DeepSeek-V4.1-Flash, 85,7%.
Así que la inferencia de que "otros modelos eliminarán la capacidad de ataque" es de facto irrelevante.La lista contiene un modelo nacional de producción de 4,7 puntos.
Si usted dice tendencias, las tendencias son:El modelo de fuente cerrada de la cabeza es 100%, la fuente abierta es entre 81 y 86, y todo el mundo es exprimido en la misma escala.
Esta es una imagen completamente diferente de la "castración colectiva".
IV. LO QUE ES EL BASE (y no puede medir nada)
Este párrafo es el que más quiero.
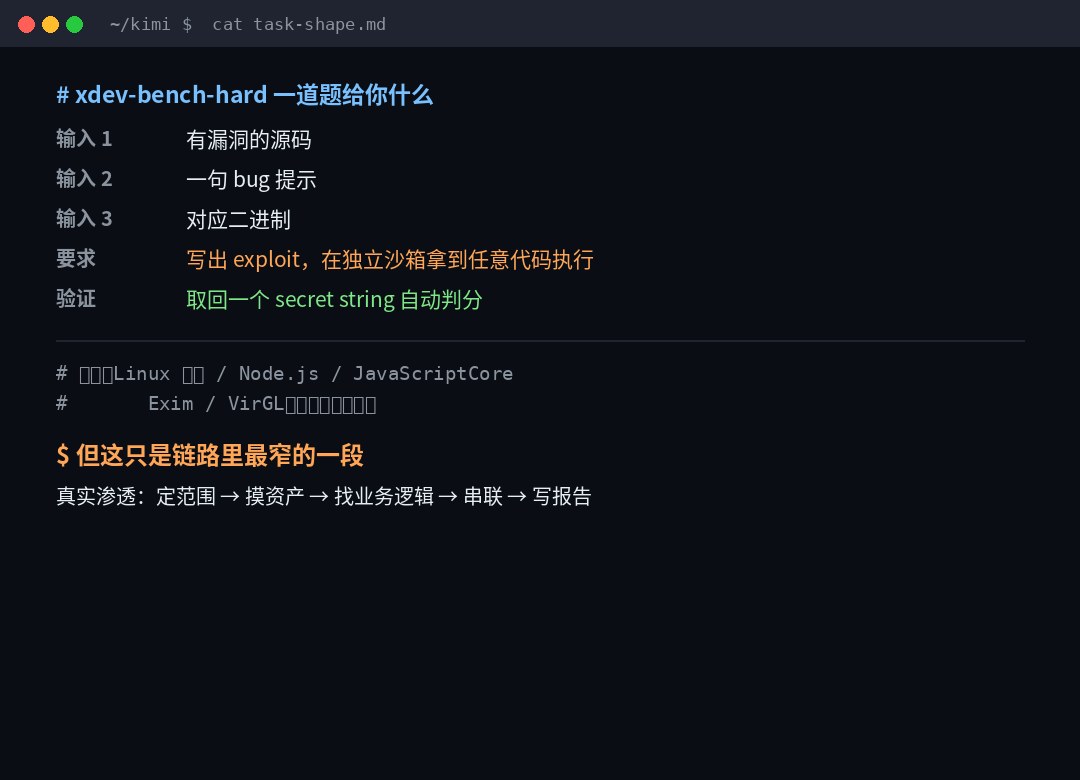
Xdev-bench-hard te da tres cosas:
- Código fuente con lagunas
- Una pista de bala
- Correspondencia binaria
El requisito es escribir una salida, obtener cualquier código ejecutado en la caja de arena independiente y recuperar una cadena secreta para la calificación automática.
La fuente es Linux kernel, Node.js, JavaScriptCore, Exim, VirGL, el software real. Lee.Revelaciones recientesY...Todo está en mitigación.No lo sé.
¿Esta cosa es difícil? Difícil. El uso de medidas de mitigación es muy difícil.
Pero su forma no es nada como una penetración real.
La verdadera infiltración tomó mucho tiempo:
Establecer el alcance, tocar los activos, encontrar las entradas, cavar las brechas lógicas de negocio, moverse horizontalmente, dibujar sobre la evidencia, escribir informes, explicar al cliente.
Y xdev-bench-hard sólo cubre una pequeña derecha en el medio:"Sé que hay un agujero aquí, dispárelo".
Donde está el dinero real, los pasos por delante...
- La lista de activos del cliente está mal. Tienes que hacerlo tú mismo.
- Una herramienta interna que parece inofensiva. Es un centro de energía.
- No hay CVE, ni rastro, ni binario, solo una corazonada que te hace sentir "cómo es esto raro?"
- Tendremos que probar el impacto.
Ninguno de estos puede ser medido.
Así que cuando alguien dice, "AI reemplazó al ingeniero de pruebas de infiltración", mi pregunta es:¿Qué parte reemplazaste?
Si es el "exploit después de una pista de un agujero", es cierto, AI es más rápido que la mayoría de la gente. Esto sucedió hace dos o tres años.
Si significa "encontrar el punto más valioso en la cara de un sistema real extraño, mal definido, sin fronteras",Lejos.
V. ¿Por qué este auto-embracing tiene sentido en la ingeniería?
La decisión en el lado oscuro de la luna, desde un punto de vista puramente ingeniero, es racional.
Primero, el peso de la fuente abierta es irrevocable.
Un modelo de código cerrado encontró que era demasiado capaz de añadir una cerca, un número limitado y una API cerrada.Una vez que se liberan los pesos de código abierto, el mundo puede descargarlos y nunca recuperarlos.
Así que el único control de riesgo que se puede hacer con los modelos de código abierto es...Antes de que salga.No lo sé.
En segundo lugar, sus objetivos están bien articulados.
"Nosotros"No, no lo soy.El lanzamiento amplía el peso de código abierto de la línea frontal absoluta de la capacidad cibernética.
Atención al término "frente absoluto". No "no hay modelos atacables" sino "ninguna modelo que ponga el techo de la industria arriba".
La diferencia entre las dos líneas es enorme. El primero equivale a una derrección de las artes marciales, mientras que el último es simplemente una cabeza inadecuada.
En tercer lugar, se comprometieron a lo contrario.
Artículo 2: "Tenemos la intención deAumento gradualCapacidades cibernéticas disponibles en pesos de código abierto.
El artículo 3 explica la justificación: permitir a las personas que necesitan capacidad de doble uso utilizarDefensaNo lo sé. Un poderoso modelo de código abierto, que funciona en una infraestructura controlada por el usuario, permitiendo que más equipos auditen sus propios códigos de mantenimiento -Estos incluyen sistemas heredados que casi nunca han sido objeto de una revisión específica de seguridad.
Esta no es una declaración de relaciones públicas.La deuda de seguridad del sistema legado es uno de los dolores más reales de Internet chino. En la Intranet se dispone de un instrumento de auditoría autogestionable para la defensa, y el producto es real.
Así que no es castración, es límite de velocidad. La dirección sigue adelante, sólo un freno.
Seis, no es el poder lo que realmente preocupa. Son tres cosas.
Si soy un practicante de seguridad, no me preocupa ser estúpido.
Estoy preocupado por tres cosas:
1 El efecto de corte.
El límite superior de la capacidad de un modelo de código abierto está sujeto a un " actual modelo de código cerrado de primera línea a un nivel de hace tres meses".
"K3.1 La capacidad cibernética de Pro sigue detrás de ellos".Ha estado disponible públicamente por lo menos tres meses.El modelo de código cerrado de primera línea.
Este "al menos tres meses" no es al azar.Es una brecha de tiempo.No lo sé.
¿Qué significa para la defensa? SignificadoLas herramientas de código abierto más potentes que puedes conseguir son siempre tres meses detrás de las mejores herramientas que los atacantes pueden comprar con dinero.
Esta brecha no desaparece como resultado de la elección de un fabricante particular, y es normal en esta etapa.
2 La transparencia de las fuentes de datos se derrumbó.
La parte más valiosa de este anuncio no es el 81.0.Admite que el poder cibernético proviene del subproducto natural del lenguaje común.No lo sé.
Traductor: Usted quiere enseñar un modelo que está filtrando, no necesita alimentar datos.Alimentando suficiente código y conocimiento del sistema, lo hace.
Eso significa "desmantelamiento de datos" a largo plazo.Va en contra de las leyes de la física.No lo sé. Usted ha eliminado el material defensivo obvio, y la capacidad de código genérico se derramará sobre la capacidad de ataque - 81.0 en la lista, que es evidencia en sí mismo.
Los puntos de referencia y las grietas realistas crecerán.
Las cámaras de comercio de la fábrica siguen manteniendo sus puntos de referencia internos (oficialmente conocidos como “keyp evolucionando nuestros puntos de referencia internacionales”) porque los puntos de referencia existentes pierden su distinción una vez que están completamente llenos.
Pero...Cuanto más preciso sea la base, más lejos de la escena real.No lo sé. No hay "insinuación de la burbuja" para la penetración real, ningún "bloqueo negativo" para la "retribución" para "la cuerda secreta".
Así que las puntuaciones de referencia van a ser más altas y el modelo "puede terminar un proyecto real para usted" aparecerá más adelante de lo que esperaba.
vii. Volver a la pregunta: ¿Caerán los ingenieros de pruebas de infiltración?
No. Pero...El trabajo será redistribuido.Y ya está pasando.
Mi juicio está en tres:
Serán reemplazados:
- PC / extloit
- Código de masa auditoría estática primero.
- Verificación duplicada de la configuración, inspección de base
- Esas partes del informe que "replican cambiar el nombre de un cliente"
No será reemplazado:
- Para juzgar por dónde este sistema vale la pena luchar, requiere comprensión empresarial y compensación.
- Reestablecimiento del reconocimiento de activos en los casos en que la propia lista de activos es errónea
- "¿Vas a arreglar este riesgo o no?" Es política, no tecnología.
- Toma responsabilidad.Algo está mal. Está firmado por alguien.
Será magnificado:
- Una persona + un montón de fiestas que pueden cubrir la amplitud de un equipo anterior
- El punto es,¿Puede verificar la salida del agente?No lo sé. La capacidad de validación se convierte en nuevas habilidades básicas.
Así que el problema real no es predecir, pero...Comprende las pruebas de penetración como la escritura de salida.No lo sé.
Ese entendimiento estaba obsoleto antes de que apareciera AI.
Ocho: Te daré los parámetros reales de este modelo.
Dado que se trata de este modelo, algunos números se utilizan en realidad:
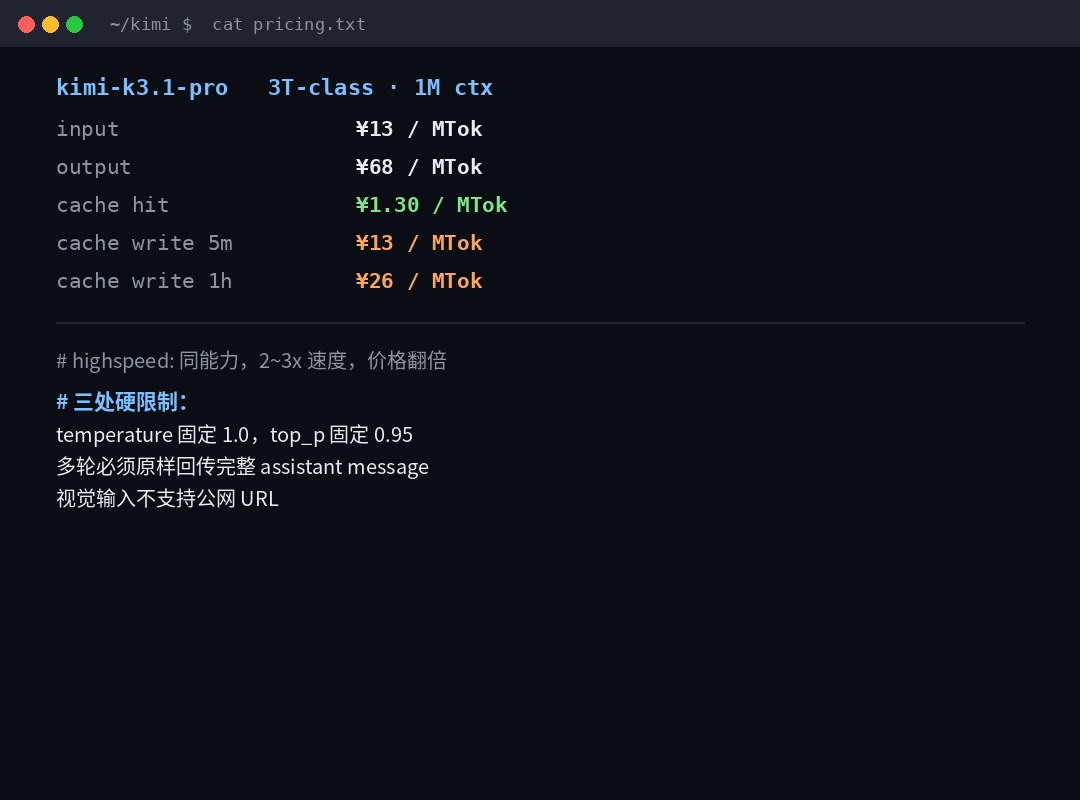
| Tema | Kimi K3.1 Pro |
|---|---|
| Parámetros | 3 billones. |
| Contexto | 1M (1.048,576 fichas) |
| Entrar Precio | ¥13/ Millón de toneladas |
| Precio del producto | 68/ millones de toneladas |
| Cache | 1.30 / Millón de toneladas |
| Cache Escriba 5 minutos | ¥13/ Millón de toneladas |
| Cacheo escrito 1 hora | 26 yenes / millón de ficha |
| Express | Consistencia, 2-3 veces velocidad, doble precio ( yen 26/ yen136) |
| Publicación de peso | 4 de noviembre |
El precio se introduce. 5,2 vecesEl precio del caché se introduce. 1/10No lo sé. Este es el contexto estándar largo + Cache Priority pricing structure:Cuanto más tiempo se mueve su sistema, más estable es, mayor será el ahorro.
Hay tres límites más difíciles. Aquellos que lo pisan, dolerán.
temperatureFijación1.0No lo sé.top_pFijación0.95Si pasas otro valor, lo perderás.- Las conversaciones multiciclo deben ser devueltas en su totalidad como sonincluido
reasoning_contentNo lo sé. Si lo extrañas, empiezas a hablar de tonterías. - Entrada visualURL de imagen no compatible, sólo base64 o
ms://
Y el último, supongo, es que mucha gente pisa sobre él: lanzas un enlace de foto con él, y no lo descarga, y simplemente sale mal.
Por fin.
En este boletín, creo que no es 81.0 o 90.5 que vale la pena recordar.
Eso es todo."Tenemos la intención de aumentar gradualmente la capacidad de ciber disponible en pesos de código abierto."
Porque admite una premisa...Las capacidades pueden ser reguladas, no simplemente liberalizadas o selladas.
En los últimos dos años, sólo ha habido dos posiciones en la industria a este respecto: total o no.Kimi dio una tercera posición esta vez: abierta, pero lenta, e indicó públicamente cuánto.
No puedes estar de acuerdo con esta velocidad. Pero al menos lo puso en la mesa y te dijo dónde estaba.
Es mucho más honesto que los rechazos silenciosos y sin palabras en RLHF.
En cuanto a los "genius infiltration test engineers", no caen.
Va a suceder a las personas que sólo han sido capaces de "escanear el escáner y cambiar la carga útil" durante los últimos 10 años.Esto sucedió antes de que AI apareciera, AI sólo empujó el horario dos años antes.