
我蹲了半個月,Gemini 4 Argon 今天凌晨終於全球上線了
先說結果:Gemini 4 Argon 今天(10 月 13 日)凌晨正式全球開放了。我爲了它前後蹲了半個月,中間踩了兩堵牆,都寫在下邊——順便把它贏在哪、輸在哪,用官方跑分表給你擺清楚。
第一堵牆:官宣不等於能用
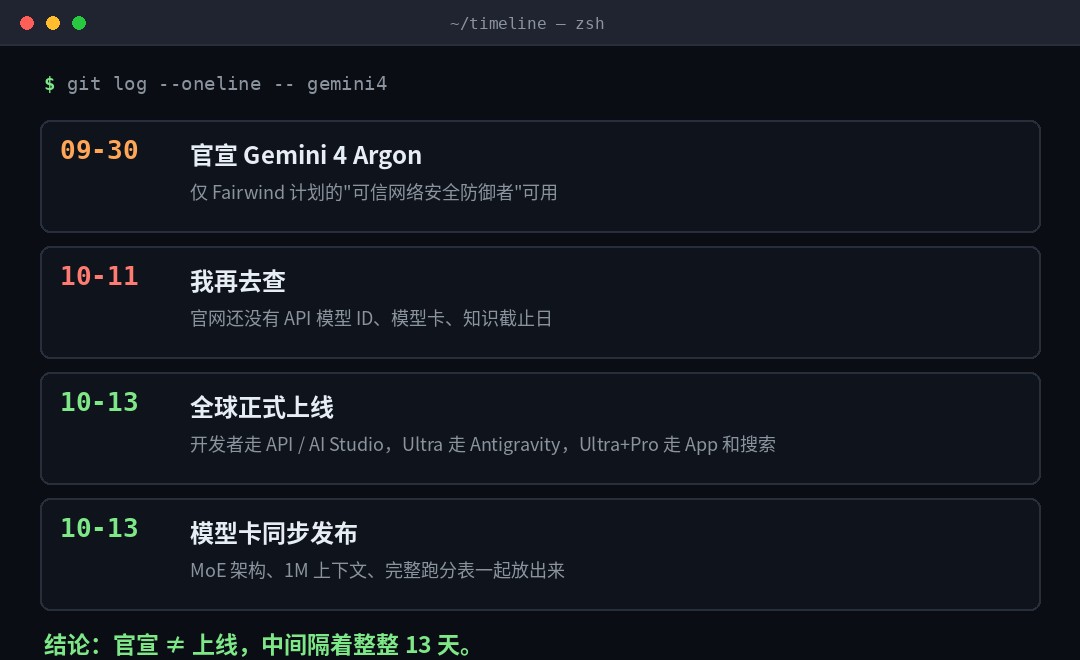
9 月 30 日,谷歌發了篇博客,宣佈 Gemini 4 Argon——“我們面向真實世界編程、企業知識工作和網絡防禦的前沿模型”。標題很唬人,我當天就興沖沖去看怎麼用。
結果頁面最後一行寫着“rolling out soon”。Soon 了個寂寞。
再一查才知道,這次它是先給了 Fairwind 計劃裏的“可信網絡安全防禦者”,配合美國政府做發佈前的安全評估。用產品負責人 Tulsee Doshi 的話說,這麼做是爲了“讓一個在網絡安全上訓練得很強的模型,儘快交到防禦者手裏”。
普通開發者、普通用戶?沒門。
第二堵牆:過了 11 天,官網還是空的
到了 10 月 11 日我又去翻了一遍,官網依然沒有 API 模型 ID、沒有模型卡、沒有知識截止日期。那幾天網上已經傳瘋了“測出這個數”“碾壓那個模型”,但一追源頭,全是預測,不是官方數據。
這裏我得說個判斷:谷歌經常“提模型名”和“發佈模型”是兩回事。它在 7 月 21 日官宣一次訓練時就點過 Gemini 4 的名字,那只是路線圖信號,不是可用性信號。官宣和上線之間,是可以隔着很多天的。
這次隔了整整 13 天。
今天凌晨,三件事同時發生
10 月 13 日(也就是今天凌晨),谷歌一口氣把該給的都給了:
- 模型卡發佈(10 月 13 日)——架構、上下文、完整跑分表全攤開了;
- 全球開放——開發者、企業、消費者一起開閘;
- 訪問路徑分清——誰能用、從哪進,一次性說明白。
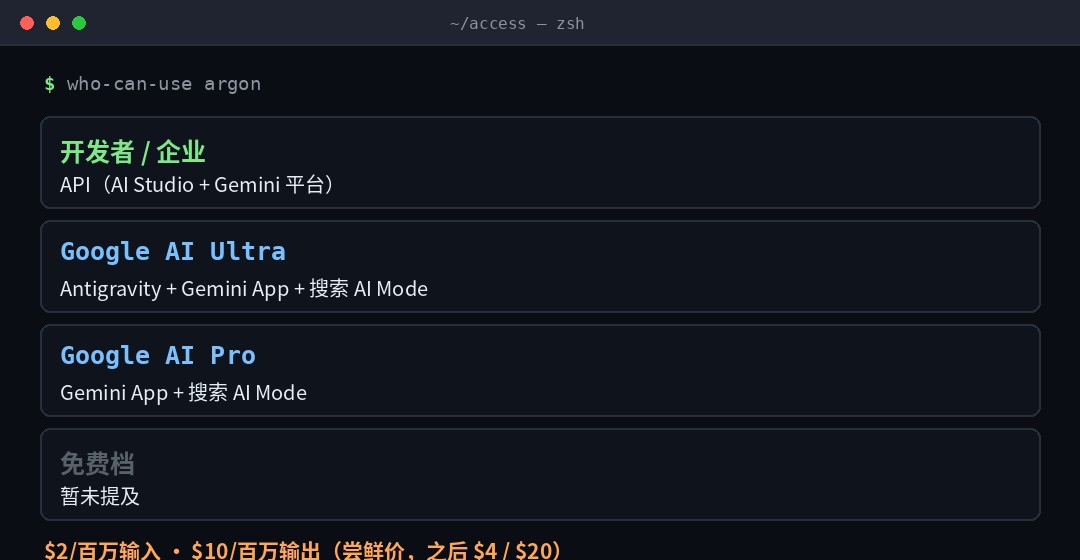
我把“誰能用”整理成一張表,直接抄:
| 你是誰 | 從哪進 |
|---|---|
| 開發者 / 企業 | API(AI Studio + Gemini 平臺) |
| Google AI Ultra 訂閱 | Antigravity + Gemini App + 搜索 AI Mode |
| Google AI Pro 訂閱 | Gemini App + 搜索 AI Mode |
| 免費檔 | 官方沒提 |
價格也一併放出來了:嚐鮮價 $2 / 百萬輸入 token、$10 / 百萬輸出 token,之後漲到 $4 / $20。想白嫖的,趁嚐鮮期薅。
它到底是什麼:先看硬參數
官方模型卡里幾句話值得劃重點:
- 它是全新前沿模型,不是老模型的微調或改版。這點很重要——不是“套殼升級”。
- 架構是大規模稀疏混合專家(MoE)+ Transformer,原生支持文本、視覺、音頻輸入。
- 上下文窗口:輸入 + 輸出合計最多 1M token。這是這一代最實在的升級之一。
- 訓練用谷歌自家 TPU,跑 JAX + ML Pathways。
- 定位場景:多輪深度調查、複雜工程任務、深度視覺理解、網絡安全防禦、多模態文檔分析、法律/金融/科學推理。
用一句話翻譯:它是衝着“細活、深活、長活”去的,不是衝着“快”去的。
重頭戲:跑分表,贏的輸的都擺出來
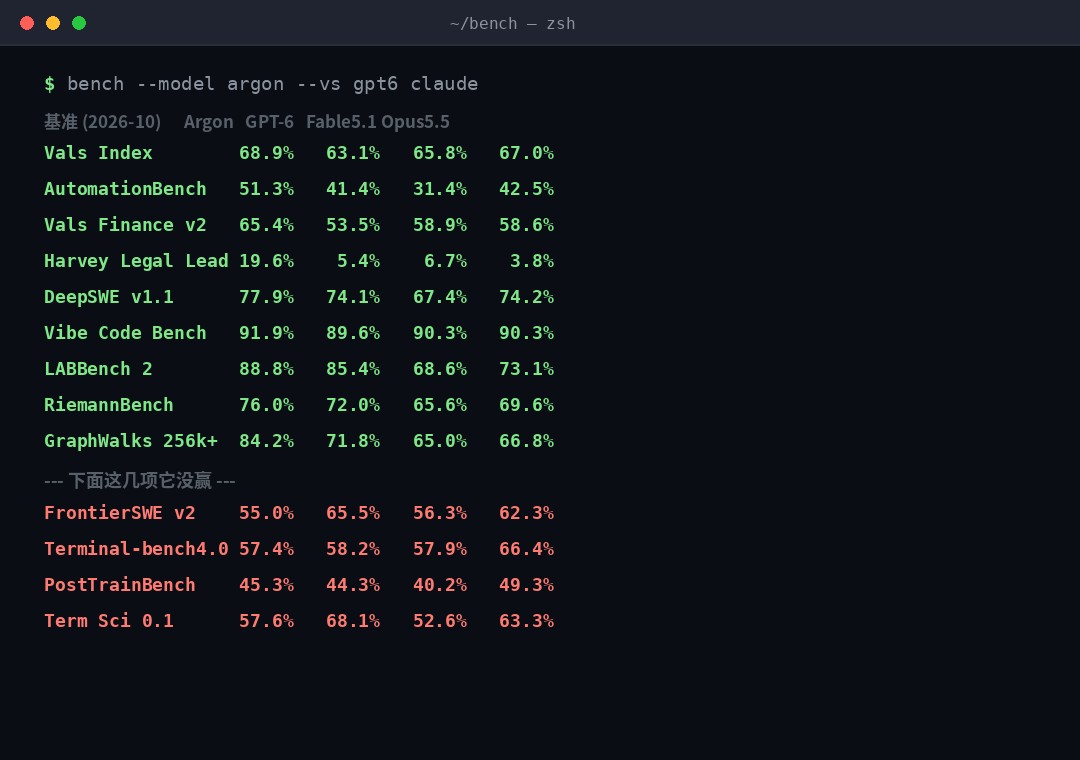
這是全文最該抄走的部分。以下是 Google DeepMind 模型卡里 2026 年 10 月的官方對比,對手是 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5。
它贏的:
| 基準 | Argon | GPT-6 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| Vals Index(知識工作) | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey 法律 Agent | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1(編碼) | 77.9% | 74.1% | 67.4% | 74.2% |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| LABBench 2(科學) | 88.8% | 85.4% | 68.6% | 73.1% |
| RiemannBench(數學) | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks 256k~1M | 84.2% | 71.8% | 65.0% | 66.8% |
它沒贏的(同樣是官方數字,別裝看不見):
| 基準 | Argon | GPT-6 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench(ML工程) | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| OSWorld-2.0(電腦操作) | 69.2% | 72.6% | — | — |
網絡安全那項,它和 GPT-6、Grok 4.7 並列第一(CWE-bench v1 都是 68.0%)。
我的實測感受(說人話版)
真本事的三個方向:
- 知識工作的廣度是真的。Vals Index、金融、法律這幾項領先幅度不小——尤其是 Harvey 法律 Agent,19.6% 對 5.4%,幾乎是碾壓。做法律/金融分析的,這個提升是能摸到的。
- 長上下文是真穩。GraphWalks 從 256k 一路到 1M 那段,84.2% 對 GPT-6 的 71.8%,差距明顯。要喂幾百頁文檔做多輪深挖的,這代是真能扛。
- 多模態文檔分析很強。Chartography 71.6%、LVBench 91.7%,圖表理解這塊是它的舒適區。
短板也很清楚:
- 最硬的真實軟件工程題它沒贏。FrontierSWE v2 落後 GPT-6 十個百分點——“寫代碼”和“打硬仗式軟件工程”是兩回事。
- 終端、科學推理、電腦操作都不佔優。要跑 shell 任務、要控瀏覽器點來點去的,目前還是別人更強。
- 別被“綜合第一”的話術騙了。它是“廣度驚人”,不是“樣樣第一”。
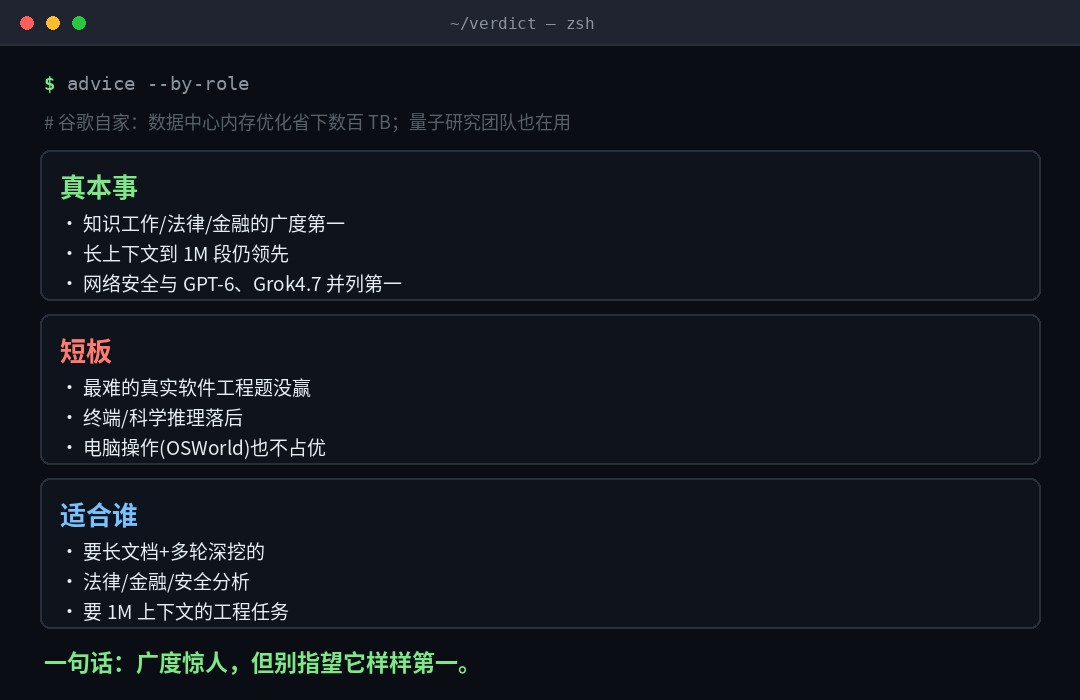
落到你身上:分角色建議
如果你是開發者
- 想試的,今天就能從 AI Studio / API 進,嚐鮮價 $2/$10;
- 但它不是 DeepSWE 那種硬核工程任務的答案——真跑複雜軟件工程,先把 FrontierSWE 那欄的差距放心裏;
- 1M 上下文是它最值得試的點,喂長文檔、大倉代碼庫的活,優先上它。
如果你是法律 / 金融 / 安全從業者
- 這代對你是實打實的升級:法律 Agent、金融 Agent、網絡安全三項都在第一梯隊;
- 網絡安全那塊和 GPT-6 並列第一,配合它首發給網絡安全夥伴的動作看,谷歌在安全場景是認真押注的。
如果你就想嚐個鮮
- Google AI Ultra 走 Antigravity,Ultra / Pro 訂閱在 Gemini App 和搜索 AI Mode 裏就能摸到;
- 免費檔暫時沒提,想第一時間用,得先有個付費入口。
最後
谷歌內部已經拿它在自家數據中心做內存優化,說是“沒買新硬件就省出幾百 TB 內存”,量子計算研究團隊也在用。這種“先自用再外放”的路子,比任何跑分都更能說明它的分量。
但記住今天這兩堵牆:官宣 ≠ 可用,綜合第一 ≠ 樣樣第一。蹲了半個月換來的教訓就這兩句——其他的,跑分表都寫着,自己看。
官宣 ≠ 可用,綜合第一 ≠ 樣樣第一