
B, GGUF, MTP, A3B, E4B : Les cinq caractères du nom du modèle, pas un. Oui.
Commençons par une conclusion qui sauve la moitié de la confusion :Ces cinq choses ne sont pas du tout les mêmes dimensions.B est le mot, A3B et E4B est la "quantité", GGUF est le conteneur, MTP est le plugin. En fait, ils répondent à une question tout à fait différente.
La répartition spécifique du travail est la suivante:"B", "Combien grand", "A3B", "Combien de travail", "E4B", "Combien est vraiment dans la mémoire", "GGUF", "Qu'y a-t-il dedans", "MTP", "comment ça accélère."Quatre ou cinq documents apparaissent simultanément parce qu'ils doivent être exprimés simultanément — mais il y a souvent confusion lorsqu'ils sont traités comme le même type d'information.
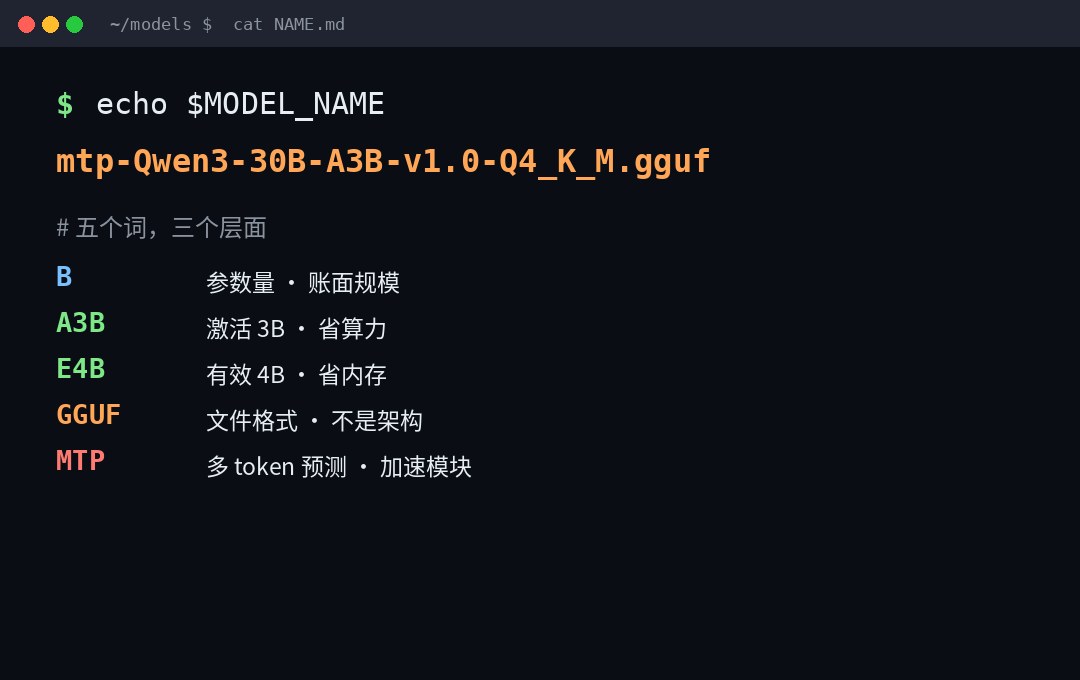
Un, B: Ce n'est qu'un milliard.
B est Million, un milliard.7B C'est un paramètre de 7 milliards.235B Ça fait 235 milliards. C'est un ensemble de préfixes d'échelle dans le code de nom GGUF :K MilliersM Des millions,B Un milliard.T des milliards de dollars,Q Des milliards.
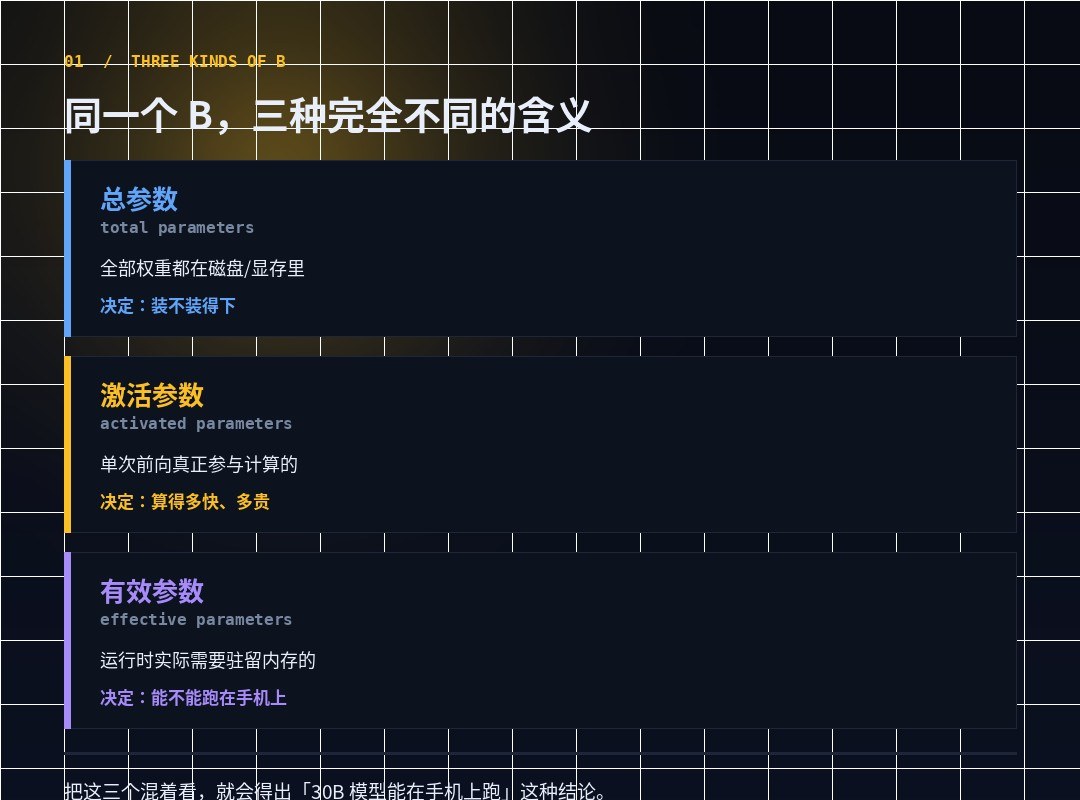
On dirait la plus simple, elle a trois significations complètement différentes. C'est la première chose qui devrait être claire:
| Écrire | Signification | Décider quoi ? |
|---|---|---|
30B | Paramètres généraux: poids total | Tu peux jouer ?(disque visible) |
30B-A3B | Total 30B, activation unique 3B | À quelle vitesse ? Combien ? |
E4B | Paramètres valides: présence réelle au moment de l'opération | Tu peux courir au téléphone ? |
Si vous regardez ces trois lignes ensemble, vous obtiendrez la conclusion que le modèle 30B peut fonctionner sur un téléphone cellulaire.C'est peut-être juste, mais ce n'est pas la même chose que le 30B que vous pensiez.
II. A3B : Les paramètres généraux et les paramètres d'activation ne sont pas une seule fois Oui.
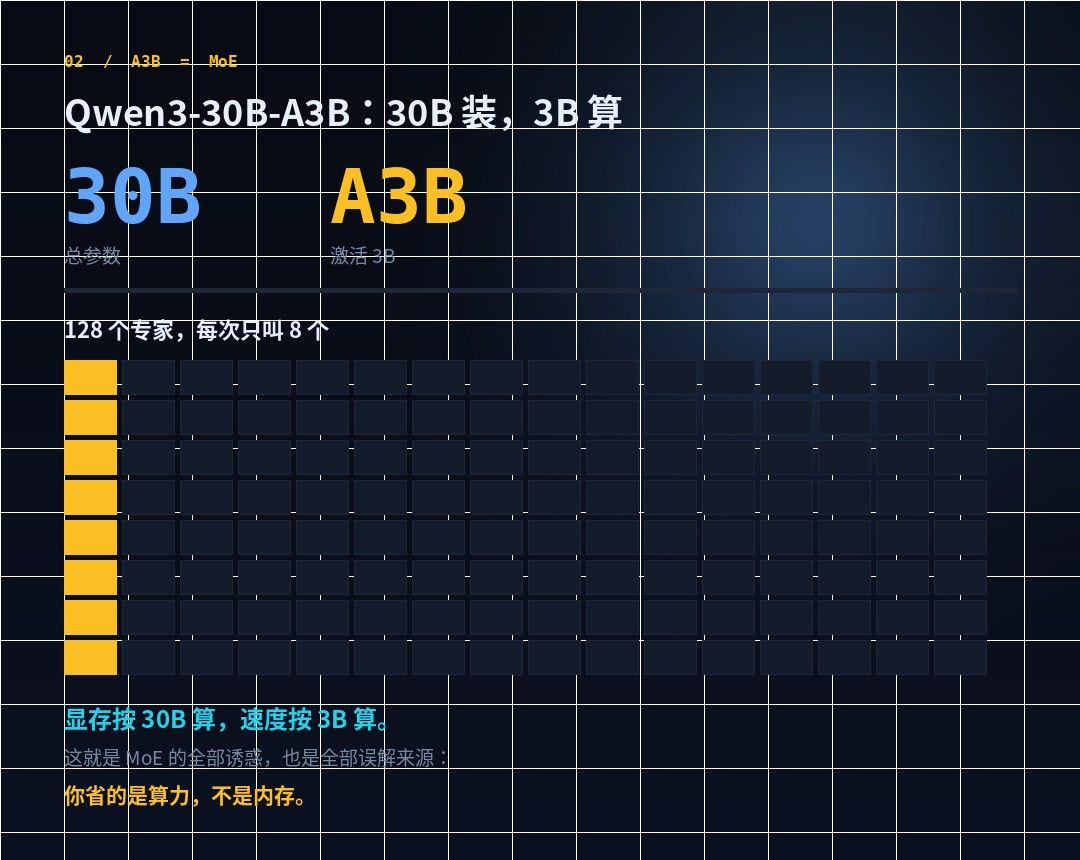
C'est du Ministère de l'E. Qwen3 est très clair sur les noms des modèles:Qwen3-235B-A22B est un grand modèle de « 233,5 milliards de paramètres totaux, 22 milliards de paramètres activés », et Qwen3-30B-A3B est un petit MoE de « 30 milliards de paramètres totaux, 3 milliards de paramètres activés ».
Les détails techniques sont également spécifiques: 30B-A3B a 48 étages, Q/KV tête compte 32/48 spécialistes sur 128 activés, contexte 128K. 235B-A22B est 94ème étage, 64/4 tête, également 128 experts activés 8.
Donc, A3B, la signification réelle de cette marque est:Affiche 30B, vitesse 3B.
C'est la tentation du Ministère de l'éducation, toutes les sources de malentendu.Vous économisez de l'argent, pas de mémoire.Beaucoup de gens voient A3B et pensent qu'il s'agit d'un modèle 3B, chargé sur une machine de 4 Go, puis trouvent impossible de charger. Aucun des poids n'est petit, mais pas tous les calculs avancés.
Avec une écriture facile à ignorer: SizeLabel de GGF est <expertCount>x<count><scale-prefix>♪ Et ainsi ♪ 8x7B Ceci est appelé "8 experts x 7B", pour un total de 56B.C'est soit une ellipse à multiplication, soit une multiplication.Mixtral-8x7B est souvent mal interprété comme un "modèle 7B" et le paramètre total réel est 56B.
III. E4B:E est efficace, pas "plus petit"
C'est l'un des plus faciles à lire. Le document de Gemma 3n est clair :
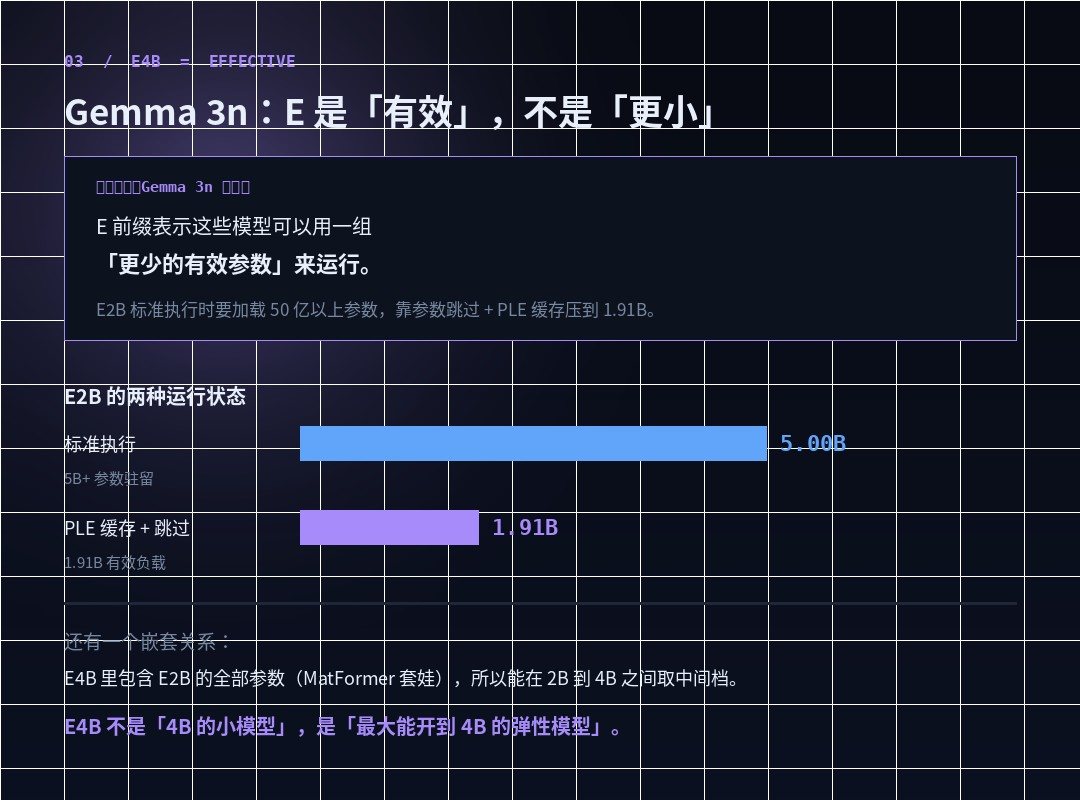
Marques de paramètres pour le modèle Gemma 3n (par exemple E2B, E4B)Moins deLa quantité totale de paramètres réellement inclus dans le modèle. Le préfixe E indique que ces modèles peuvent être exécutés avec un ensemble de « paramètres moins actifs ».
Dans quelle mesure ? Le document indique le numéro:Les normes E2B sont implémentées en chargeant plus de 5 milliards de paramètres, en sauts et caches PLE par paramètres pour appuyer sur la charge de mémoire active à 1.91B.
Veuillez noter les principaux mots de cette phrase :Le modèle lui-même n'est pas devenu plus petit, il est devenu plus petit en termes de sa présence en cours d'exécution.
Cela peut être réalisé par deux mécanismes:
- PLE Cache (Emballage par layer).Chaque couche de paramètres embarqués peut être générée séparément de la mémoire du modèle, mise en cache dans un stockage local rapide, et ajoutée à chaque couche lors de l'exécution.Ceci est égal à demander cette partie du paramètre hors de la mémoire.
- MatFormer.Il y a plusieurs petits modèles intégrés dans un grand modèle, qui n'ont pas besoin d'activer les paramètres extérieurs lorsqu'ils sont déduits. Donc vous pouvez prendre n'importe quel milieu entre 2B et 4B.
Cela conduit à un fait contre-intuitif:E4B contient tous les paramètres E2B.Pas deux modèles autonomes, deux fentes pour le même modèle élastique. Donc le terme exact n'est pas "E4B est un petit modèle 4B" mais "E4B".E4B est un modèle élastique avec une puissance maximale allant à 4B.C'est pas comme si j'allais nulle part.
Cela a un grand impact sur le jugement selon lequel « je peux courir sur mon équipement » :E4B peut fonctionner comme E2B sur des équipements à faible équipement et s'étendre jusqu'à 4B sur des équipements à équipement élevé.Et A3B n'a pas cette élasticité -- c'est 30B, c'est juste une économie.
IV. GGUUF: Ce n'est pas un modèle, c'est une boîte modèle.
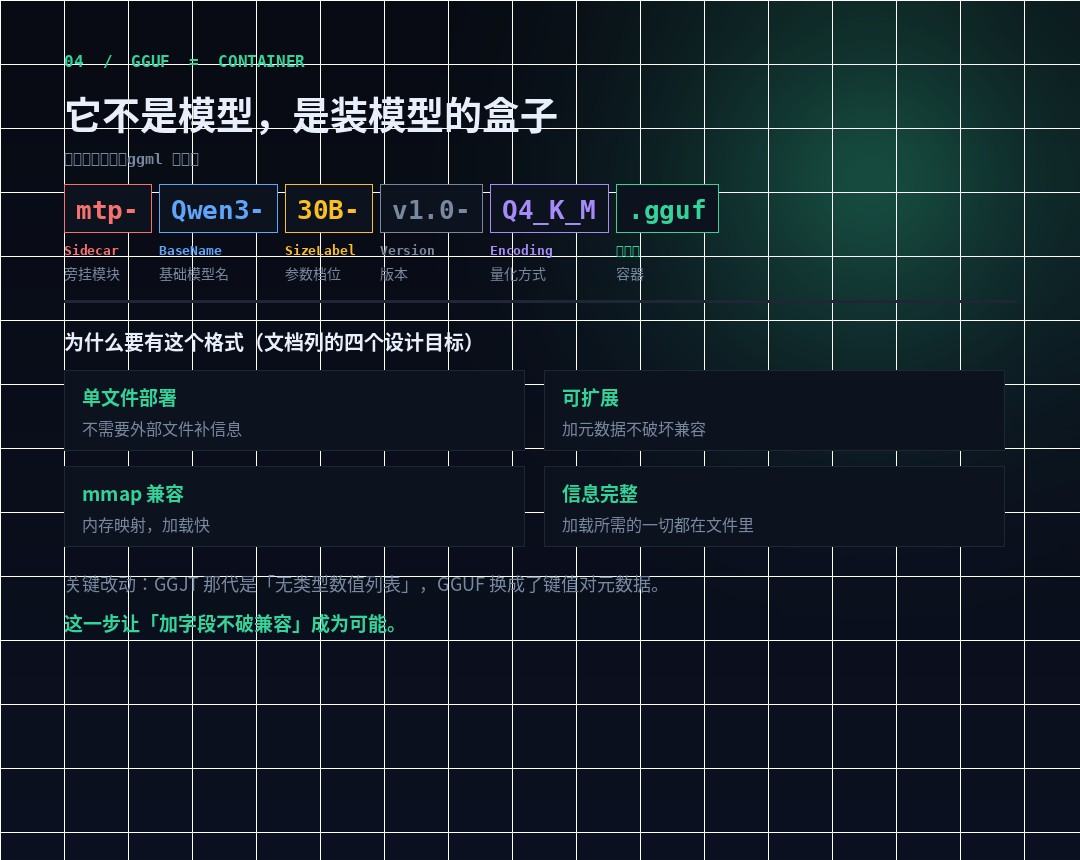
Les trois premiers sont la taille du modèle, qui a changé les dimensions de GGUF:C'est le format de fichier.Pour être précis, GGUUF est un format de stockage modèle pour GGML et son implementateur (lama.cpp).
Il remplace GGML, GGMF, GGJT, format à trois générations. Les cibles officielles de conception sont quatre, chacune correspondant à un point de douleur passé:
| Objectifs de conception | Faire face à quoi ? |
|---|---|
| Déploiement de fichier unique | Aucune documentation supplémentaire requise, distribution directe et chargement |
| Étendue | L'ajout de nouvelles métadonnées ne compromet pas la compatibilité des anciens modèles |
mmap Compatibilité | Carte mémoire Chargement, rapide |
| Informations complètes | Tout ce que vous devez charger est dans le fichier. Les utilisateurs n'ont pas à le fournir. |
La différence clé entre elle et la dernière génération de GGJT n'est qu'une phrase, mais c'est la clé :L'hyperparamètre passe d'une liste de valeurs sans type à une clé pour les métadonnées.Cette étape a permis d'« ajouter une incompatibilité de champ » — une fois qu'un champ a été ajouté, tous les anciens résolveurs ont dû être changés.
Comment l'avez-vous épelé ?
Le code de désignation officiel est :
[].ggufPrenez un vrai exemple.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (module par ligne, voir section suivante)Qwen3→ Nom de base (nom de modèle de base)27B→ TailleLabel (slot de paramètre)v1.0Version (version)Q4_K_MEncodage (encodage de poids/ quantification)
Il y a deux composantes qui ne semblent pas souvent connues :
- Type.:
LoRACela signifie que c'est un adaptateur, pas un modèle complet;vocabindique le fichier de vocabulaire. - L'ombre.:
00003-of-00009Affiche la fraction, 3ème de 9 Attention.La numérotation commence à 00001Pas 00000.
Il y a aussi un avertissement important dans la norme :Ça s'appelle "pas déchiffrable dans la nature"., parce que le fichier gguf existant est trop diversifié.Donc n'écrivez pas une estimation régulière de ce qu'il y a dans le nom du fichier, lisez les métadonnées.Fichier general.basenameJe ne sais pas.general.size_labelJe ne sais pas.general.finetune C'est l'autorité.
V. Q4 K M: La partie la plus longue du nom du fichier est le taux de compression
C'est celui qui affecte le plus votre expérience en pratique, et celui que personne n'a précisé.Il indique la quantité de poids qui a été quantifiée.
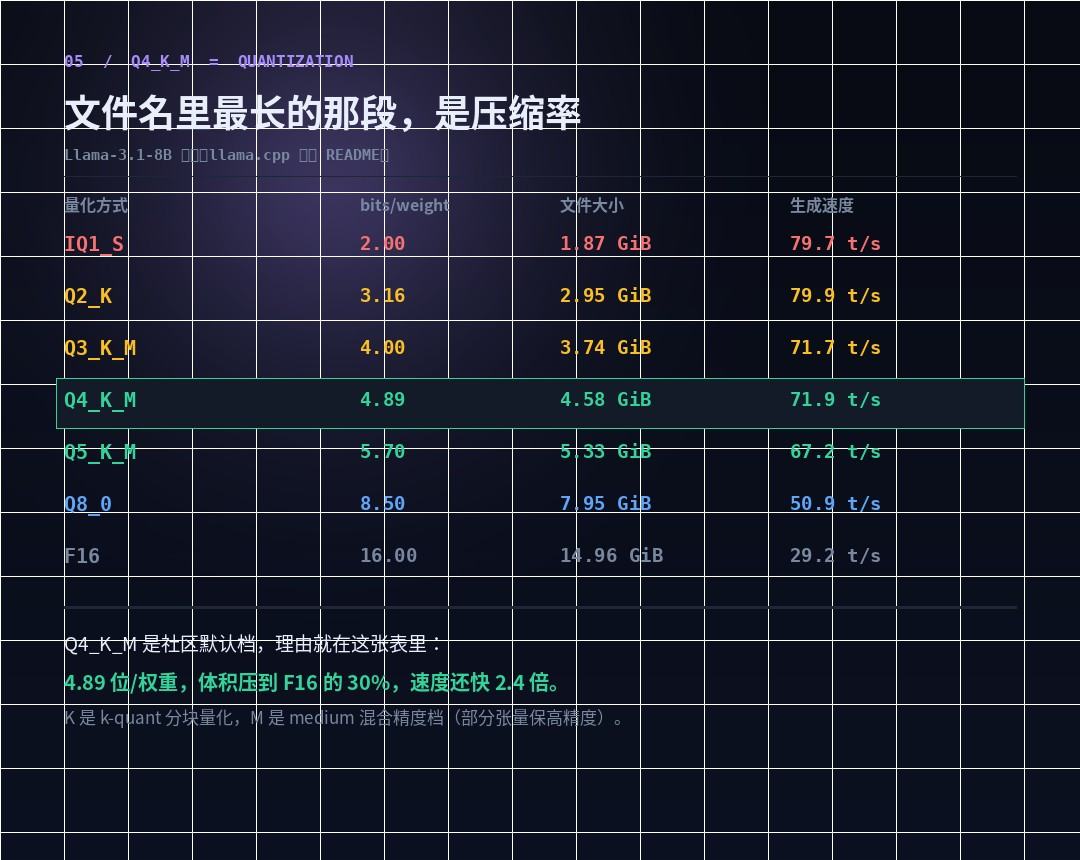
lama.cpp Official README a utilisé Llama-3.1-8B pour faire une enquête factuelle, et j'ai pris quelques étapes (modèle original 32.1 Go):
| Quantification | bits/droit | Taille du fichier | Générer la vitesse |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79,7 t/s |
| Q2 K | 3.16 | 2.95 GiB | 79,9 t/s |
| Q3 K M | 4.00 | 3.74 GiB | 71,7 t/s |
| T4 K M | 4.89 | 4.58 GiB | 71,9 t/s |
| T5 K M | 5.70 | 5,33 GiB | 67,2 t/s |
| Q8 0 | 8.50 | 7.95 GiB | 50,9 t/s |
| F16 | 16.00 | 14.96 GiB | 29,2 t/s |
Q4 K M devient le fichier par défaut de la communauté pour toutes les raisons de ce tableau :4.89 Bits/poids, avec un arriéré de 30% de F16, ce qui est 2,4 fois plus rapide.Jusqu'à Q8 0, le volume double et baisse de 30%, et la qualité change la plupart des gens ne savent pas; jusqu'à IQ1 S, le volume est un peu moins, et les risques de qualité sont beaucoup plus élevés.
Comment lisez-vous votre nom ?
- Reine = quantification régulière;IQ = La matrice de matérialité est quantifiée (i-quant), avec une meilleure qualité et une vitesse légèrement plus lente dans les mêmes chiffres.
- Nombres = chiffres cibles. Q4 est 4 bits, Q8 est 8 bits.
- K = k-quant, quantification par blocs (en blocs), plus ancienne
_0/_1La série est plus détaillée. - S/M/L = petite/média/grand, fente de précision mixte.M choisit certains des couvercles sensibles pour les garder hauts.Donc c'est aussi Q4, K M est un peu plus grand que K S.
Il y a un autre fait que beaucoup de gens ne savent pas:La quantification peut être personnalisée au cas par cas.Les outils officiels soutiennent la désignation de différents types par type, tels que: attn_v et ffn_down Définit séparément comme Q5 K M, tandis que le reste est maintenu comme Q4 K M; supporte également le réglage par un numéro de lot régulier. Et c'est pourquoi le même type de fichier "Q4 K M" est différent de la taille du fichier que les gens font pression.C'est une stratégie par défaut, pas une spécification précise.
VI. MTP: Un petit module appelé "Guess next word"
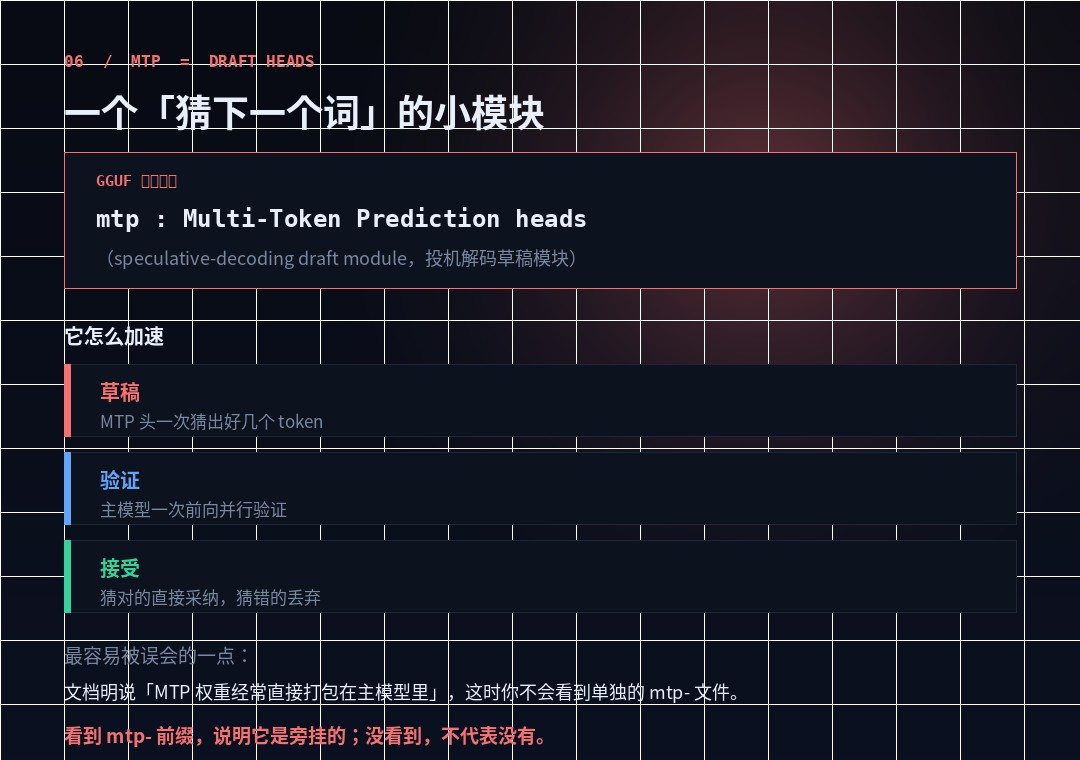
C'est le dernier qui est facile à utiliser comme modèle, en fait.Tag du rôle du fichierJe ne sais pas. Dans le document GFG mtp Définie comme sidecar (module accompagné), indiquant:
En-têtes de prédation multi-toké, module d'ébauche pour le décodeur spéculatif, conçu pour être chargé avec des modèles de base correspondant à l'architecture et aux versions.
C'est simple :Devinons les quelques jetons suivants, et laissons le modèle principal tourner en parallèle.Une bonne adoption directe, une mauvaise goutte. Parce que la vérification peut toujours confirmer plusieurs jetons, la baisse moyenne du temps par jeton -- c'est tout le principe du décodeur spéculatif.
Mais il y a une phrase dans le document qui doit être rappelée dans cette section:"Les poids MTP sont souvent emballés directement dans les modèles de base, auquel cas il n'y a pas de fichier mtp séparé".
Donc la bonne compréhension est:Oui. mtp- Préfixes, indiquant qu'ils sont à l'extérieur; aucun vu, ne signifie aucun.C'est pourquoi la recherche de MTP dans la liste de modèles n'est souvent pas trouvée -- elle est déjà dans le fichier principal.
L'autre Sidecar est... mmproj(projecteur multimodal, projecteur multimodulaire), encodeur visuel et audio plus couche de projection.Il s'agit généralement d'un document autonome qui doit être chargé avec un modèle de base.Donc, si vous posez un modèle multimode du GGF et que vous découvrez que vous ne pouvez pas voir la carte, il manque probablement le fichier mmproj.
VII. Lecture complète de cinq caractères
Tout ce qui précède est une lecture complète. Supposez que vous voyez ce nom de fichier :
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Extrait | C'est quel étage ? | Annotations |
|---|---|---|
mtp- | Rôle du fichier | Le module de décodeur spéculatif joint doit correspondre au modèle principal |
Qwen3 | Identité du modèle | Nom du modèle de base |
30B | Taille | Total du paramètre 30 milliards J'ai décidé de ne pas faire semblant. |
A3B | Calculer | Trois milliards de fois. Tu as décidé de courir quand ? |
v1.0 | Version | Version poids |
Q4_K_M | Stockage | 4.89 bits/poids, précision moyenne du mélange |
.gguf | Conteneurs | Pour lama.cpp. |
Un résumé du document:Un paramètre total de 30 milliards et un modèle MoE de 3 milliards à la fois ont été pressés à environ 4,9 places dans le conteneur GGUUF, avec un module d'accélération décodé spéculatif supplémentaire.
VIII. Quatre des erreurs les plus courantes
- Considérez A3B comme un modèle 3B.Ce n'est pas de la mémoire. 30B n'a pas moins de poids, et 4 Go est encore visible.
- E4B en tant que petit modèle 4B.C'est le plus grand ensemble de modèles élastiques. E4B contient tous les paramètres d'E2B. Low-fit sur elle appuyez sur 2B, pas 4B exécuter.
- Utiliser GGF comme modèle.Le même modèle peut être F16, Q8 0, Q4 K M plusieurs GGUUF.GGUF est un conteneur et la quantification est du contenu.Demander "Q4 et GGUF bon" c'est comme demander "La bouteille et l'eau bon."
- Ce billet fait partie de notre couverture spéciale Syrie Manifestations 2011.La déclaration officielle selon laquelle l'accord n'est pas entièrement lisible. N'écrivez pas la règle régulière pour accéder aux métadonnées du fichier avec des informations exactes.
Et il y a un cinquième caché :Mettre 8x7B Lire 7B.C'est "8 experts chaque 7B". Total 56B. Dans GGUF <expertCount>x<count> Le x est la multiplication.
IX. OBJET DES AJUSTEMENTS PRATIQUES
Enfin, donnez une séquence qui peut être suivie. Regardez tout nom de modèle et demandez-vous dans cet ordre:
- Regardez d'abord les conteneurs et quantifiez.
.gguf+Q4_K_MCela signifie qu'il s'agit d'une version de masse locale, et la qualité et le volume sont déjà définis au moment de la sortie. - Relisez les paramètres globaux.Décidez si votre présence/RAM est suffisante. C'est un seuil difficile. Ça ne suffit pas.
- Regarde si c'est Moe.Oui.
A??BLa description est basée sur les paramètres d'activation, mais la mémoire est toujours basée sur les paramètres totaux. - Voyez s'il y a un préfixe E.Oui.
ECela indique qu'il s'agit d'un modèle élastique et que la présence réelle peut être bien inférieure à la valeur nominale - cela détermine s'il peut accéder au téléphone cellulaire. - Dernier regard sur Sidecar.Oui.
mmproj-N'oubliez pas de vous réunir; oui.mtp-Rappelez-vous qu'il n'y a pas d'accélération.
Le nom de modèle n'est pas une table de paramètres, mais une étiquette. L'étiquette fonctionne pour vous tenir loin du prochain mauvais fichier, pas pour calculer sa partition.
Il court toujours. Mais pour lire correctement l'étiquette, au moins vous saurez avant de télécharger le 15 Go qu'il ne peut pas être installé...Cela a permis de gagner du temps, plus que n'importe quel score de référence.