
B, GGUF, MTP, A3B, E4B: De vijf tekens in de modelnaam, niet één. Ja.
Laten we beginnen met een conclusie die de helft van de verwarring redt:Deze vijf dingen zijn helemaal niet dezelfde dimensies.B is het woord, A3B en E4B is de "hoeveelheid," GGUF is de container, MTP is de plugin. In feite beantwoorden ze een heel andere vraag.
De specifieke arbeidsverdeling is als volgt:"B," "Hoe groot," "A3B," "Hoeveel werk," "E4B," "hoeveel zit er echt in het geheugen," "GGUF," "Wat zit er in," "MTP," "hoe versnelt het."Vier of vijf documenten verschijnen gelijktijdig omdat ze wel gelijktijdig moeten worden uitgedrukt, maar verwarring treedt vaak op wanneer ze als hetzelfde soort informatie worden behandeld.
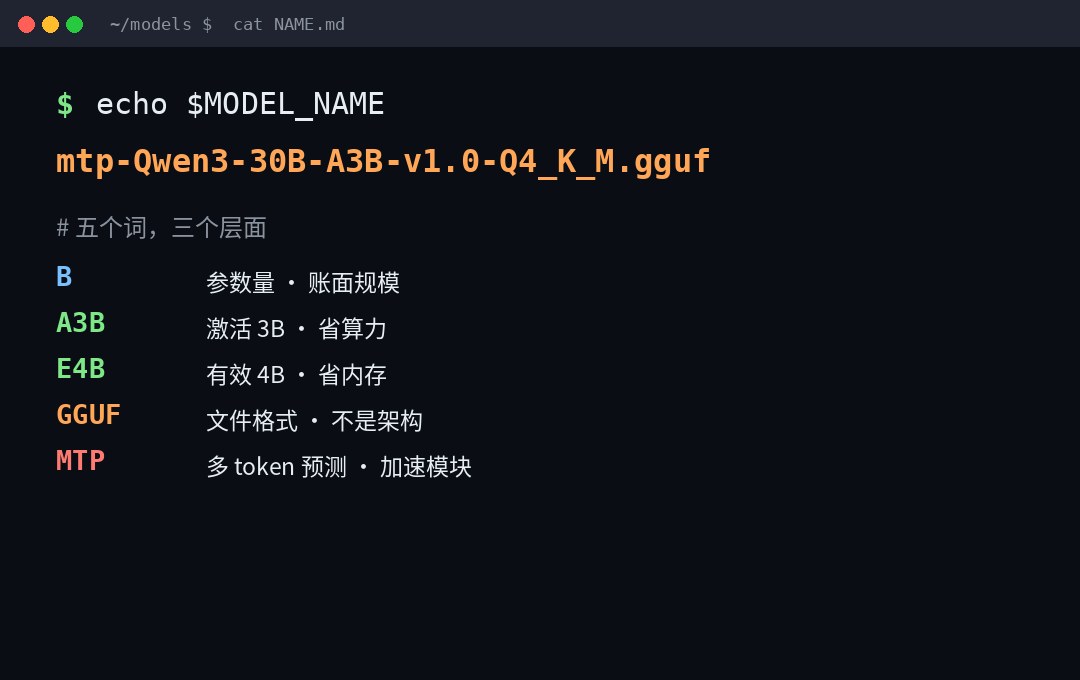
Eén, B: Het is maar een miljard.
B is miljard, een miljard.7B Het is een parameter van 7 miljard dollar.235B Dat is 235 miljard. Het is een set van schaal prefixes in de GGUF naam code:K DuizendenM Miljoenen,B Een miljard.T biljoenen dollars,Q Miljarden.
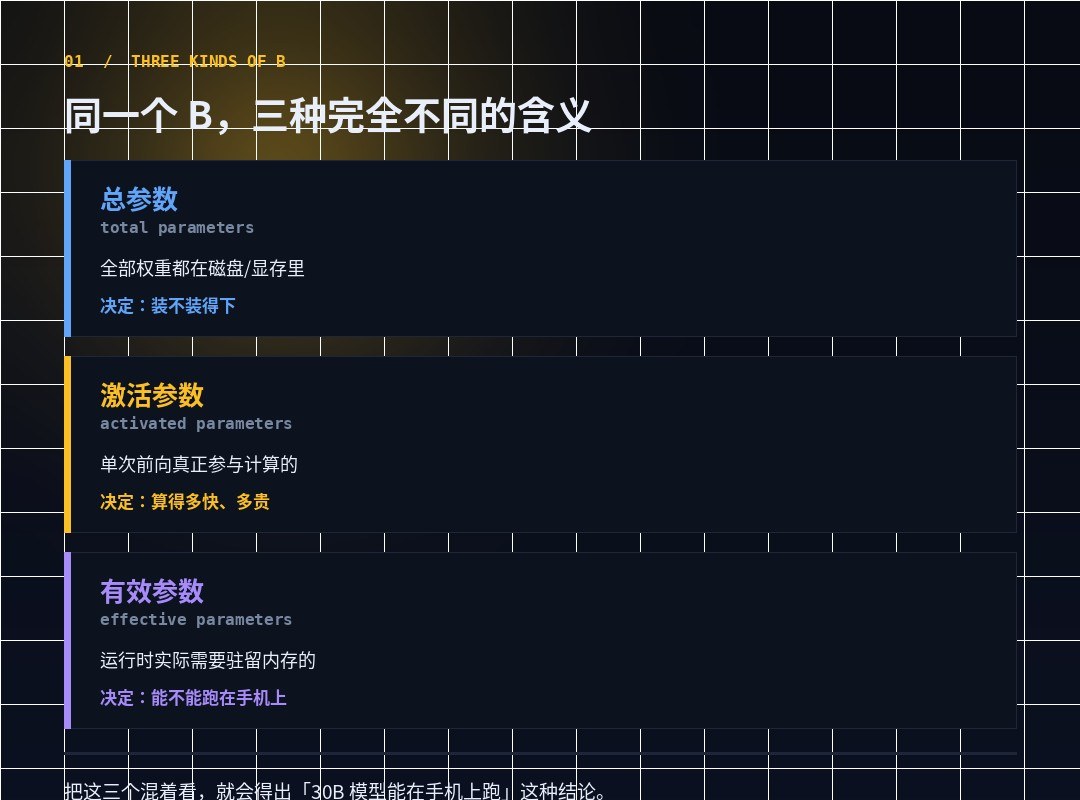
Het lijkt erop dat de eenvoudigste, eigenlijk drie compleet verschillende betekenissen heeft. Dit is het eerste dat duidelijk moet zijn:
| Schrijven | Betekenis | Wat beslissen? |
|---|---|---|
30B | Totale parameters: volledig gewicht | Kun je het spelen?(schijf, zichtbaar) |
30B-A3B | Totaal 30B, enkele activering 3B | Hoe snel? Hoe duur? |
E4B | Geldige parameters: werkelijke aanwezigheid op het tijdstip van gebruik | Kun je even bellen? |
Als je deze drie lijnen samen bekijkt, krijg je de conclusie dat het 30B model kan draaien op een mobiele telefoon.Het is misschien goed, maar het is niet hetzelfde als de 30B die je dacht dat het was.
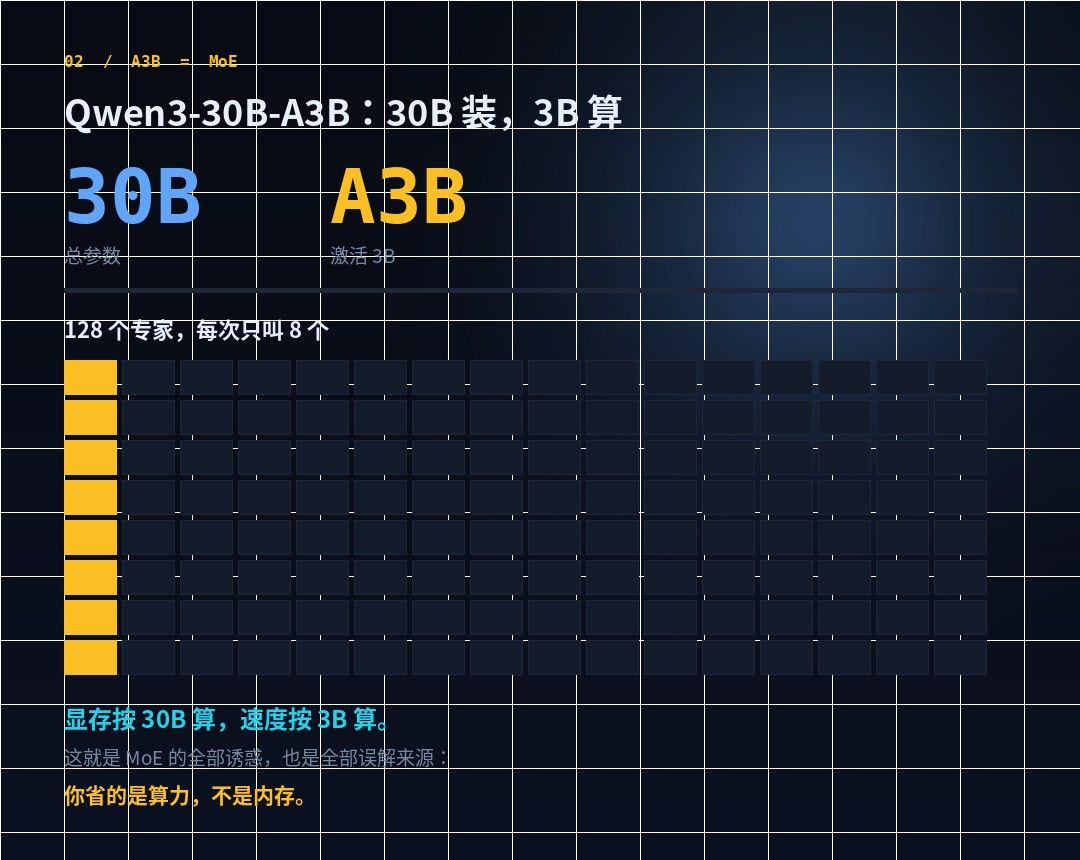
II. A3B: Algemene parameters en activeringsparameters zijn niet één keer Ja.
Dit is van MoE. Qwen3 is heel duidelijk over de namen van de modellen:Qwen3-235B-A22B is een groot model van "233,5 miljard in totaal parameters, 22 miljard geactiveerde parameters" en Qwen3-30B-A3B is een klein MoE van "30 miljard in totaal parameters, 3 miljard geactiveerde parameters."
Technische details zijn ook specifiek: 30B-A3B heeft 48 verdiepingen, Q/KV hoofdtelling 32/48 van 128 specialisten geactiveerd, context 128K. 235B-A22B is 94e verdieping, 64/4 hoofd, ook 128 experts geactiveerd 8.
Dus, A3B, de werkelijke betekenis van dit teken is:Toont 30B, snelheid 3B.
Dat is alle verleiding van MoE, alle bronnen van misverstand.Je bespaart geld, geen geheugen.Veel mensen zien A3B en denken dat het een 3B model is, geladen op een 4GB machine, en vinden het dan onmogelijk om te laden. Geen van de gewichten zijn klein, maar niet alle vooruitberekeningen.
Samen met een gemakkelijk te negeren schrijven: SizeLabel van GGF is <expertCount>x<count><scale-prefix>* And so * 8x7B Dit heet "8 experts x 7B," voor een totaal van 56B.Dat is ofwel een vermenigvuldiging of een vermenigvuldiging.Mixtral-8x7B wordt vaak verkeerd geïnterpreteerd als een "7B model" en de werkelijke totale parameter is 56B.
III. E4B:E is positief, niet "kleiner"
Dit is een van de makkelijkste om volledig te lezen. Het document van Gemma 3n is duidelijk:
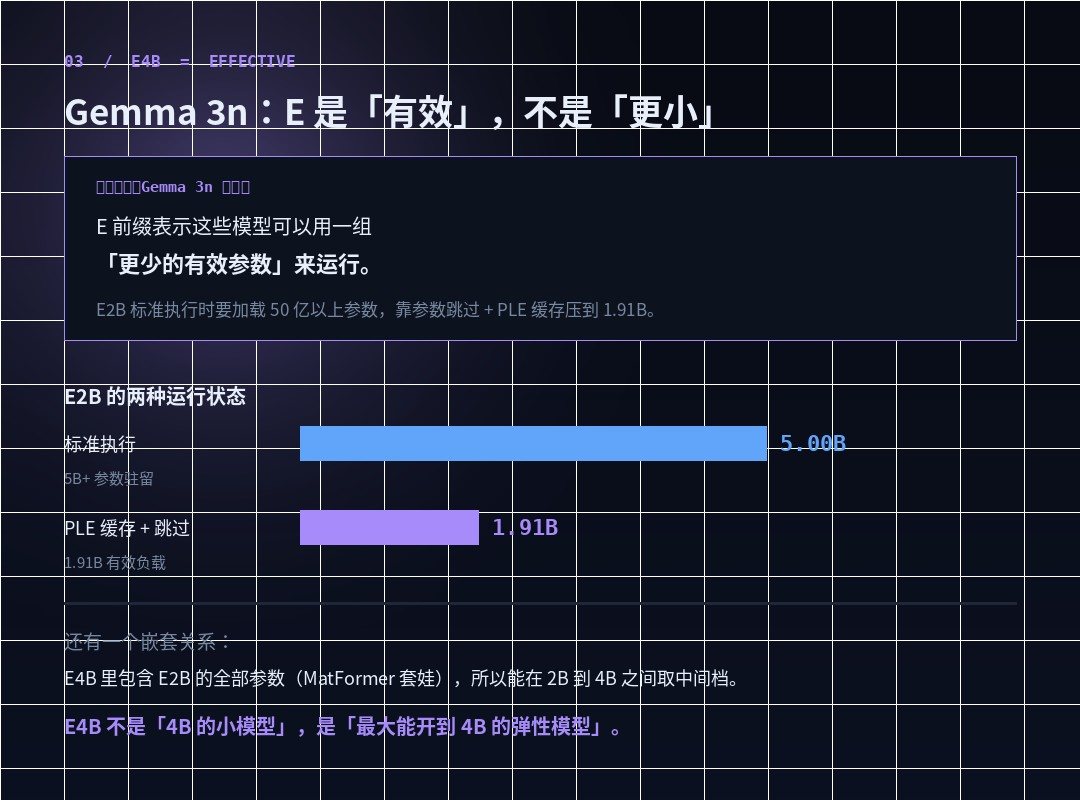
Parametermarkeringen voor het Gemma 3n model (bv. E2B, E4B)Minder danHet totale aantal parameters dat daadwerkelijk in het model is opgenomen. E-prefix geeft aan dat deze modellen kunnen worden uitgevoerd met een set van "minder actieve parameters."
In welke mate? Het document bevat het nummer:E2B standaarden worden geïmplementeerd door het laden van meer dan 5 miljard parameters, overslaan en PLE caches door parameters om de actieve geheugenbelasting op 1.91B te drukken.
Let op de belangrijkste woorden van deze zin:Het model zelf is niet kleiner geworden, het is kleiner geworden in termen van zijn aanwezigheid tijdens het draaien.
Dit kan worden bereikt door twee mechanismen:
- PLE Cache (Per-Layer Embeding).Elke laag embedded parameters kan gescheiden van het modelgeheugen worden gegenereerd, naar een snelle lokale opslag worden gecached en bij het draaien aan elke laag worden toegevoegd.Dit is gelijk aan dit deel van de parameter uit het geheugen vragen.
- MatFormer.Er zijn verschillende kleine modellen ingebed in een groot model, die niet hoeven te activeren buitenparameters wanneer afgeleid. Dus je kunt elk midden nemen tussen 2B en 4B.
Dit leidt tot een contra-intuïtief feit:E4B bevat alle E2B parameters.Niet twee stand-alone modellen, twee slots voor hetzelfde elastisch model. De exacte term is dus niet "E4B is een 4B klein model" maar "E4B."E4B is een elastisch model met maximaal vermogen tot 4B.Ik ga nergens heen.
Dit heeft een grote impact op het oordeel dat "kan ik lopen op mijn apparatuur":E4B kan E2B-achtig draaien op apparatuur met weinig apparatuur en uitbreiden naar 4B op apparatuur met hoge apparatuur.En A3B heeft deze elasticiteit niet -- het is 30B, het is gewoon kostenbesparend.
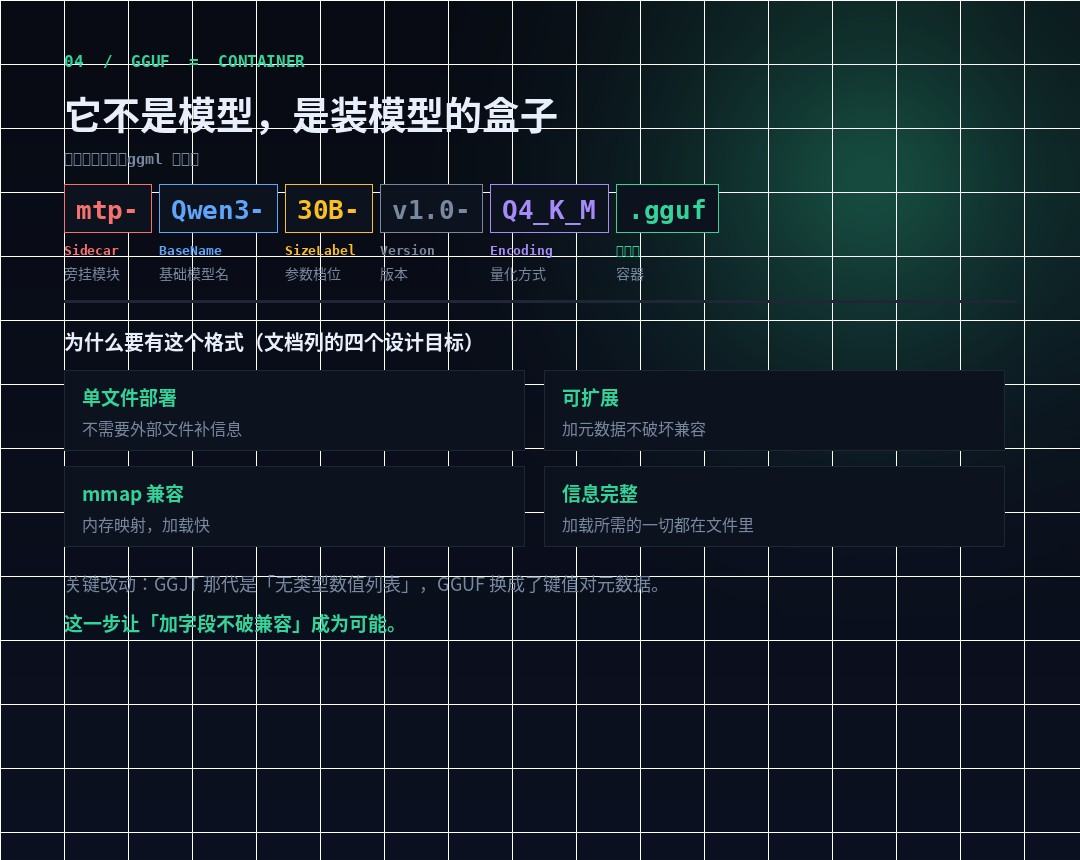
Het is geen model, het is een modeldoos.
De eerste drie zijn de grootte van het model, dat de afmetingen van GGUF heeft veranderd:Dit is het bestandsformaat.Om precies te zijn, GGUUF is een model opslag formaat voor GGML en de implementer (llama.cpp).
Het vervangt GGML, GGMF, GGJT, drie generaties formaat. De officiële ontwerpdoelen zijn vier, elk komt overeen met een verleden pijnpunt:
| Ontwerpdoelstellingen | Omgaan met wat? |
|---|---|
| Uitrol van één bestand | Geen aanvullende documentatie vereist, directe distributie en lading |
| Uitbreidbaar | Het toevoegen van nieuwe metagegevens ondermijnt de compatibiliteit van oude modellen niet |
mmap Verenigbaarheid | Geheugenkaart laden, snel |
| Volledige informatie | Alles wat je moet laden staat in het bestand. Gebruikers hoeven het niet te leveren. |
Het belangrijkste verschil tussen het en de laatste generatie van GGJT is slechts één zin, maar het is de sleutel:De hyperparameter wordt gewijzigd van een lijst van waarden zonder type naar een sleutel naar metagegevens.Deze stap maakte het mogelijk om "toevoegen veldcompatibiliteit" . . Nadat een veld was toegevoegd, moesten alle oude oplossers worden gewijzigd.
Hoe heb je het gespeld?
De officiële naamcode is:
[].ggufNeem een echt voorbeeld.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (regelmodule, zie volgende sectie)Qwen3→ Basisnaam (basismodelnaam)27B→ SizeLabel (parameter slot)v1.0Versie (versie)Q4_K_MCodering (gewichtscodering/kwantificatie)
Er zijn twee componenten die niet vaak bekend lijken te zijn:
- Type.:
LoRAHet betekent dat het een adapter is, geen compleet model;vocabgeeft het woordenschatbestand aan. - Shad.:
00003-of-00009Toont de breuk, 3e van 9 Attentie.Nummering begint op 00001Niet 00000.
Er is ook een belangrijke disclaimer in de norm:Het heet "niet volledig ontcijferbaar in het wild.", omdat het bestaande gguf bestand te divers is.Dus schrijf geen regelmatige gok op wat er in de bestandsnaam staat, lees metadata.Bestand general.basenameIk weet het niet.general.size_labelIk weet het niet.general.finetune Het is gezag.
V. Q4 K M: Het langste deel van de bestandsnaam is de compressiesnelheid
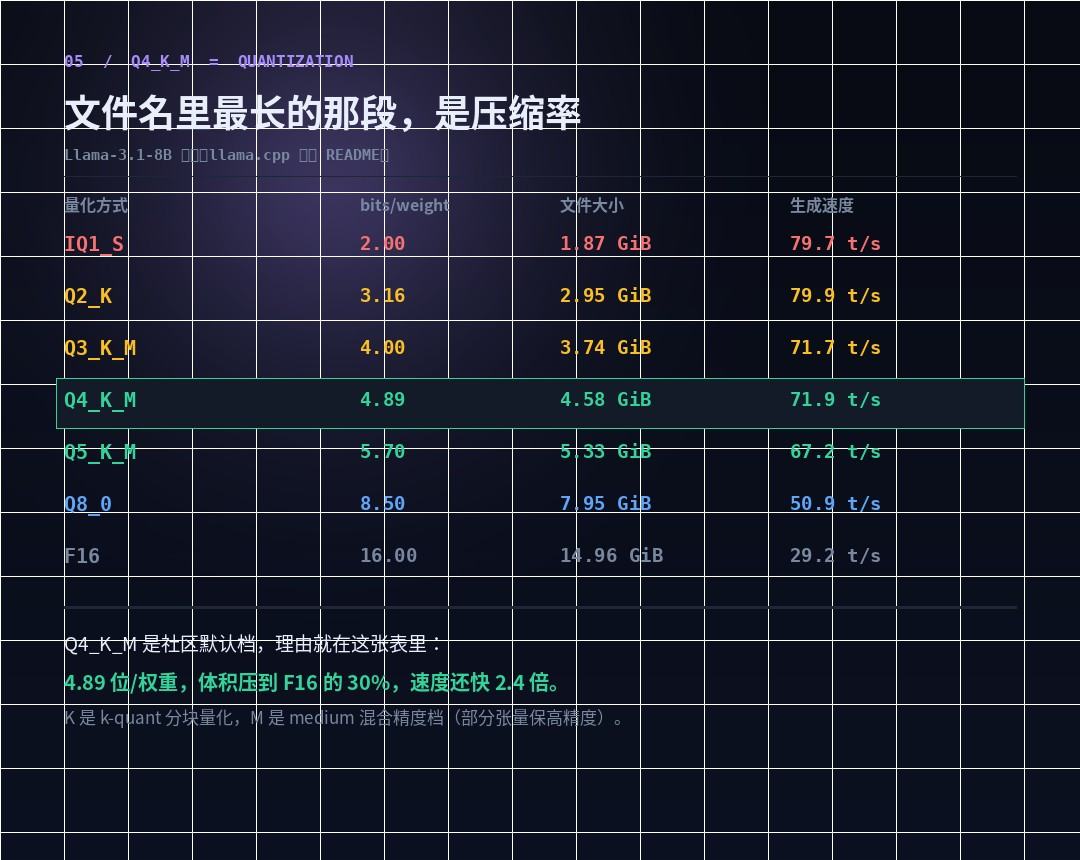
Dit is degene die het meest van invloed is op jullie ervaring in de praktijk, en degene die niemand duidelijk heeft gemaakt.Het geeft aan hoeveel gewicht is gekwantificeerd.
lama.cpp Officiële README gebruikt Llama-3.1-8B om een feitelijke enquête te maken, en ik nam een paar stappen (origineel model 32.1 GB):
| Kwantificering | bits/rechts | Bestandsgrootte | Snelheid genereren |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79,7 t/s |
| Q2 K | 3.16 | 2,95 GiB | 79,9 t/s |
| Q3 K M | 4.00 | 3,74 GiB | 71,7 t/s |
| Q4 K M | 4.89 | 4.58 GiB | 71,9 t/s |
| Q5 K M | 5.70 | 5.33 GiB | 67,2 t/s |
| Q8 0 | 8.50 | 7.95 GiB | 50,9 t/s |
| F16 | 16.00 | 14.96 GiB | 29,2 t/s |
Q4 K M wordt het standaard bestand van de gemeenschap om alle redenen in deze tabel:4,89 Bits/gewichten, met een achterstand van 30% van F16, wat 2,4 keer sneller is.Tot Q8 0, het volume verdubbelt en daalt met 30%, en de kwaliteit verandert de meeste mensen niet weten; tot aan IQ1 S, het volume is een beetje minder, en de kwaliteit risico's zijn veel hoger.
Hoe lees je je naam?
- Koningin = regelmatige kwantificering;IQ = De materialiteitsmatrix is gekwantificeerd (i-quant), met betere kwaliteit en iets langzamere snelheid in dezelfde cijfers.
- Getallen = doelcijfers. Q4 is 4 bit, Q8 is 8 bit.
- K = k-quant, blokkwantificatie (bloksgewijs), ouder
_0/_1De serie is gedetailleerder. - S / M / L = kleine/media/grote, gemengde precisiesleuf.M kiest een aantal gevoelige deksels om ze hoog te houden.Dus het is ook Q4, K M is iets groter dan K S.
Er is nog een feit dat veel mensen niet weten:Kwantificatie kan per geval worden aangepast.Officiële instrumenten ondersteunen de aanwijzing van verschillende typen per type, zoals: attn_v en ffn_down Stelt apart in als Q5 K M, terwijl de rest wordt onderhouden als Q4 K M; ondersteunt ook het instellen door een regelmatig batchnummer. En dat is waarom hetzelfde "Q4 K M" bestandstype verschilt van de grootte van het bestand dat mensen onder druk zetten.Het is een standaardstrategie, geen precieze specificatie.
VI. MTP: Een kleine module genaamd "Volgende woord raden"
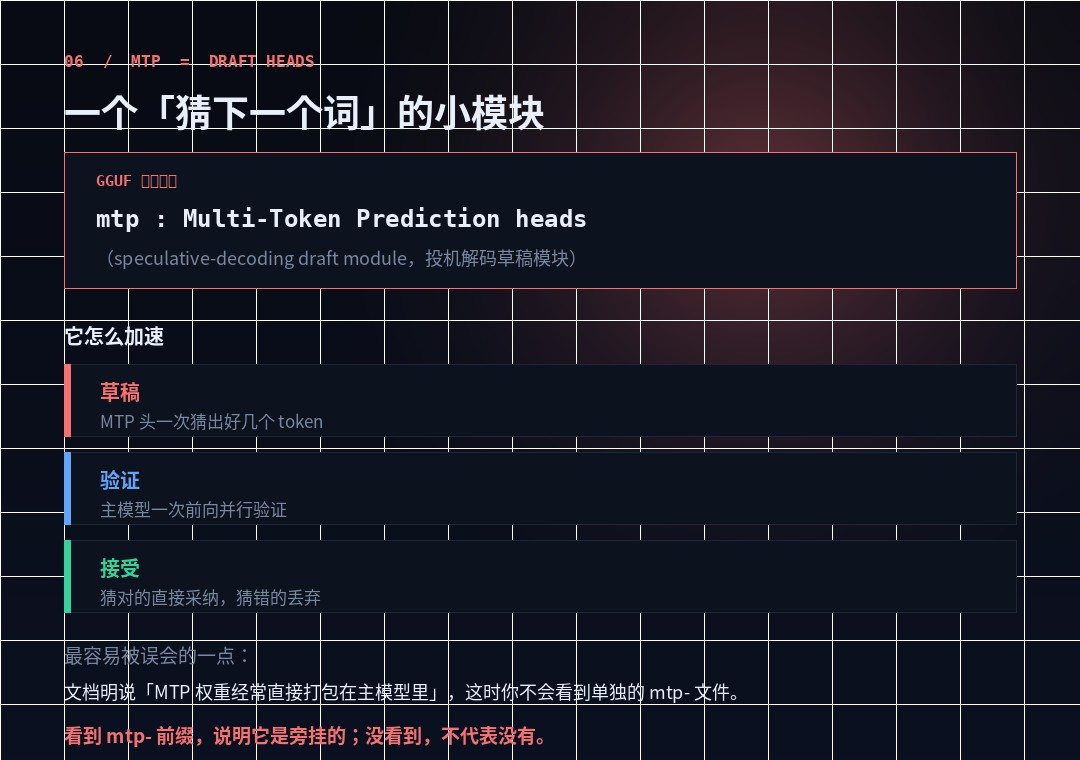
Het is de laatste die makkelijk te gebruiken is als model.Bestandsrol-tagIk weet het niet. In het GGF-document mtp Gedefinieerd als Sidecar (begeleide module), met vermelding van:
Multi-Token Predation Headers, ontwerpmodule voor speculatieve decodering, ontworpen om te worden geladen met basismodellen die overeenkomen met architectuur en versies.
Het is simpel:Laten we de volgende paar tokens raden, en laat het hoofdmodel parallel lopen.Rechter directe adoptie, verkeerde drop. Omdat verificatie altijd meerdere tokens kan bevestigen, de gemiddelde daling in tijd per token -- dit is het hele principe van speculatieve decodering.
Maar er is een zin in het document die het meest herinnerd moet worden in deze sectie:"MTP-gewichten worden vaak direct verpakt in basismodellen, in welk geval er geen apart mtp-side bestand is."
Dus het juiste begrip is:Ja. mtp- Voorvoegsels, die aangeven dat ze aan de buitenkant; geen gezien, betekent geen.Daarom wordt het zoeken naar MTP in de modellijst vaak niet gevonden -- het staat al in het hoofdbestand.
De andere Sidecar is... mmproj(multimodale projector, multimodulaire projector), visuele en audio-encoder plus projectielaag.Dit is meestal een op zichzelf staand document dat geladen moet worden met een basismodel.Dus als je een multi-mode model van de GGF neerzet en erachter komt dat je de kaart niet kunt zien, mist het waarschijnlijk het mmproj bestand.
VII. Volledige lezing van vijf tekens
Al het bovenstaande is een volledige lezing. Stel dat je deze bestandsnaam ziet:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Snippet | Welke verdieping is het? | Annotaties |
|---|---|---|
mtp- | Bestandsrol | De bijgevoegde speculatieve decodering module moet overeenkomen met het hoofdmodel |
Qwen3 | Modelidentiteit | Basismodelnaam |
30B | Grootte | Totaal parameter 30 miljard Ik heb besloten niet te doen alsof. |
A3B | Bereken | Drie miljard per keer. Hoe snel heb je besloten te rennen? |
v1.0 | Versie | Gewichtsversie |
Q4_K_M | Opslag | 4,89 bits/gewicht, gemiddelde mengsel precisie |
.gguf | Containers | Op lama.cpp. |
Een samenvatting van het document:Een totale parameter van 30 miljard en een MoE model van 3 miljard tegelijk werd tot ongeveer 4,9 plaatsen in de GGUUF container gedrukt, met een extra speculatieve decodeerde versnellingsmodule.
VIII. Vier van de meest voorkomende fouten
- Zie A3B als een 3B model.Het is geen herinnering. 30B heeft niet minder gewicht, en 4GB is nog steeds zichtbaar.
- E4B als "4B klein model."Het is de grootste set elastische modellen. E4B bevat alle parameters van E2B. Low-fit erop drukt 2B, niet 4B run.
- Gebruik GGF als model.Hetzelfde model kan F16, Q8 0, Q4 K M verschillende GGUUFs zijn.GGUF is een container en kwantificering is inhoud.Vragen "Q4 en GGUF goed" is als vragen "De fles en het water goed."
- Dit artikel maakt deel uit van onze speciale berichtgeving over de protesten in Syrië 2011.De officiële verklaring dat de overeenkomst niet volledig leesbaar is. Schrijf niet de reguliere regel om toegang te krijgen tot de metagegevens van het bestand met nauwkeurige informatie.
En er is een verborgen vijfde:Plaats 8x7B Lees 7B.Dat is "8 experts elk 7B." Totaal 56B. In GGUF <expertCount>x<count> De x is de vermenigvuldiging.
IX. DOEL VAN PRAKTISCHE AANPASSINGEN
Tot slot, geef een volgorde die kan worden gevolgd. Kijk naar elke modelnaam en vraag jezelf af in deze volgorde:
- Eerst kijken naar containers en kwantificeren.
.gguf+Q4_K_MDit betekent dat het een lokale run-off massa versie, en de kwaliteit en het volume zijn al ingesteld op het moment van release. - Lees de algemene parameters nog eens.Bepaal of uw aanwezigheid/RAM voldoende is. Het is een harde drempel. Het is niet genoeg.
- Kijk of het Moe is.Ja.
A??BBeschrijving is gebaseerd op activeringsparameters, maar geheugen is nog steeds gebaseerd op totale parameters. - Kijk of er een E voorvoegsel is.Ja.
EDit geeft aan dat het een elastisch model is en dat de werkelijke aanwezigheid ver onder de nominale waarde kan liggen - dit bepaalt of het toegang heeft tot de mobiele telefoon. - Laatste blik op Sidecar.Ja.
mmproj-Vergeet niet om samen te komen, ja.mtp-Vergeet niet matching; ook betekent het niet dat er geen versnelling.
Modelnaam is geen parametertabel, maar een label. Het label werkt om je weg te houden van het volgende verkeerde bestand, niet om de score te berekenen.
Hij loopt altijd. Maar om het label goed te lezen, weet je tenminste voordat je de 15-GB downloadt dat het niet geïnstalleerd kan worden...Dit bespaarde tijd, meer dan enige benchmark score.