
B, GGUF, MTP, A3B, E4B: I cinque personaggi nel nome del modello, non uno. Si'.
Cominciamo con una conclusione che salva la metà della confusione:Queste cinque cose non sono affatto le stesse dimensioni.B è la parola, A3B e E4B è la "quantità", GGUF è il contenitore, MTP è il plugin. Infatti, rispondono a una domanda completamente diversa.
La divisione specifica del lavoro è la seguente:"B", "Quanto grande", "A3B", "Quanto lavoro", "E4B", "quanto è veramente nella memoria", "GGUF", "Cosa c'è dentro", "MTP", "come accelera".Quattro o cinque documenti appaiono simultaneamente perché devono essere espressi simultaneamente - ma la confusione spesso si verifica quando vengono trattati come lo stesso tipo di informazioni.
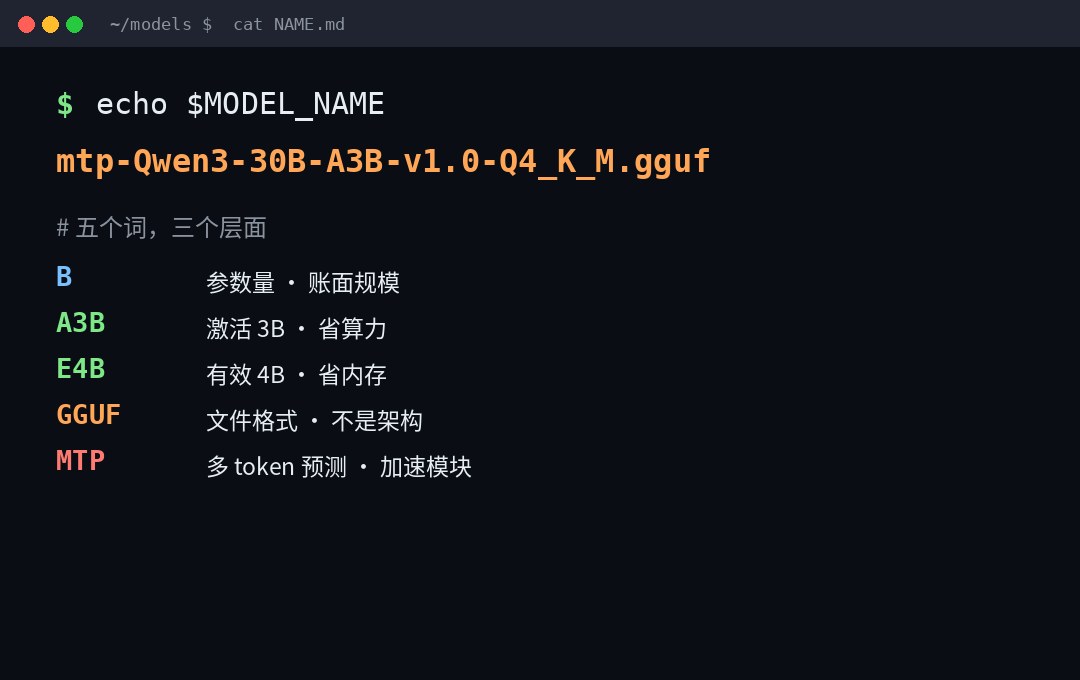
Uno, B: E' solo un miliardo.
B è Billion, un miliardo.7B E' un parametro da 7 miliardi di dollari.235B Sono 235 miliardi. È un insieme di prefissi in scala nel codice nome GGUF:K MigliaiaM Milioni,B Un miliardo.T trilioni di dollari,Q Miliardi.
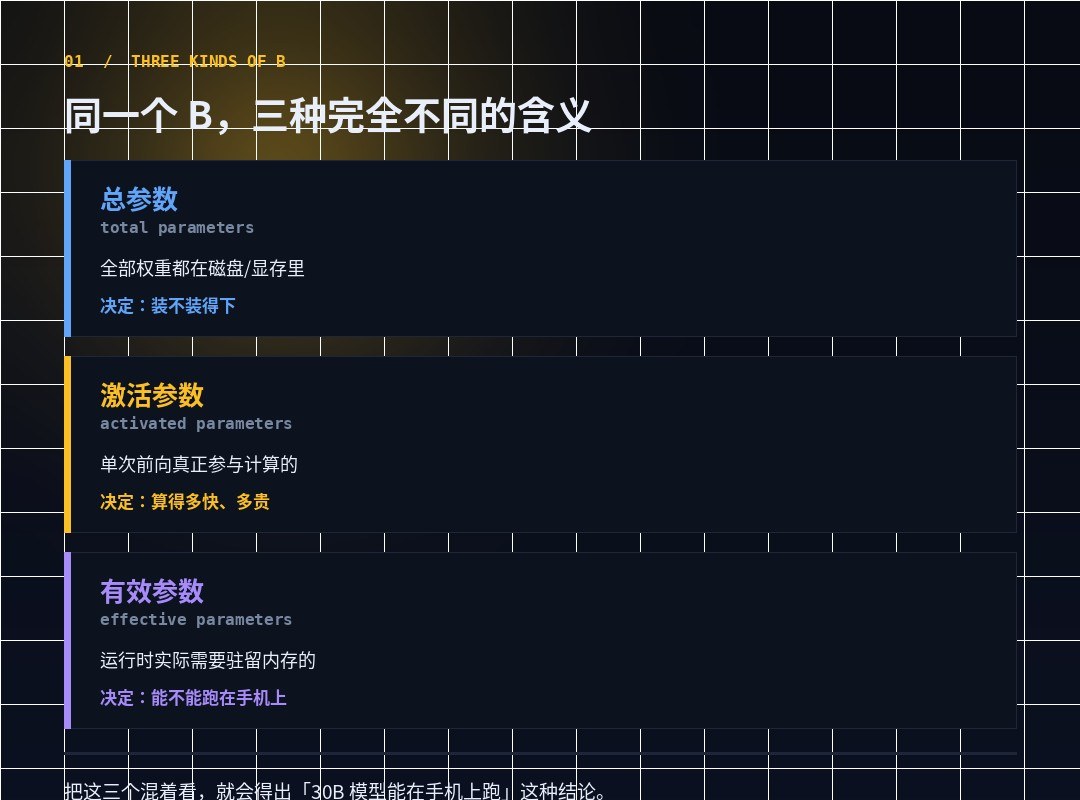
Sembra la più semplice, in realtà ha tre significati completamente diversi. Questa è la prima cosa che dovrebbe essere chiara:
| Scrivere | Significato | Decidi cosa? |
|---|---|---|
30B | Parametri generali: pieno peso | Puoi suonarlo?(disco, visibile) |
30B-A3B | Totale 30B, attivazione singola 3B | Quanto velocemente? Quanto costa? |
E4B | Parametri validi: presenza effettiva al momento del funzionamento | Puoi andare al telefono? |
Se guardate queste tre linee insieme, otterrete la conclusione che il modello 30B può essere eseguito su un telefono cellulare.Potrebbe essere giusto, ma non e' lo stesso del 30B che pensavi fosse.
II. A3B: I parametri generali e i parametri di attivazione non sono una volta Sì.
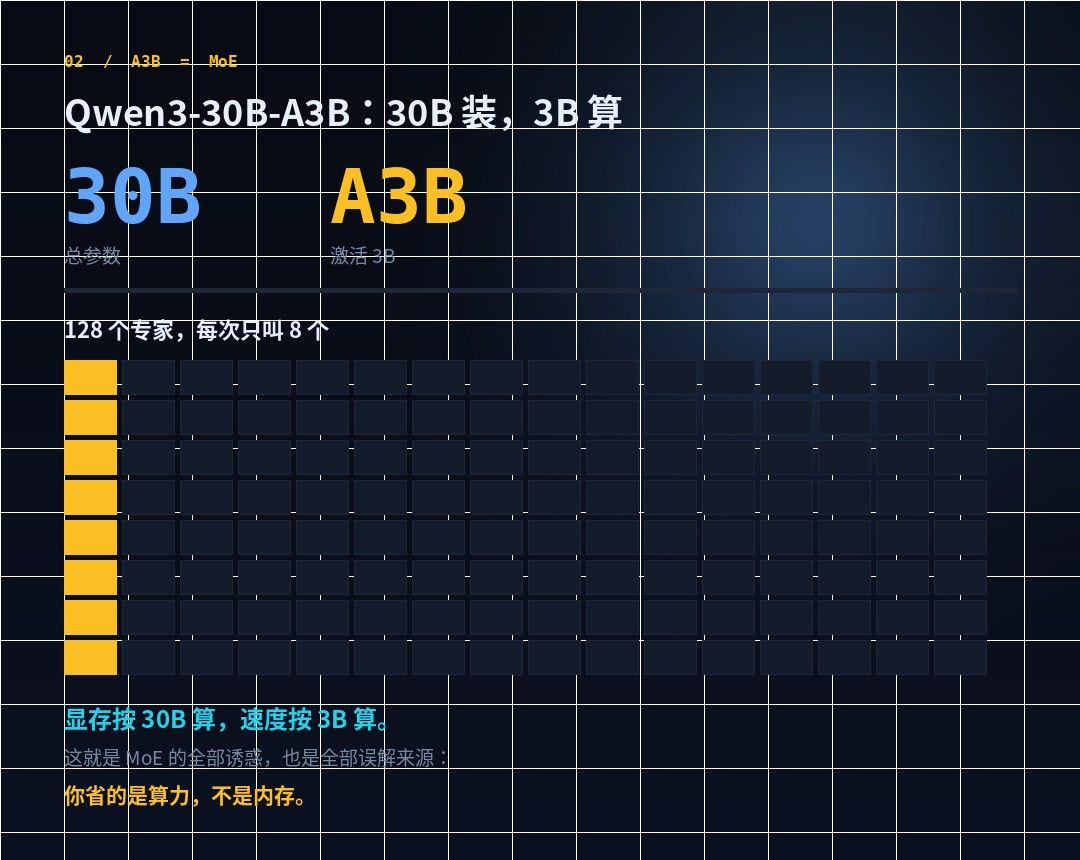
Questo è da MoE. Qwen3 è molto chiaro sui nomi dei modelli:Qwen3-235B-A22B è un grande modello di "233,5 miliardi di parametri totali, 22 miliardi di parametri attivati", e Qwen3-30B-A3B è un piccolo MoE di "30 miliardi di parametri totali, 3 miliardi di parametri attivati".
Dettagli tecnici sono anche specifici: 30B-A3B ha 48 piani, Q/KV testa conta 32/48 di 128 specialisti attivati, contesto 128K. 235B-A22B è 94 ° piano, 64/4 testa, anche 128 esperti attivato 8.
Quindi, A3B, il significato effettivo di questo marchio è:Visualizza 30B, velocità 3B.
E' tutta la tentazione di MoE, tutte le fonti di malinteso.Stai risparmiando soldi, non memoria.Molte persone vedono A3B e pensano che sia un modello 3B, caricato su una macchina da 4 GB, e poi trovano impossibile caricare. Nessuno dei pesi è piccolo, ma non tutti i calcoli in avanti.
Insieme a una scrittura facile da ignorare: SizeLabel di GGF è <expertCount>x<count><scale-prefix># And so # 8x7B Questo è chiamato "8 esperti x 7B", per un totale di 56B.O un'ellissi di moltiplicazione o una moltiplicazione.Mixtral-8x7B è spesso interpretato male come un "modello 7B" e il parametro totale effettivo è 56B.
III. E4B:E è efficace, non "più piccolo"
Questo è uno dei più facili da leggere completamente. Il documento di Gemma 3n è chiaro:
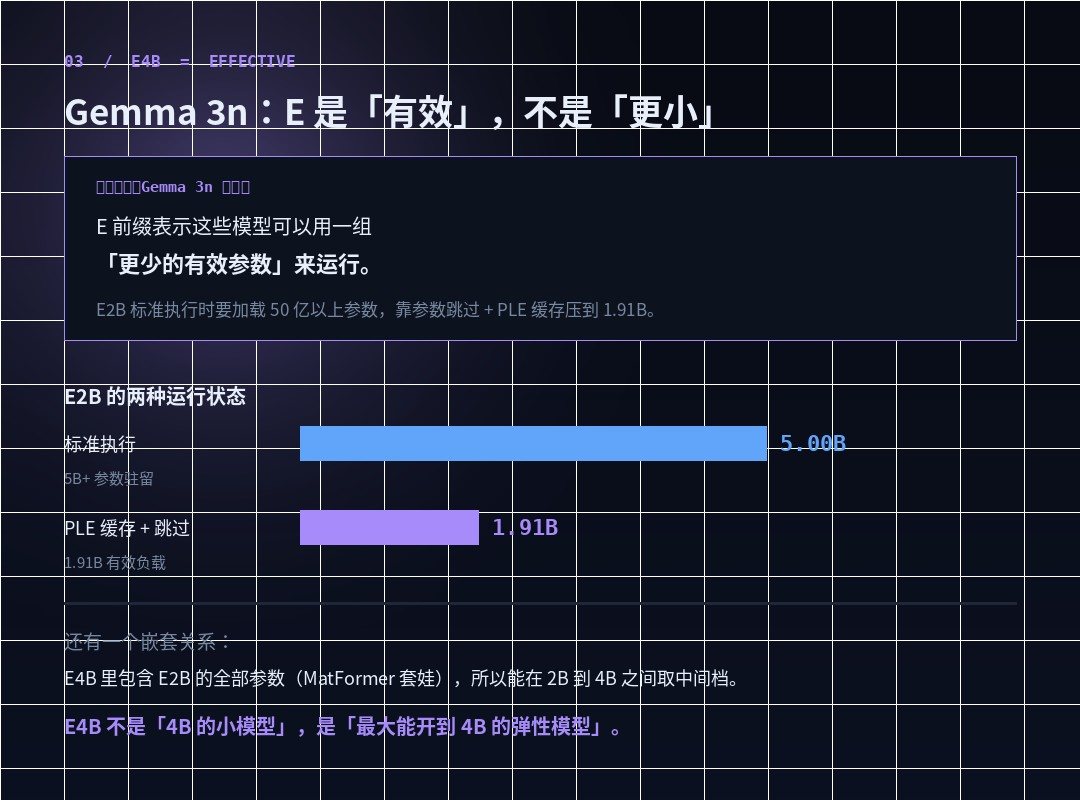
Parametri per il modello Gemma 3n (es. E2B, E4B)Meno diLa quantità totale di parametri effettivamente inclusi nel modello. E prefix indica che questi modelli possono essere eseguiti con un insieme di "meno parametri attivi".
In che misura? Il documento dà il numero:Gli standard E2B vengono implementati caricando più di 5 miliardi di parametri, saltando e PLE cache per parametri per premere il carico di memoria attivo a 1.91B.
Notare le parole principali di questa frase:Il modello stesso non è diventato più piccolo, è diventato più piccolo in termini di presenza durante la corsa.
Questo può essere raggiunto attraverso due meccanismi:
- PLE Cache (Per-Layer Embeding).Ogni strato di parametri incorporati può essere generato separatamente dalla memoria del modello, memorizzato in una memorizzazione locale veloce, e aggiunto a ogni strato durante l'esecuzione.Questo è uguale a chiedere questa parte del parametro fuori della memoria.
- MatFormer.Ci sono diversi piccoli modelli incorporati all'interno di un grande modello, che non hanno bisogno di attivare i parametri esterni quando dedotto. Così si può prendere qualsiasi mezzo tra 2B e 4B.
Questo porta ad un fatto controintuitivo:E4B contiene tutti i parametri E2B.Non due modelli stand-alone, due slot per lo stesso modello elastico. Quindi il termine esatto non è "E4B è un piccolo modello 4B" ma "E4B".E4B è un modello elastico con potenza massima che va a 4B.Non e' che vado da nessuna parte.
Questo ha un grande impatto sul giudizio che "può correre sulla mia attrezzatura":E4B può eseguire E2B-come su apparecchiature a basso rendimento e espandersi a 4B su apparecchiature ad alto rendimento.E l'A3B non ha questa elasticità, è 30B, è solo economico.
IV. GGUUF: Non è un modello, è una scatola modello.
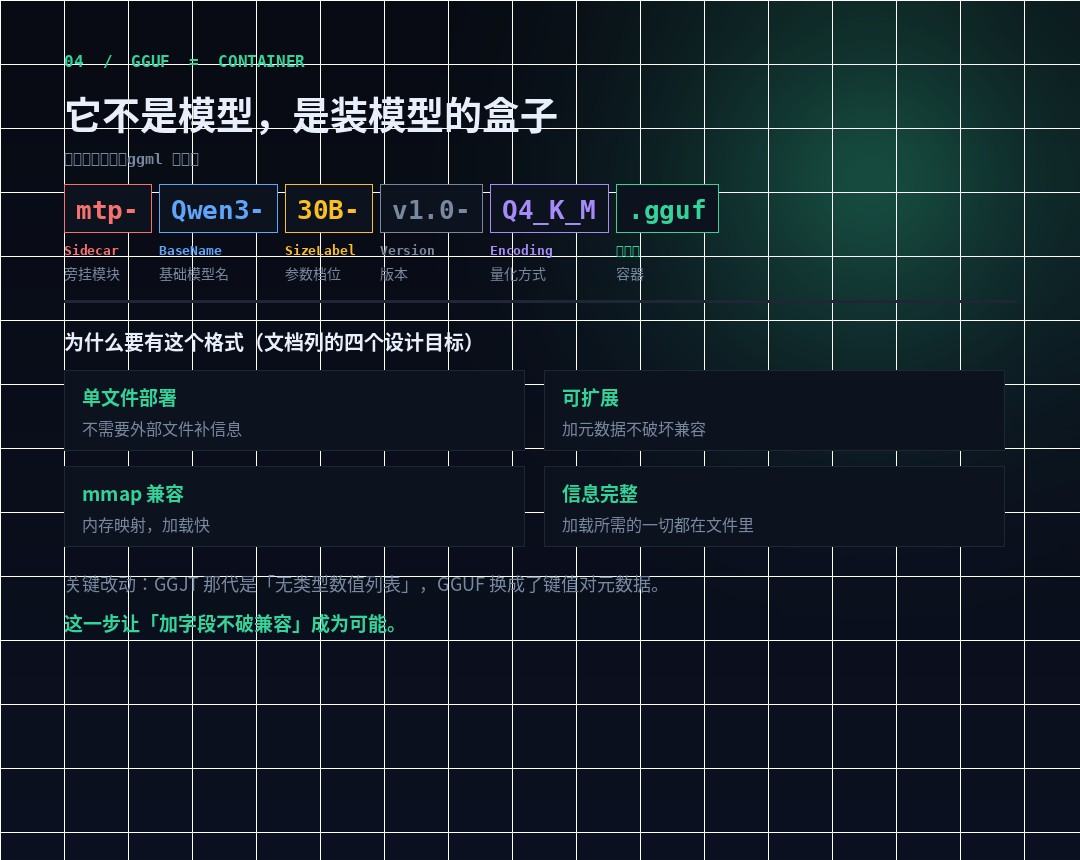
Le prime tre sono le dimensioni del modello, che ha cambiato le dimensioni da GGUF:Questo è il formato del file.Per essere precisi, GGUUF è un formato di archiviazione modello per GGML e il suo implementatore (llama.cpp).
Sostituisce GGML, GGMF, GGJT, formato di tre generazioni. Gli obiettivi di design ufficiali sono quattro, ciascuno dei quali corrisponde ad un punto di dolore passato:
| Obiettivi di progettazione | A che fare? |
|---|---|
| Distribuzione di file singolo | Nessuna documentazione aggiuntiva richiesta, distribuzione diretta e carico |
| Espandibili | L'aggiunta di nuovi metadati non mina la compatibilità di vecchi modelli |
mmap Compatibilità | Caricamento della mappa di memoria, veloce |
| Informazioni complete | Tutto quello che devi caricare è nel file. Gli utenti non devono fornirlo. |
La differenza chiave tra esso e l'ultima generazione di GGJT è solo una frase, ma è la chiave:L'iperparametro è cambiato da un elenco di valori senza tipo a una chiave per i metadati.Questo passo ha permesso di "aggiungere l'incompatibilità del campo" — una volta che un campo era stato aggiunto, tutti i vecchi risolutori dovevano essere cambiati.
Come l'hai scritto?
Il nome ufficiale è:
[].ggufFai un esempio vero.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (modulo byline, vedi sezione successiva)Qwen3→ BaseName (nome modello base)27B→ SizeLabel (soggiorno dei parametri)v1.0Versione (versione)Q4_K_MCodifica (codifica del peso/ quantificazione)
Ci sono due componenti che non sembrano spesso essere noti:
- Tipo.:
LoRASignifica che è un adattatore, non un modello completo;vocabindica il file del vocabolario. - Shad.:
00003-of-00009Mostra la frazione, 3° di 9 Attenzione.Numerazione inizia a 00001Non 00000.
C'è anche un importante disclaimer nella norma:Si chiama "non sarà completamente decifrabile in natura"., perché il file gguf esistente è troppo vario.Quindi non scrivere un'ipotesi regolare di quello che c'è nel nome del file, leggere i metadati.File general.basenameNon lo so.general.size_labelNon lo so.general.finetune E' autorità.
V. Q4 K M: La parte più lunga del nome del file è la velocità di compressione
Questo è quello che più colpisce la vostra esperienza nella pratica, e quello che nessuno ha chiarito.Indica quanto peso è stato quantificati.
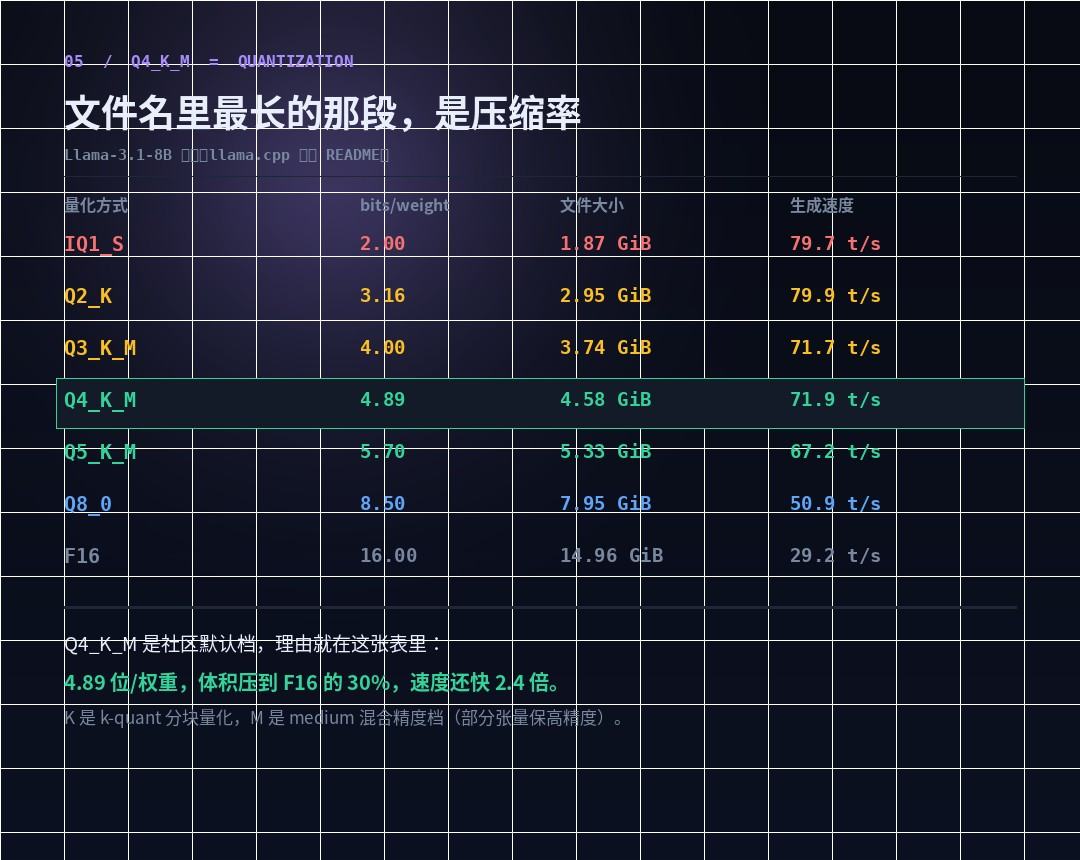
llama.cpp Official README ha usato Llama-3.1-8B per fare un sondaggio di fatto, e ho fatto un paio di passi (modello originale 32.1 GB):
| Quantificazione | bit/destra | Dimensione del file | Generare velocità |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79.7 t/s |
| Q2 K | 3.16 | 2.95 GiB | 79.9 t/s |
| Q3 K M | 4.00 | 3.74 GiB | 71.7 t/ |
| Q4 K M | 4.89 | 4.58 GiB | 71.9 t/ |
| Q5 K M | 5.70 | 5.33 GiB | 67,2 t/s |
| Q8 0 | 8.50 | 7.95 GiB | 50.9 t/s |
| F16 | 16.00 | 14.96 GiB | 29.2 t/s |
Q4 K M diventa il file predefinito per tutte le ragioni di questa tabella:4.89 Bits/pesi, con un backlog del 30% di F16, che è 2.4 volte più veloce.Fino a Q8 0, il volume raddoppia e scende del 30%, e la qualità cambia la maggior parte delle persone non sanno; fino a IQ1 S, il volume è un po 'meno, e i rischi di qualità sono molto più elevati.
Come si legge il suo nome?
- Regina = quantificazione regolare;IQ = La matrice di materialità è quantificata (i-quant), con una migliore qualità e una velocità leggermente più lenta nelle stesse cifre.
- Numeri = cifre di destinazione. Q4 è 4 bit, Q8 è 8 bit.
- K = k-quant, blocco di quantificazione (block-wise), maggiore
_0/_1La serie è più dettagliata. - S / M / L = piccolo/media/grande, slot di precisione misto.M sceglie alcuni dei coperchi sensibili per tenerli alti.Quindi è anche Q4, K M è leggermente più grande di K S.
C'è un altro fatto che molte persone non sanno:La quantificazione può essere personalizzata caso per caso.Gli strumenti ufficiali supportano la designazione di diversi tipi per tipo, come: attn_v e ffn_down Imposta separatamente come Q5 K M, mentre il resto viene mantenuto come Q4 K M; supporta anche l'impostazione di un numero di lotto regolare. Ed è per questo che lo stesso tipo di file "Q4 K M" è diverso dalla dimensione del file che la gente pressione.È una strategia di default, non una specifica precisa.
VI. MTP: Un piccolo modulo chiamato "Guess next word"
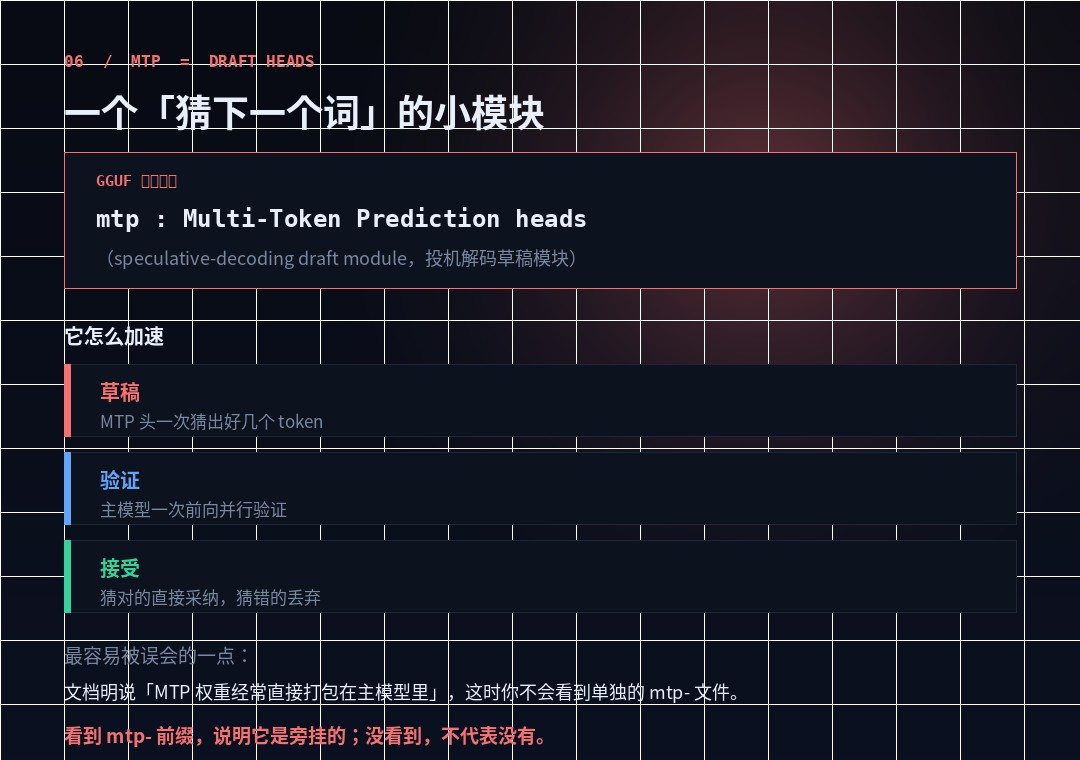
È l'ultimo che è facile da usare come modello, in realtà.File Role TagNon lo so. Nel documento GGF mtp Definito come Sidecar (modulo accompagnato), dichiara:
Multi-Token Predation Headers, modulo di bozza per decodering speculativo, progettato per essere caricato con modelli base che corrispondono architettura e versioni.
È semplice:Supponiamo i prossimi gettoni, e lasciamo correre il modello principale in parallelo.Adozione diretta, goccia sbagliata. Poiché la verifica può sempre confermare più gettoni, il calo medio del tempo per token -- questo è l'intero principio di decodering speculativo.
Ma c'è una frase nel documento che dovrebbe essere più ricordato in questa sezione:"I pesi MTP sono spesso imballati direttamente in modelli di base, in tal caso non c'è nessun file di lato mtp separato".
Quindi la corretta comprensione è:Si'. mtp- Prefissi, indicando che sono all'esterno; nessuno visto, non significa nessuno.Ecco perché cercare MTP nella lista dei modelli non è spesso trovato -- è già nel file principale.
L'altro Sidecar è... mmproj(proiettore multimodulare, proiettore multimodulare), encoder visivo e audio più strato di proiezione.Questo è di solito un documento stand-alone che deve essere caricato con un modello di base.Quindi, se metti giù un modello multi-mode del GGF e scopri che non puoi vedere la mappa, probabilmente manca il file mmproj.
VII. Lettura completa di cinque caratteri
Tutto quanto sopra è una lettura completa. Supponiamo di vedere questo nome di file:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Snippet | Che piano e'? | Annunci |
|---|---|---|
mtp- | File Role | Il modulo di decodifica speculativa allegato deve corrispondere al modello principale |
Qwen3 | Modello identità | Nome del modello di base |
30B | Dimensione | Parametro totale 30 miliardi Ho deciso di non fingere. |
A3B | Calcola | Tre miliardi alla volta. Quanto hai deciso di correre? |
v1.0 | Versione | Versione del peso |
Q4_K_M | Stoccaggio | 4.89 bit/peso, precisione media miscela |
.gguf | Contenitori | A llama.cpp. |
Riepilogo del documento:Un parametro totale di 30 miliardi e un modello MoE di 3 miliardi alla volta è stato premuto a circa 4,9 posti nel contenitore GGUUF, con un modulo di accelerazione decodificato speculativo aggiuntivo.
VIII. Quattro dei più comuni errori
- Considerare A3B come un modello 3B.Non e' memoria. 30B non ha meno peso, e 4GB è ancora visibile.
- E4B come "modello 4B piccolo".È il più grande insieme di modelli elastici. E4B contiene tutti i parametri di E2B. Low-fit su di esso preme 2B, non corsa 4B.
- Utilizzare GGF come modello.Lo stesso modello può essere F16, Q8 0, Q4 K M diversi GGUUF.GGUF è un contenitore e la quantificazione è contenuto.Chiedere "Q4 e GGUF buono" è come chiedere "La bottiglia e l'acqua buona".
- Questo post fa parte della nostra copertura speciale Siria Protests 2011.La dichiarazione ufficiale che l'accordo non è del tutto leggibile. Non scrivere la regola regolare per accedere ai metadati del file con informazioni accurate.
E c'e' un quinto nascosto:Puttana 8x7B Leggi 7B.Sono 8 esperti ogni 7B. Totale 56B. In GGUF <expertCount>x<count> La x è la moltiplicazione.
IX. PURPOSE DI ADESIONI PRATICHE
Infine, dare una sequenza che puÃ2 essere seguita. Guarda qualsiasi nome modello e chiediti in questo ordine:
- Prima guardare i contenitori e quantificare.
.gguf+Q4_K_MCiò significa che si tratta di una versione di massa di run-off locale, e la qualità e il volume sono già impostati al momento del rilascio. - Leggi di nuovo i parametri generali.Decidi se la tua presenza/RAM è sufficiente. E' una soglia difficile. Non basta.
- Vedi se è Moe.Si'.
A??BLa descrizione si basa sui parametri di attivazione, ma la memoria è ancora basata su parametri totali. - Vedi se c'è un prefisso E.Si'.
ECiò indica che è un modello elastico e che la presenza effettiva può essere ben al di sotto del valore nominale - questo determina se può accedere al telefono cellulare. - Ultimo sguardo al Sidecar.Si'.
mmproj-Ricordatevi di riunirvi; sì.mtp-Ricorda la corrispondenza; né significa che non c'è accelerazione.
Il nome del modello non è una tabella dei parametri, ma un'etichetta. L'etichetta funziona per tenerti lontano dal prossimo file sbagliato, per non calcolare il suo punteggio.
Sta sempre correndo. Ma per leggere correttamente l'etichetta, almeno saprai prima di scaricare il 15-GB che non può essere installato...Questo tempo salvato, più di qualsiasi punteggio di benchmark.