
B, GGUF, MTP, A3B, E4B : 모델 이름의 다섯 문자, 아무도. 예.
혼란의 절반을 저장하는 결론을 가진 시작하자:이 다섯 가지는 모든 동일한 차원에서 아닙니다.B는 단어, A3B 및 E4B는 "quantity", GGUF는 컨테이너이며 MTP는 플러그인입니다. 사실, 그들은 완전히 다른 질문에 응답.
labour의 특정 부서는 다음과 같습니다."B," "어떻게 큰,"A3B," "어떻게 일,"E4B," "어떻게 메모리에서 정말,"GGUF," "무엇에서," "MTP," "어떻게 가속."4개 또는 5개의 문서는 동시에 표현될 필요가 있기 때문에 나타날 것입니다 — 그러나 혼란은 수시로 동일한 유형의 정보로 대우될 때 발생합니다.
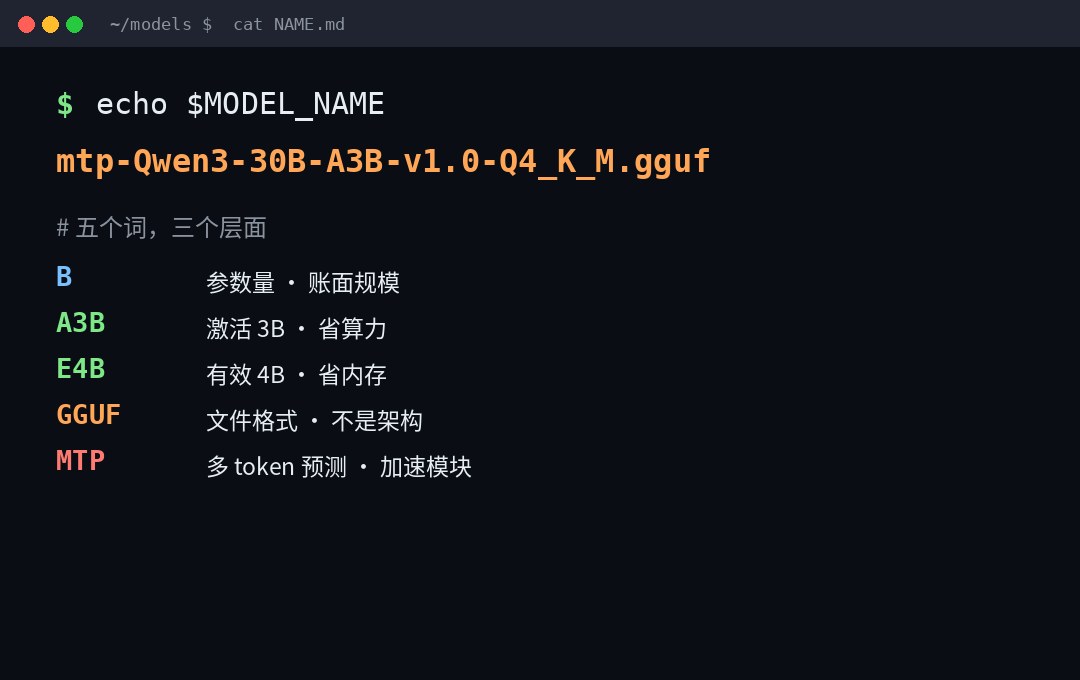
1, B : 불과 10 억입니다.
B는 억, 억.7B 그것은 7 억 달러의 매개 변수입니다.235B 즉 235 억입니다. GGUF 이름 코드의 스케일 접두사 세트입니다.K 한국어M 수백만,B 1 억.T 수백만 달러,Q 계정 관리
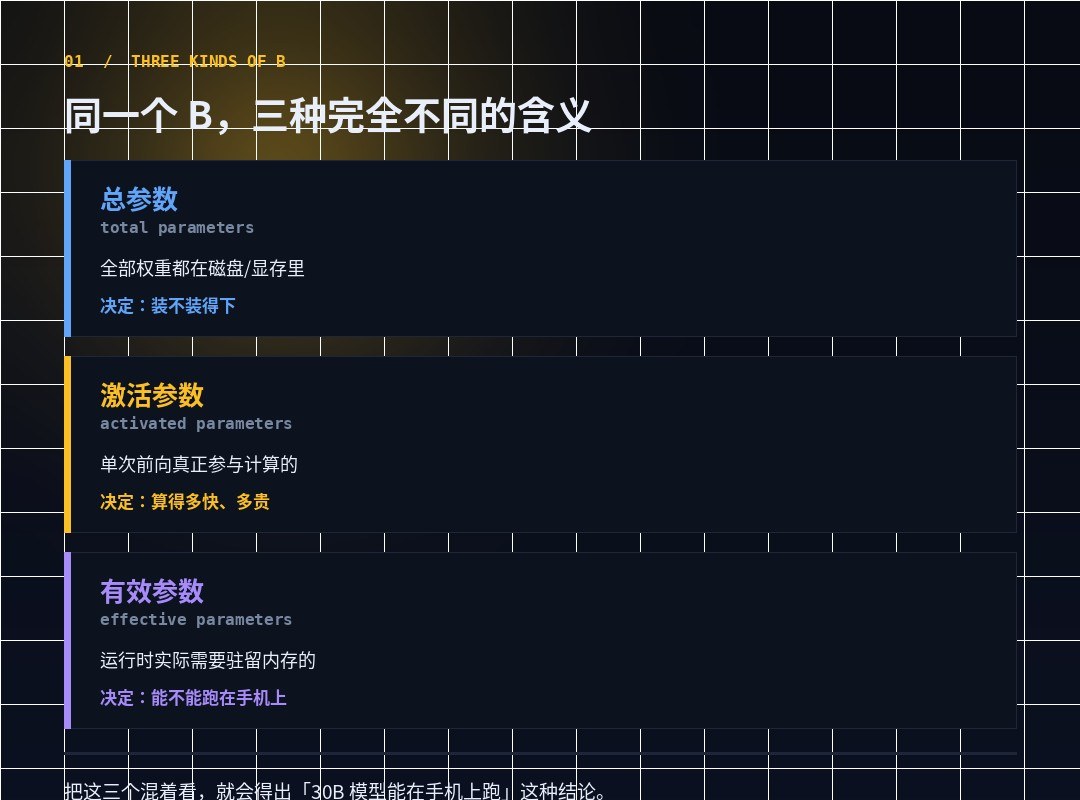
가장 간단한 것 처럼 보이는, 실제로 세 가지 완전히 다른 의미. 이것은 분명해야 첫 번째 일입니다:
| 한국어 | 이름 * | 무엇을 결정합니까? |
|---|---|---|
30B | 전반적인 모수: 가득 차있는 무게 | 당신은 그것을 할 수 있습니까?(disk, 가시) |
30B-A3B | 총 30B, 단일 활성화 3B | 빠른 방법? 비싼? |
E4B | 유효한 모수: 가동의 시간에 실제적인 존재 | 휴대폰에서 실행할 수 있습니까? |
이 세 줄을 함께 살펴보면 30B 모델이 휴대폰에서 실행할 수 있다는 결론을 얻을 수 있습니다.그것은 맞을 수 있지만 30B와 동일하지 않습니다.
II. A3B: 일반적인 모수 및 활성화 모수는 한 번 그렇습니다 아닙니다.
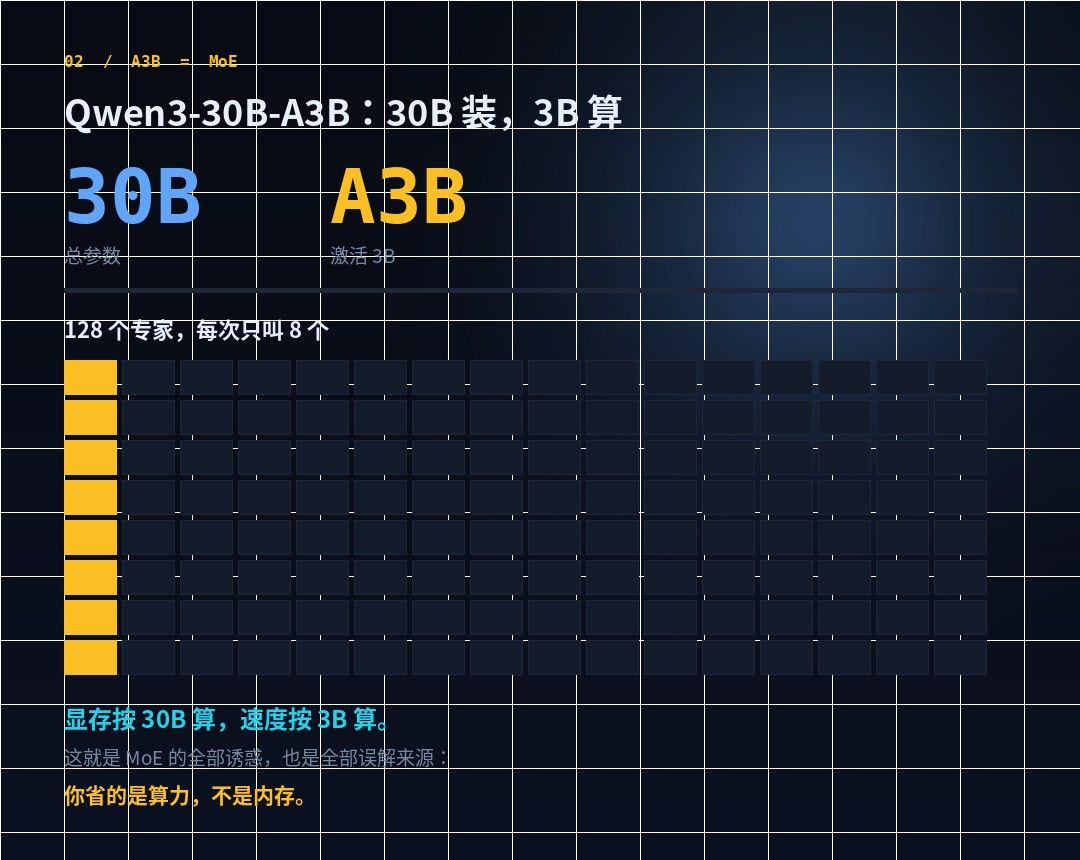
이것은 MoE에서입니다. Qwen3는 모델의 이름에 대해 매우 분명합니다.Qwen3-235B-A22B는 "233.5 억 총 매개 변수, 22 억 활성화 된 매개 변수", Qwen3-30B-A3B의 큰 모델입니다 "30 억 총 매개 변수, 3 억 활성화 된 매개 변수".
기술적인 세부사항은 또한 특정합니다: 30B-A3B에는 48 지면, Q/KV 머리 조사 32/4가 있습니다8 의 128 전문가 활성화, 맥락 128K. 235B-A22B는 94 층, 64/4 머리, 또한 128명의 전문가 활성화된 8.입니다
그래서, A3B,이 마크의 실제 의미는:전시 30B의 속도 3B.
그것은 모의 모든 유혹, 모든 오해의 소스입니다.당신은 돈을 저축하고, 기억하지 않습니다.많은 사람들이 A3B를보고 3B 모델이라고 생각하고 4GB 기계에로드 한 다음로드 할 수 없습니다. 무게의 아무도 작지만, 앞으로의 계산은 전혀 없습니다.
쓰기를 무시하기 쉽습니다 : GGF의 SizeLabel는 <expertCount>x<count><scale-prefix>♪ 그래서 ♪ 8x7B 이것은 56B의 합계를 위한 "8명의 전문가 x 7B"로 불립니다.즉, ellipsis 또는 곱셈입니다.Mixtral-8x7B는 종종 "7B 모델"으로 잘못 해석되며 실제 총 매개 변수는 56B입니다.
III. E4B: E는 effictive, 아닙니다 “smaller”입니다
이것은 완전히 읽는 가장 쉬운 중 하나입니다. Gemma 3n의 문서는 명확합니다:
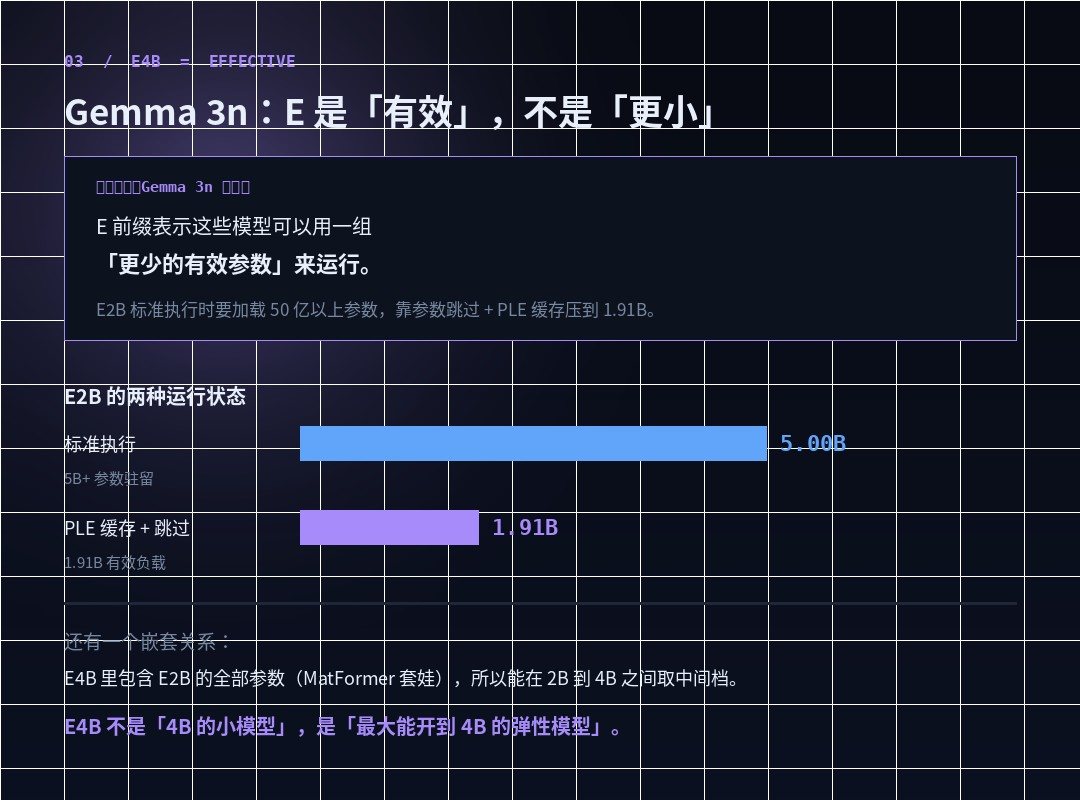
Gemma 3n 모델의 매개 변수 표시 (예 : E2B, E4B)더 적은 보다는모델에 포함 된 매개 변수의 총 금액. E 접두사는 이 모델이 "무작성 매개 변수" 세트로 실행 될 수 있음을 나타냅니다.
어떤 정도? 문서는 번호를 제공합니다:E2B 표준은 5 억 개 이상의 매개 변수를로드하여 구현되며 매개 변수에 의해 PLE 캐시가 1.91B로 활성 메모리로드를 누릅니다.
이 문장의 주요 단어를 참고:모델 자체는 작아지지 않았습니다. 실행 중에 존재의 측면에서 작아졌습니다.
이것은 2개의 기계장치를 통해서 달성될 수 있습니다:
- PLE 캐시 (Per-Layer Embeding).임베디드 매개변수의 각 층은 모형 기억에서 따로따로 생성될 수 있고, 빠른 국부적으로 저장에, 그리고 각 층에 달리기 때 추가했습니다.이것은 메모리에서 매개 변수의이 부분을 묻는 것과 같습니다.
- MatFormer.대형 모델에 내장 된 몇 가지 작은 모델이 있습니다. 따라서 당신은 2B와 4B 사이 어떤 중간든지 가지고 갈 수 있습니다.
이것은 합리적 사실로 이어진다:E4B는 모든 E2B 모수를 포함합니다.2개의 독립 모형이 아닙니다, 동일한 탄력 있는 모형을 위한 2개의 구멍. 그래서 정확한 용어는 "E4B는 4B 작은 모델입니다"하지만 "E4B."E4B는 최대 힘으로 4B로 가는 탄력 있는 모형입니다.어디로 가고 싶지 않습니다.
이것은 "내 장비에서 실행할 수있는 판단에 큰 영향을줍니다":E4B는 낮은 장비에 E2B 같이 실행할 수 있고 4B에 높은 장비에 확장합니다.그리고 A3B는 이 신축성이 없습니다 -- 그것은 30B, 그것입니다 다만 비용 절약입니다.
IV. GGUUF: 그것은 모형 아닙니다, 모형 상자입니다.
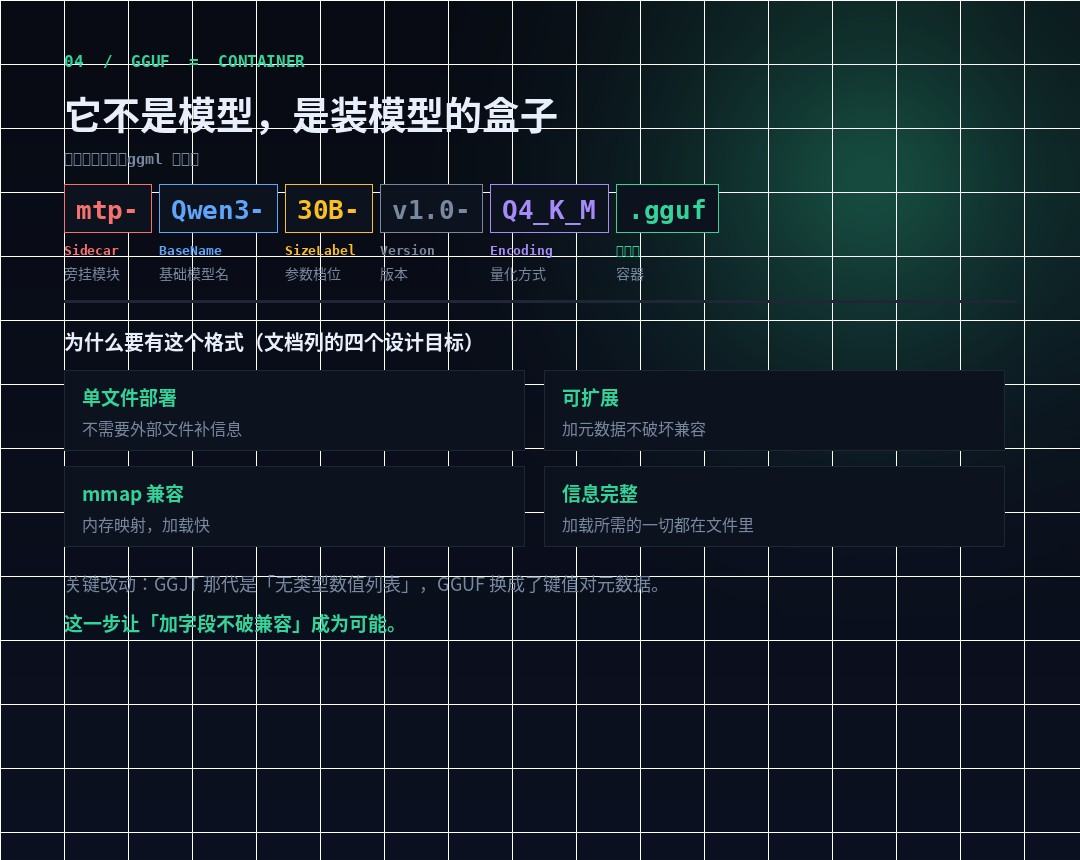
첫번째 3는 GGUF에서 차원을 변경한 모형의 크기입니다:파일 형식입니다.GGUUF는 GGML 및 그 구현자 (llama.cpp)의 모델 저장 형식입니다.
GGML, GGMF, GGJT, 세 가지 형식을 대체합니다. 공식적인 디자인 표적은 4개, 각입니다 과거 고통 점에 대응합니다:
| 디자인 목표 | 무엇을 의미합니까? |
|---|---|
| 단일 파일 배포 | 추가 문서 필요, 직접 배포 및 로딩 |
| 확장 가능 | 새로운 메타데이터를 추가하는 것은 오래된 모델의 호환성을 이해하지 않습니다. |
mmap 지원하다 | 메모리 맵 로딩, 빠른 |
| 자주 묻는 질문 | 로드해야 할 모든 것은 파일에 있습니다. 사용자는 그것을 공급할 필요가 없습니다. |
GGJT의 마지막 세대의 핵심 차이점은 단지 하나의 문장이지만 키입니다.hyperparameter는 metadata에 입력하지 않고 값 목록에서 변경됩니다.이 단계는 "add field incompatibility"로 가능했습니다. 한 필드가 추가되었습니다. 모든 이전 해결사가 변경되었습니다.
어떻게 덧붙였다?
공식 naming 코드는:
[].gguf실제 예제를 가져옵니다.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (대략 단위는, 다음 단면도를 보십시오)Qwen3→ BaseName (기본 모델명)27B→ SizeLabel (parameter 구멍)v1.0버전 (버전)Q4_K_M인코딩 (무게 인코딩/정량화)
자주 알려진 두 가지 구성 요소가 있습니다 :
- 유형.::
LoRA그것은 어댑터, 완전한 모델이 아닙니다.vocabvocabulary 파일을 나타냅니다. - 이름 *::
00003-of-00009분수, 제 3 회 9 주의를 보여줍니다.번호로 시작 0000120,000원
norm의 중요한 불평자도 있습니다.그것은 "산에서 완전히 철저하게 될거야.", 기존 gguf 파일이 너무 다양하기 때문에.그래서 파일 이름에서 무엇의 일정한 추측을 작성하지 마십시오, metadata를 읽으십시오.파일 형식 general.basename나는 모른다.general.size_label나는 모른다.general.finetune 그것은 권위입니다.
V. Q4 K M: 파일 이름의 가장 긴 부분은 압축 비율입니다
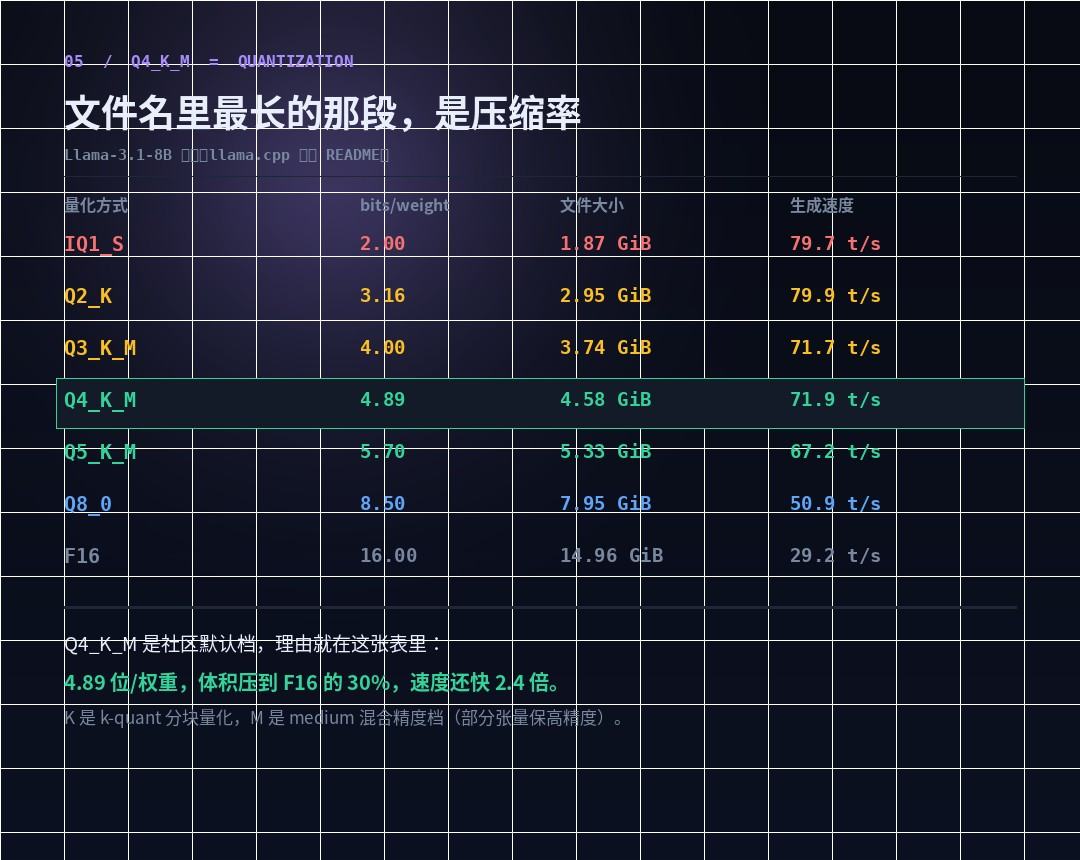
이것은 가장 연습에 당신의 경험에 영향을 미치는 것 중 하나이며, 아무도 명확하지 않았다.그것은 얼마나 많은 무게가 자격이 된지 나타냅니다.
llama.cpp 공식 README는 실제 설문 조사를 만들기 위해 Llama-3.1-8B를 사용했으며, 여러 단계 (오리지널 모델 32.1 GB)를했습니다.
| 품질 관리 | 비트 / 라이트 | 파일 크기 | 생성 속도 |
|---|---|---|---|
| 사이트맵 | 2.00 | 1.87 깁스 | 79.7 t/s의 |
| 사이트맵 | 3.16 | 2.95 지브 | 79.9 t/s의 |
| 사이트맵 | 4.00 | 3.74 지브 | 71.7 t/s의 |
| 사이트맵 | 4.89 | 4.58 지브 | 71.9 t/s의 |
| 사이트맵 | 5.70 | 5.33 지브 | 67.2 t/s의 |
| 사이트맵 | 8.50 | 7.95 지브 | 50.9의 t/s |
| 공장 투어 | 16.00 | 14.96 지브 | 29.2 t/s의 |
Q4 K M은이 테이블의 모든 이유에 대한 커뮤니티 기본 파일이됩니다.4.89 조금/무게, F16의 30%의 백로와 더불어, 2.4배 더 빠릅니다.Q8 0까지, 양 두 배는 30%에 의하여 떨어지고, 질 변화 대부분의 사람들은 알지 않습니다; IQ1 S에 아래로, 양은 조금 더 적은이고, 질 위험은 매우 더 높습니다.
당신은 당신의 이름을 읽는 방법?
- 한국어 = 일정한 정량;사이트맵 재료 매트릭스는 더 나은 품질과 약간 느리게 속도를 가진 (i-quant)를 정량화됩니다.
- 이름 * 대상 숫자 = Q4는 4 조금, Q8입니다 8 조금입니다.
- · = k-quant, 블록 정량 (블록 방향), 이전
_0/_1시리즈는 더 상세합니다. - S/M/L, L/C, 서부 동맹 = small/media/large의 혼합 정밀도 구멍.M은 민감한 뚜껑의 일부를 선택하여 높이를 유지합니다.그래서 Q4, K M은 K S보다 약간 커집니다.
많은 사람들이 알지 못하는 또 다른 사실이 있다:Quantification는 케이스에 의하여 케이스 기초 주문을 받아서 만들어질 수 있습니다.공식 도구는 유형별로 다른 유형의 지정을 지원합니다: attn_v 이름 * ffn_down Q5 K M과 별도로 설정하면 나머지는 Q4 K M으로 유지됩니다. 또한 일반 일괄 번호로 설정을 지원합니다. 그리고 그 때문에 같은 "Q4 K M"파일의 유형은 사람들 압력 파일의 크기와 다릅니다.그것은 기본 전략, 정확한 사양이 아닙니다.
VI. MTP: "다음 단어"라는 작은 모듈
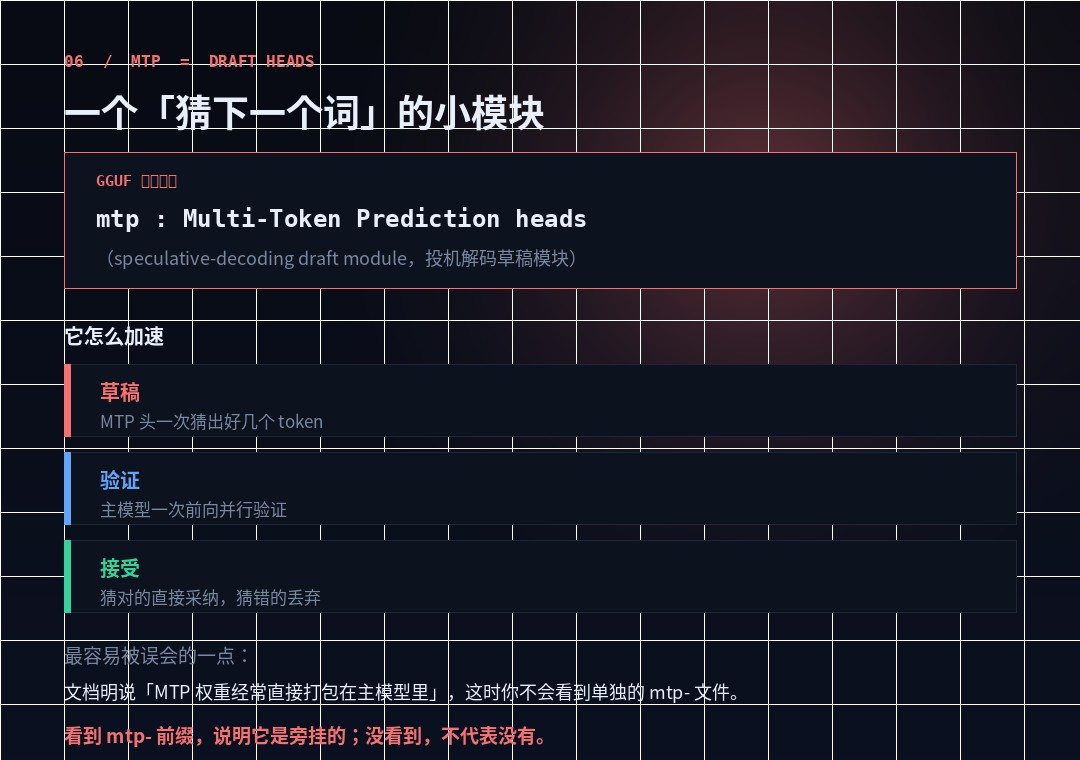
모델로 사용하기 쉽습니다.파일 역할 태그나는 모른다. GGF 문서 mtp Sidecar (accompanied 단위)로 정의하는:
Multi-Token Predation Headers, speculative decodering를 위한 초안 단위는, 기본 모형 일치 건축과 버전으로 적재될 것을 디자인했습니다.
그것은 간단합니다:다음 몇 가지 토큰을 추측하고, 메인 모델을 병렬로 실행하자.오른쪽 직접 채택, 잘못된 드롭. 검증은 항상 여러 토큰을 확인하기 때문에 토큰 당 평균 드롭 -- 이것은 speculative 디코더링의 전체 원칙입니다.
그러나이 섹션에서 가장 기억해야하는 문서의 구문이 있습니다."MTP 중량은 종종 기본 모델로 직접 포장되어 별도의 mtp-side 파일이 없습니다."
그래서 올바른 이해는:예. mtp- 접두사, 그들은 외부에 있음을 나타내는; 아무도 본 적이 없다, 아무도 의미하지 않습니다.즉, 모델 목록에서 MTP를 찾고있는 것은 종종 발견되지 않습니다 -- 그것은 이미 주요 파일입니다.
다른 Sidecar는 ... mmproj(Multimodal 영사기, multimodular 영사기), 시각 및 오디오 인코더 플러스 투상 층.기본 모델로 적재해야 할 독립형 문서입니다.그래서 당신은 GGF의 다중 모드 모델을 넣어하고 당신은지도를 볼 수 없습니다, 아마 mmproj 파일을 누락.
VII. 5 문자의 전체 읽기
위의 모든 것은 완전한 독서입니다. 이 파일 이름을 볼 수 있습니다:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| 뚱 베어 | 어떤 층입니까? | 이름 * |
|---|---|---|
mtp- | 파일 역할 | 붙어 있는 speculative decodement 단위는 주요 모형과 일치해야 합니다 |
Qwen3 | 모형 ID | 기본적인 모형 이름 |
30B | 크기 (mm) | 총 매개 변수 30 억 나는 pretend하지 않았다. |
A3B | 계산 | 3 억 시간. 당신은 어떻게 실행하기로 결정? |
v1.0 | 이름 * | 무게 버전 |
Q4_K_M | 제품 정보 | 4.89 조금/무게, 중간 혼합물 정밀도 |
.gguf | 회사 소개 | llama.cpp에. |
문서 요약:30 억의 총 매개 변수와 시간에 3 억의 MoE 모델은 GGUUF 컨테이너로 약 4.9 장소로 압축되었으며, 추가 사양의 디코딩 가속 모듈이 있습니다.
사이트맵 가장 일반적인 잘못의 4
- 3B 모델로 A3B를 고려하십시오.그것은 기억이 아닙니다. 30B는 더 적은 무게가 없고, 4GB는 아직도 보입니다.
- E4B "4B 소형 모델"탄성 모델의 가장 큰 세트입니다. E4B는 E2B의 모든 매개 변수를 포함합니다. 2B를 누르면 4B가 실행되지 않습니다.
- 모델로 GGF를 사용합니다.동일한 모형은 F16, Q8 0, Q4 K M 몇몇 GGUUFs일 수 있습니다.GGUF는 콘테이너이고 quantification는 내용입니다."Q4 및 GGUF 좋은"라고 물 좋은 "병과 물."라고 묻습니다.
- 이 게시물은 우리의 특별한 적용 시리아 Protests 2011의 일부입니다.거래가 완전히 합법적이지 않다는 공식 진술. 정확한 정보로 파일의 메타데이터에 접근하는 규칙을 작성하지 마십시오.
그리고 숨겨진 다섯 번째:제품정보 8x7B 7B를 읽으십시오.그것은 "8 전문가 각각 7B." 총 56B. GGUF에서 <expertCount>x<count> x는 다용도입니다.
IX. PRACTICAL 사업
마지막으로, 다음을 수행 할 수있는 순서. 어떤 모델 이름에서보고이 순서에서 자신을 요청:
- 콘테이너와 quantify에 첫번째 보기.
.gguf+Q4_K_M이것은 로컬 런 오프 질량 버전이며, 품질 및 볼륨은 이미 릴리스의 시간에 설정됩니다. - 전반적인 매개변수를 다시 읽으십시오.당신의 존재/RAM이 충분하다는 것을 결정하십시오. 그것은 단단한 문턱입니다. 그것은 충분하지 않습니다.
- Moe가 있다면예.
A??B설명은 활성화 매개 변수를 기반으로하지만 메모리는 여전히 총 매개 변수를 기반으로합니다. - E 접두사가있는 경우.예.
E이것은 탄력 있는 모형이고 실제적인 존재가 명목상 가치의 밑에 잘 일지도 모르다는 것을 나타냅니다 - 이것은 그것이 휴대폰에 접근할 수 있는지 결정합니다. - Sidecar에서 마지막 모습.예.
mmproj-함께 와서 기억하십시오; 예.mtp-일치하는 기억; 가속도가 없다는 것을 의미하지 않습니다.
모델 이름은 매개 변수 테이블이 아니라 라벨이 아닙니다. 라벨은 다음 잘못된 파일에서 벗어나지 못합니다. 점수를 계산하지 마십시오.
항상 실행됩니다. 그러나 라벨을 올바르게 읽기 위해 적어도 설치 할 수없는 15GB를 다운로드하기 전에 알아야 할 것입니다 ...이 저장된 시간, 어떤 벤치 마크 점수 이상.