
B、GGUF、MTP、A3B、E4B:模型名裏這五個字符,說的不是一件事
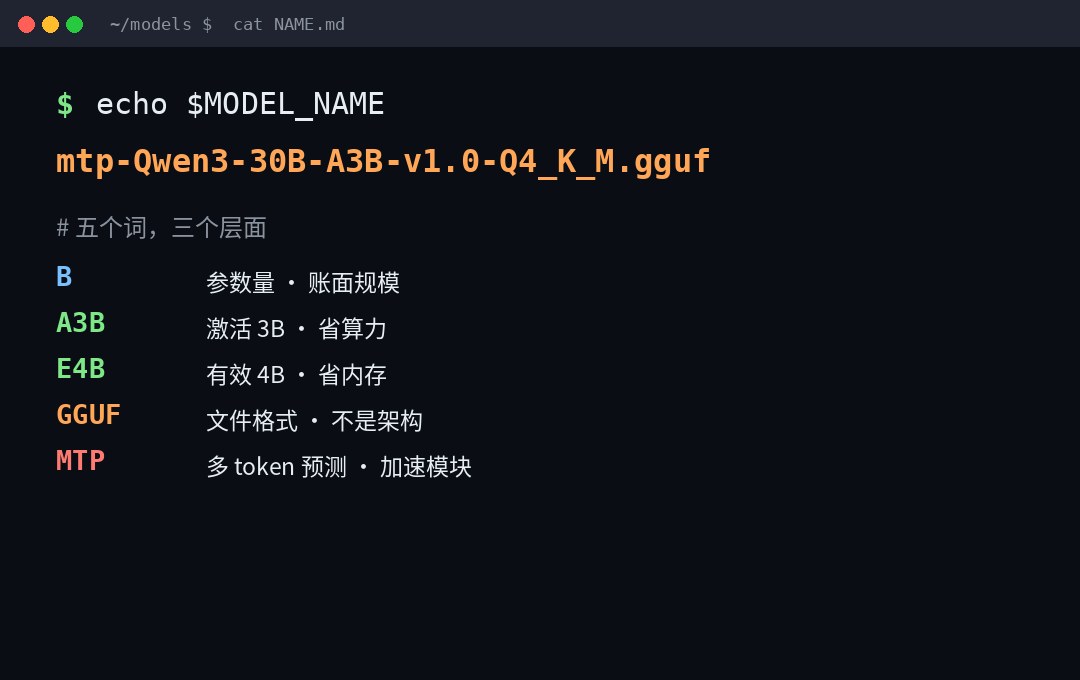
先說一個結論,能省掉後面一半的困惑:這五個東西根本不在同一個維度上。B 是量詞,A3B 和 E4B 是「哪一種量」,GGUF 是容器,MTP 是插件。把它們並排念出來像一串參數,實際上它們各自回答一個完全不同的問題。
具體分工是這樣的:B 回答「多大」,A3B 回答「多少在幹活」,E4B 回答「多少真的佔內存」,GGUF 回答「用什麼裝」,MTP 回答「怎麼加速」。一個文件名裏同時出現四五個,是因爲它們確實需要同時被表達——但混淆往往發生在把它們當成同一類信息的時候。
一、B:只是「十億」這個單位
B 是 Billion,十億。7B 就是 70 億參數,235B 就是 2350 億。它跟 GGUF 的命名規範裏的量級前綴是一套東西:K 千、M 百萬、B 十億、T 萬億、Q 千萬億。
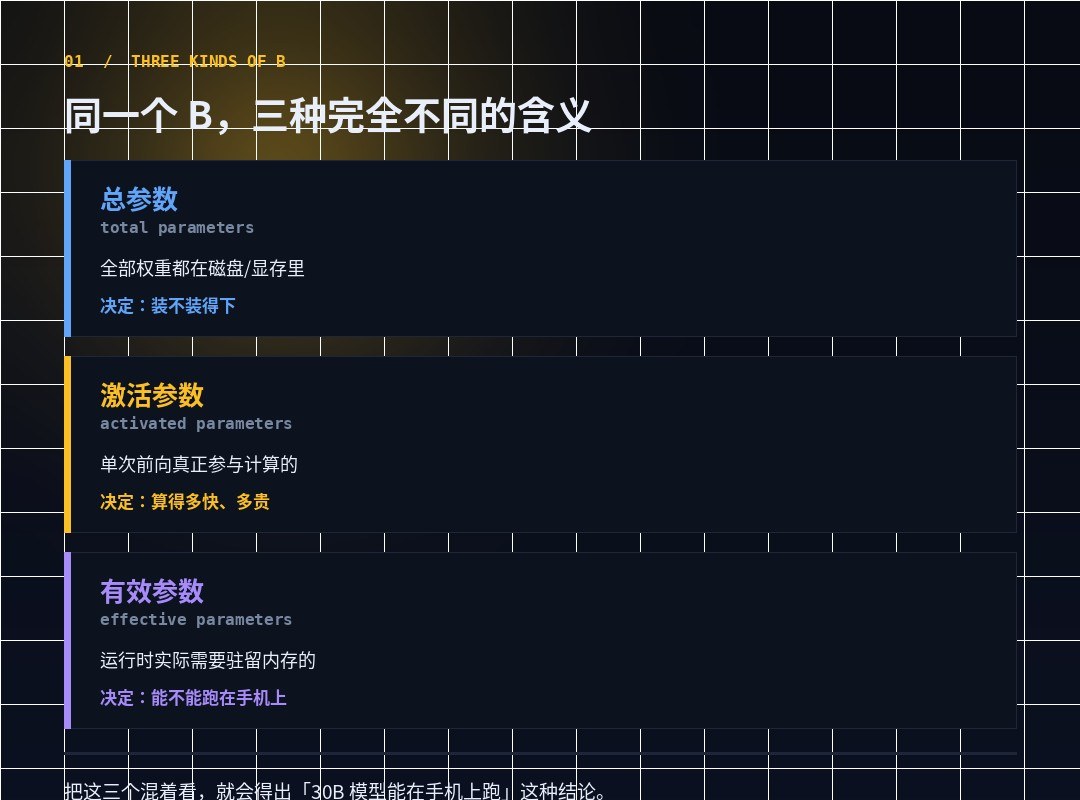
看起來最簡單的一個,其實藏着三種完全不同的含義。這是全文最該先講清的一件事:
| 寫法 | 含義 | 決定什麼 |
|---|---|---|
30B | 總參數:全部權重 | 裝不裝得下(磁盤、顯存) |
30B-A3B | 總參數 30B,單次激活 3B | 算得多快、多貴 |
E4B | 有效參數:運行時實際駐留的 | 能不能跑在手機上 |
這三行如果混着看,就會得出「30B 模型能在手機上跑」這種結論。它可能沒錯,但和你以爲的那個 30B 不是一回事。
二、A3B:總參數和激活參數不是一回事
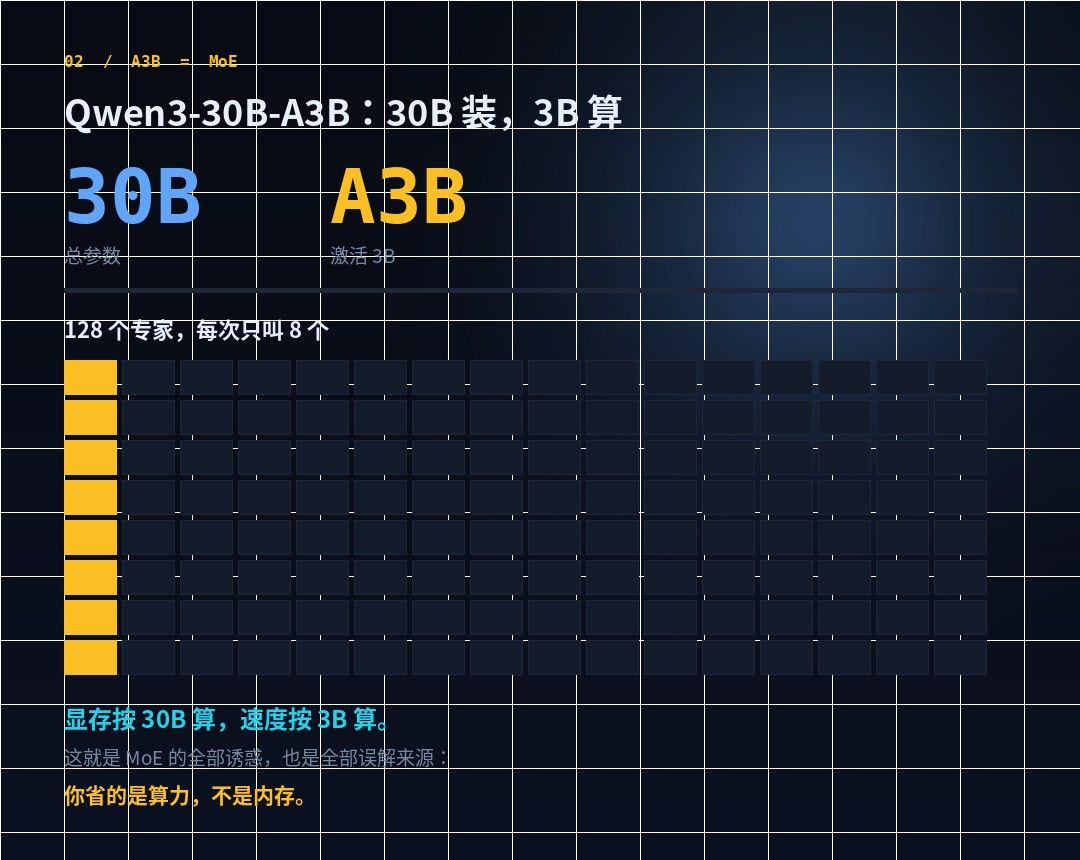
這個寫法來自 MoE(Mixture of Experts,混合專家)。Qwen3 那批模型的命名把話說得很明白,官方博客的原話是:Qwen3-235B-A22B 是「2350 億總參數、220 億激活參數」的大模型,Qwen3-30B-A3B 是「300 億總參數、30 億激活參數」的小 MoE。
技術細節也很具體:30B-A3B 有 48 層,Q/KV 頭數 32/4,128 個專家裏每次激活 8 個,上下文 128K。235B-A22B 是 94 層,64/4 頭,同樣是 128 個專家激活 8 個。
所以 A3B 這個標記的實際意思是:顯存按 30B 算,速度按 3B 算。
這就是 MoE 的全部誘惑,也是全部誤解來源——你省的是算力,不是內存。很多人看到 A3B 就以爲這是個 3B 模型,裝到只有 4GB 顯存的機器上,然後發現根本加載不了。權重一個都沒少,只是每次前向計算不全部參與。
順帶一個容易忽略的寫法:GGUF 的 SizeLabel 規範是 <expertCount>x<count><scale-prefix>,所以 8x7B 這種寫法是「8 個專家 × 7B」,總共 56B。那個 x 不是乘號省略,就是乘號。Mixtral-8x7B 常被誤讀成「7B 模型」,實際總參數是 56B。
三、E4B:E 是 effective,不是「更小」
這個是最容易徹底誤讀的一個。Gemma 3n 的文檔寫得很清楚:
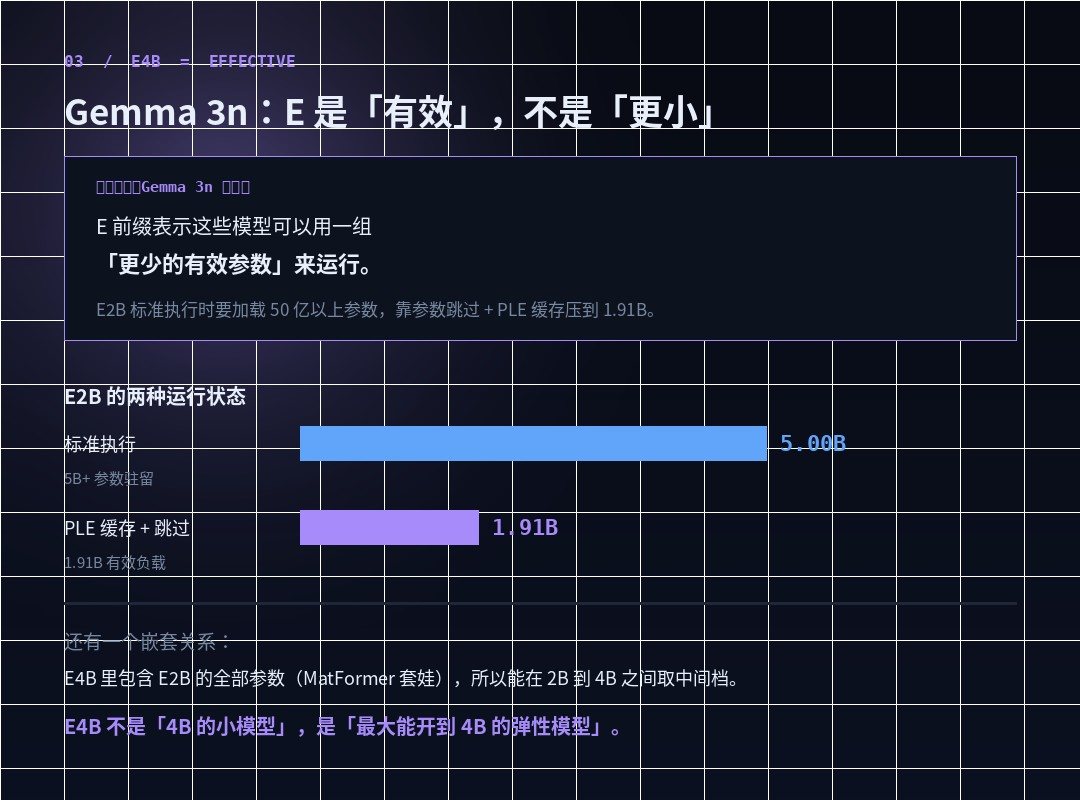
Gemma 3n 模型的參數標記(如 E2B、E4B)低於模型實際包含的總參數量。E 前綴表示這些模型可以用一組「更少的有效參數」來運行。
具體到什麼程度?文檔給了數字:E2B 標準執行時要加載 50 億以上參數,靠參數跳過和 PLE 緩存,可以把有效內存負載壓到 1.91B。
注意這句話的主語:模型本身沒變小,是「運行時的駐留量」變小了。
靠兩個機制實現:
- PLE 緩存(Per-Layer Embedding)。每層嵌入參數可以在模型內存之外單獨生成、緩存到快速本地存儲,運行時逐層加進去。等於把這部分參數請出了內存。
- MatFormer(套娃 Transformer)。一個大模型內部嵌套了若干小模型,小模型推理時不需要激活外層參數。所以能在 2B 到 4B 之間取任意中間檔。
這就引出一個反直覺的事實:E4B 裏包含 E2B 的全部參數。不是兩個獨立模型,是同一個彈性模型的兩個檔位。所以準確的說法不是「E4B 是個 4B 的小模型」,而是「E4B 是個最大能開到 4B 的彈性模型」。
這條對判斷「能不能跑在我的設備上」影響很大:E4B 在低配設備上可以按 E2B 的方式跑,在高配設備上才展開到 4B。而 A3B 沒有這個彈性——它就是 30B,只是算得省。
四、GGUF:它不是模型,是裝模型的盒子
前面三個是「模型多大」,從 GGUF 開始換了一個維度:這是文件格式。準確說,GGUF 是給 GGML 及其執行器(llama.cpp 這一系)用的模型存儲格式。
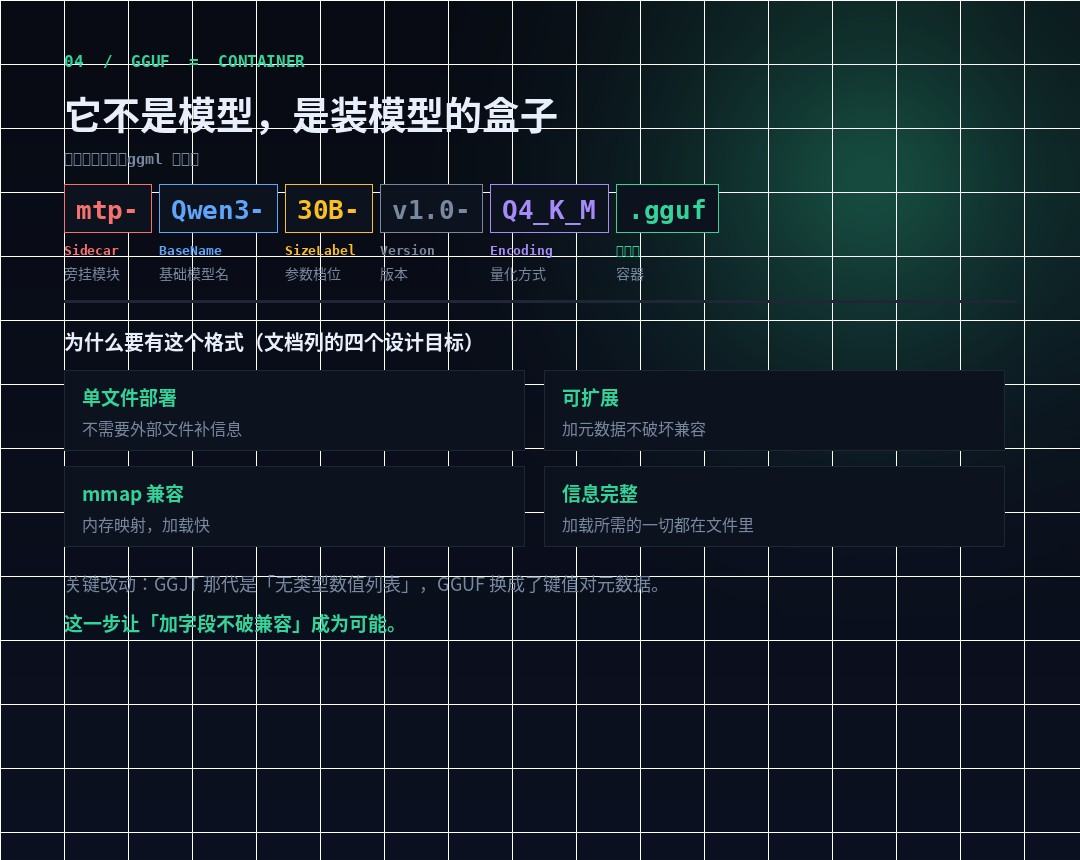
它取代的是 GGML、GGMF、GGJT 三代格式。官方的設計目標有四條,每一條都對應一個過去的痛點:
| 設計目標 | 解決什麼 |
|---|---|
| 單文件部署 | 不需要額外文件補信息,直接分發和加載 |
| 可擴展 | 加新元數據不破壞舊模型的兼容性 |
mmap 兼容 | 內存映射加載,快 |
| 信息完整 | 加載所需的一切都在文件裏,用戶不用另外提供 |
它和上一代 GGJT 的關鍵差別只有一句話,但很關鍵:超參數從「無類型的數值列表」改成了鍵值對元數據。這一步讓「加字段不破兼容」成爲可能——以前加一個字段,所有舊解析器都得改。
文件名是怎麼拼出來的
官方給的命名規範是:
[].gguf拿一個真實例子拆開看:
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-→ Sidecar(旁掛模塊,見下一節)Qwen3→ BaseName(基礎模型名)27B→ SizeLabel(參數檔位)v1.0→ Version(版本)Q4_K_M→ Encoding(權重編碼 / 量化方式)
還有兩個不常出現的組件值得知道:
- Type:
LoRA表示這是個適配器,不是完整模型;vocab表示詞表文件。 - Shard:
00003-of-00009表示分片,第 3 片共 9 片。注意編號從 00001 開始,不是 00000。
規範裏還有一句很重要的免責聲明:這個命名約定「不打算在野外做到完全可解析」,因爲現存的 gguf 文件名實在太雜。所以別寫正則去猜文件名裏的信息,讀元數據。文件裏的 general.basename、general.size_label、general.finetune 纔是權威。
五、Q4_K_M:文件名裏最長的那段,是壓縮率
這是實踐中最影響你體驗的一段,也是最沒人講清楚的一段。它表示權重被量化成了多少位。
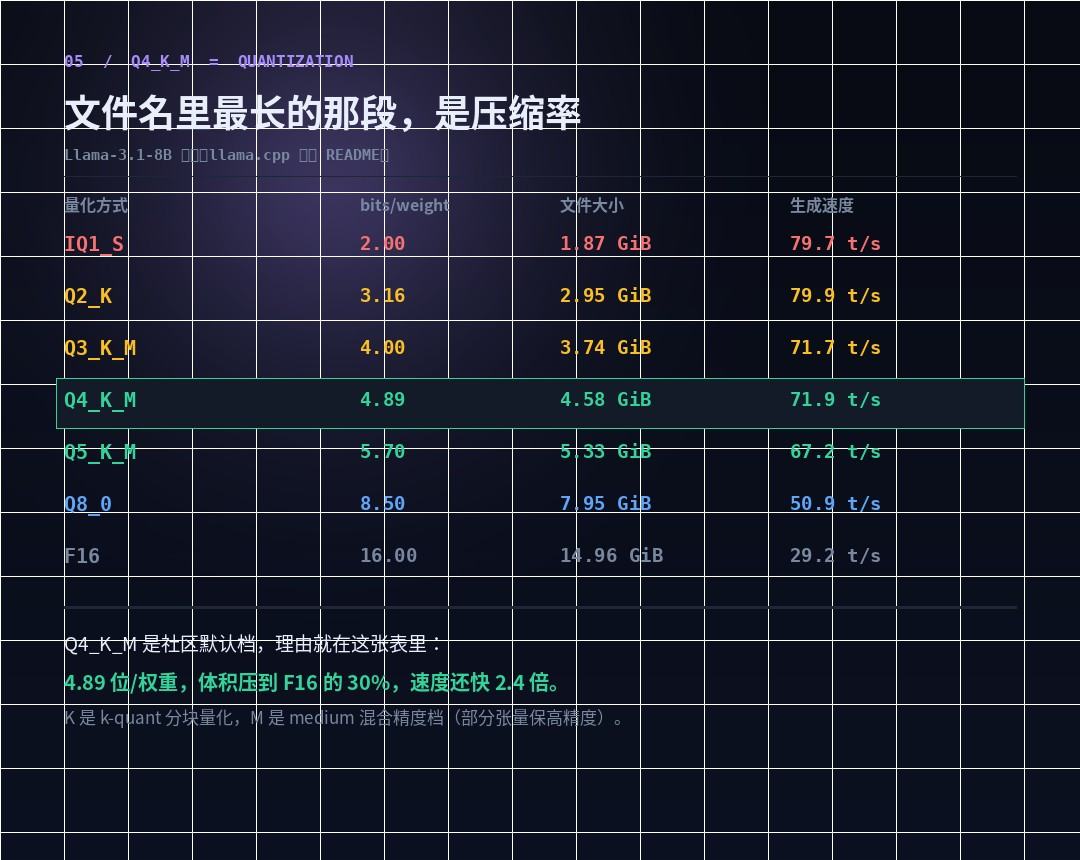
llama.cpp 官方 README 拿 Llama-3.1-8B 做了一張實測表,我挑幾檔抄下來(原始模型 32.1 GB):
| 量化方式 | bits/weight | 文件大小 | 生成速度 |
|---|---|---|---|
| IQ1_S | 2.00 | 1.87 GiB | 79.7 t/s |
| Q2_K | 3.16 | 2.95 GiB | 79.9 t/s |
| Q3_K_M | 4.00 | 3.74 GiB | 71.7 t/s |
| Q4_K_M | 4.89 | 4.58 GiB | 71.9 t/s |
| Q5_K_M | 5.70 | 5.33 GiB | 67.2 t/s |
| Q8_0 | 8.50 | 7.95 GiB | 50.9 t/s |
| F16 | 16.00 | 14.96 GiB | 29.2 t/s |
Q4_K_M 成爲社區默認檔,理由全在這張表裏:4.89 位/權重,體積壓到 F16 的 30%,速度還快 2.4 倍。往上到 Q8_0,體積翻倍、速度掉三成,換來的質量提升大多數人感知不到;往下到 IQ1_S,體積只省一點,質量風險大得多。
名字怎麼讀
- Q = 常規量化(Quantization);IQ = 重要性矩陣量化(i-quant),同位數下質量更好、速度略慢。
- 數字 = 目標位數。Q4 是 4 位,Q8 是 8 位。
- _K = k-quant,分塊量化(block-wise),比老的
_0/_1系列更細。 - _S / _M / L = small / medium / large,混合精度檔。M 會挑一部分敏感張量保高精度,所以同爲 Q4,K_M 比 K_S 略大也略好。
還有一個很多人不知道的事實:量化可以逐張量定製。官方工具支持按張量名指定不同類型,比如把 attn_v 和 ffn_down 單獨設成 Q5_K_M,其餘保持 Q4_K_M;也支持用正則按層號批量設置。這就是爲什麼同一個「Q4_K_M」,不同人壓出來的文件大小會不一樣——它是一套默認策略,不是一個精確規格。
六、MTP:一個「猜下一個詞」的小模塊
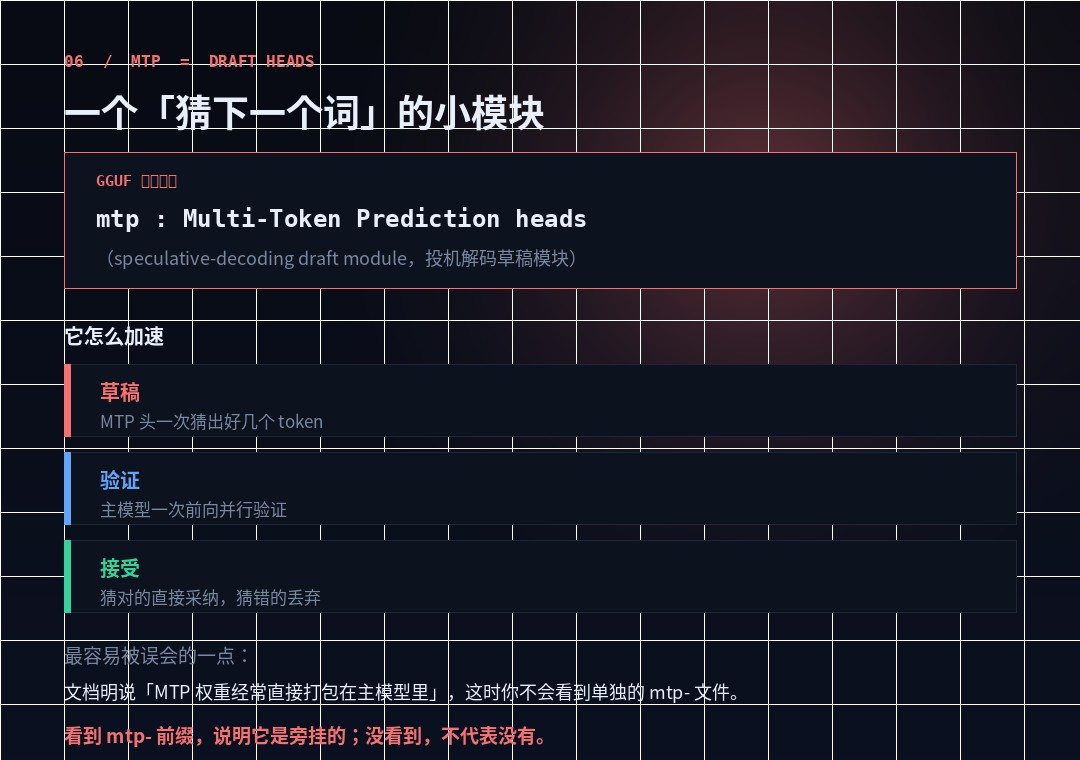
最後這個最容易被當成模型特性,其實它是文件角色標記。GGUF 文檔裏把 mtp 定義爲 Sidecar(旁掛模塊),說明是:
Multi-Token Prediction heads(多 token 預測頭),投機解碼的草稿模塊,設計上要與架構和版本匹配的基礎模型一起加載。
它乾的事很簡單:先猜出後面好幾個 token,再讓主模型一次性並行驗證。猜對的直接採納,猜錯的丟棄重來。因爲驗證一次前向能確認多個 token,平均下來每個 token 的耗時下降——這就是投機解碼(speculative decoding)的全部原理。
但文檔裏緊接着有一句話,是這一節最該記住的:「MTP 權重經常被直接打包進基礎模型裏,這種情況下就沒有單獨的 mtp- 旁掛文件。」
所以正確的理解是:看到 mtp- 前綴,說明它是外掛的;沒看到,不代表沒有。這也是爲什麼在模型列表裏找 MTP 常常找不到——它已經在主文件裏了。
另一個 Sidecar 是 mmproj(multimodal projector,多模態投影器),視覺和音頻的編碼器加投影層。這個通常是獨立文件,必須和基礎模型配對加載。所以如果你下了一個多模態模型的 GGUF 卻發現不能看圖,八成是漏了 mmproj 那個文件。
七、五個字符的完整讀法
把上面所有內容壓成一次完整的讀法。假設你看到這個文件名:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| 片段 | 屬於哪一層 | 說明 |
|---|---|---|
mtp- | 文件角色 | 旁掛的投機解碼模塊,需與主模型配對 |
Qwen3 | 模型身份 | 基礎模型名 |
30B | 規模 | 總參數 300 億 → 決定裝不裝得下 |
A3B | 計算 | 每次激活 30 億 → 決定跑多快 |
v1.0 | 版本 | 權重版本 |
Q4_K_M | 存儲 | 4.89 位/權重,中等混合精度 |
.gguf | 容器 | 給 llama.cpp 這一系用的格式 |
一句話總結這個文件:一個總參數 300 億、每次算 30 億的 MoE 模型,被壓到約 4.9 位存進 GGUF 容器,另外附帶一個投機解碼加速模塊。
八、四個最常見的誤讀
- 把 A3B 當成 3B 模型。省的是算力不是內存。30B 的權重一個都沒少,4GB 顯存照樣裝不下。
- 把 E4B 當成「4B 小模型」。它是彈性模型的最大檔,E4B 裏包含 E2B 的全部參數。低配設備上它按 2B 跑,不是按 4B 跑。
- 把 GGUF 當成模型。同一個模型可以有 F16、Q8_0、Q4_K_M 好幾個 GGUF。GGUF 是容器,量化是內容。問「Q4 和 GGUF 哪個好」等於問「瓶子和水哪個好」。
- 以爲文件名能精確解析。官方明說這個約定不追求完全可解析。要準確信息就讀文件元數據,別寫正則。
還有一個隱藏的第五個:把 8x7B 讀成 7B。那是「8 個專家各 7B」,總共 56B。GGUF 規範裏 <expertCount>x<count> 的那個 x 就是乘號。
九、實用判斷順序
最後給一個可以照着走的順序。看任何一個模型名,按這個次序問自己:
- 先看容器和量化。
.gguf+Q4_K_M意味着這是本地跑的量產版本,質量和體積已經在出廠時定好了。 - 再看總參數。決定你的顯存/內存夠不夠。這條是硬門檻,不夠就是跑不了。
- 再看是不是 MoE。有
A??B說明速度按激活參數算,但內存仍按總參數算。 - 再看有沒有 E 前綴。有
E說明這是個彈性模型,實際駐留量可能遠低於標稱值——這條決定了它能不能進手機。 - 最後看 Sidecar。有
mmproj-記得一起下;有mtp-記得配對;都沒有也不代表沒有加速能力。
模型名不是參數表,是一份標籤。標籤的作用是讓你少下一次錯的文件,不是讓你算出它的分數。
真正決定「這個模型在我這兒表現如何」的,永遠是跑一遍。但把標籤讀對,至少能讓你在下載 15GB 之前就知道它裝不裝得下——這件事省下來的時間,比任何基準分數都實在。