
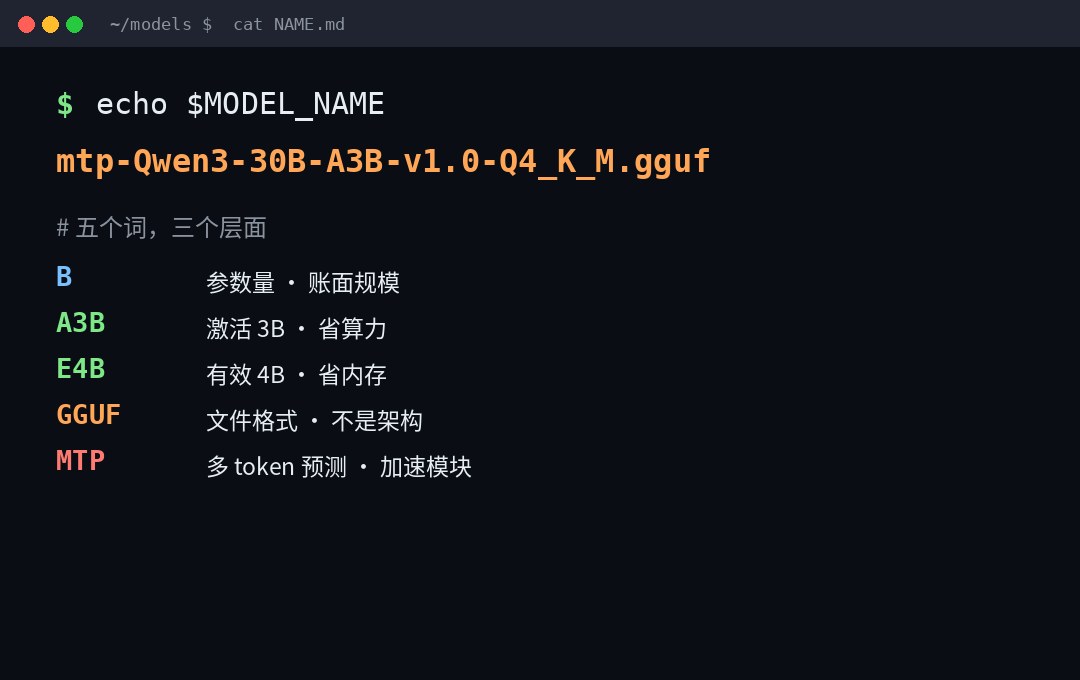
B, GGUF, MTP, A3B, E4B: मॉडल नाम में पांच अक्षर, एक नहीं। हाँ।
चलो एक निष्कर्ष के साथ शुरू करते हैं जो भ्रम के आधे हिस्से को बचाता है:ये पांच चीजें समान आयामों पर नहीं हैं।B शब्द है, A3B और E4B "quantity", GGUF कंटेनर है, MTP प्लगइन है। वास्तव में, वे पूरी तरह से अलग सवाल का जवाब देते हैं।
श्रम का विशिष्ट विभाजन इस प्रकार है:"B", "How big," "A3B", "How much work", "E4B", "GGUF", "What is in it", "MTP", "कैसे यह त्वरित करता है। "चार या पांच दस्तावेज़ एक साथ दिखाई देते हैं क्योंकि उन्हें एक साथ व्यक्त करने की आवश्यकता होती है - लेकिन भ्रम अक्सर तब होता है जब उन्हें उसी प्रकार की जानकारी के रूप में इलाज किया जाता है।
एक, बी: यह सिर्फ एक अरब है।
B अरब डॉलर है।7B यह 7 अरब डॉलर की डॉलर की मात्रा है।235B यह 235 बिलियन है। यह GGUF नाम कोड में स्केल प्रीफिक्स का एक सेट है:K हजारM मिलियनB एक अरबT डॉलरQ बिलियन
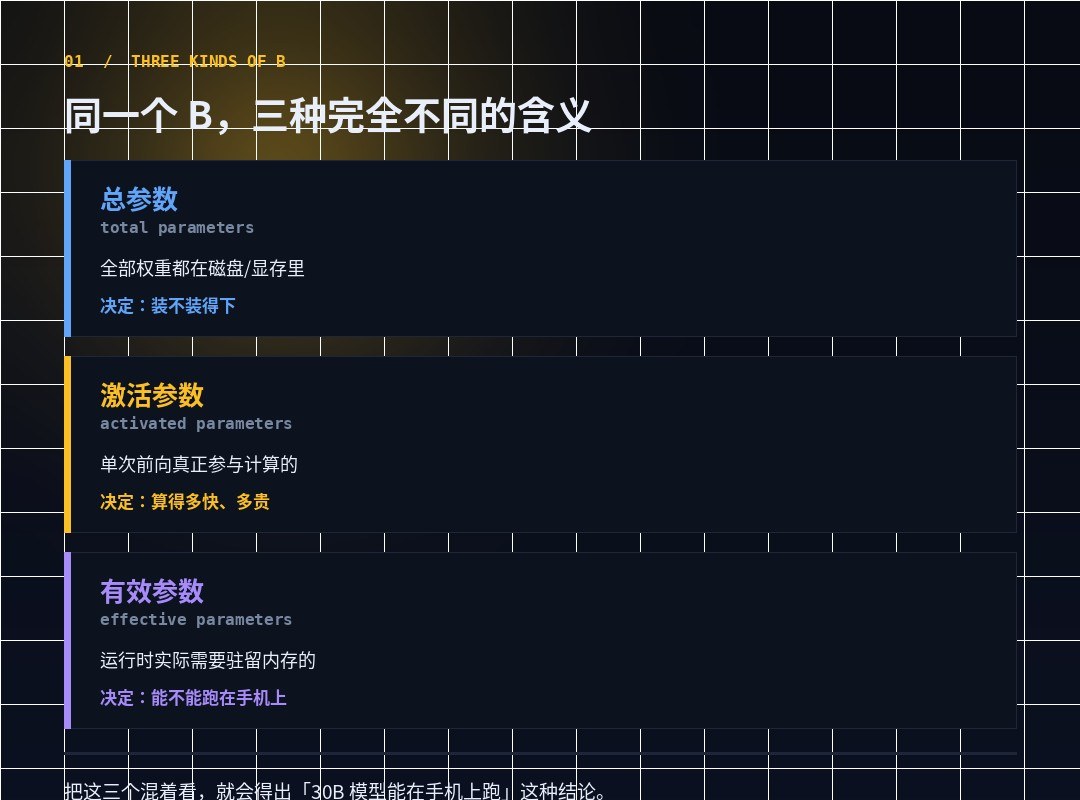
सबसे सरल की तरह दिखता है, वास्तव में तीन पूरी तरह से अलग अर्थ हैं। यह पहली बात है कि यह स्पष्ट होना चाहिए:
| लेखन | अर्थ | क्या? |
|---|---|---|
30B | कुल मिलाकर पैरामीटर: पूर्ण वजन | क्या आप इसे खेल सकते हैं?(डिस्क, दृश्यमान) |
30B-A3B | कुल 30B, एकल सक्रियण 3B | कैसे तेजी से? कितना महंगा? |
E4B | मान्य पैरामीटर: संचालन के समय वास्तविक उपस्थिति | क्या आप फ़ोन पर चला सकते हैं? |
यदि आप इन तीन पंक्तियों को एक साथ देखते हैं, तो आपको यह निष्कर्ष मिलेगा कि 30B मॉडल सेल फोन पर चल सकता है।यह सही हो सकता है, लेकिन ऐसा नहीं है जितना कि 30B आपने सोचा था कि यह था।
II. A3B: सामान्य पैरामीटर और सक्रियण पैरामीटर एक बार नहीं हैं।
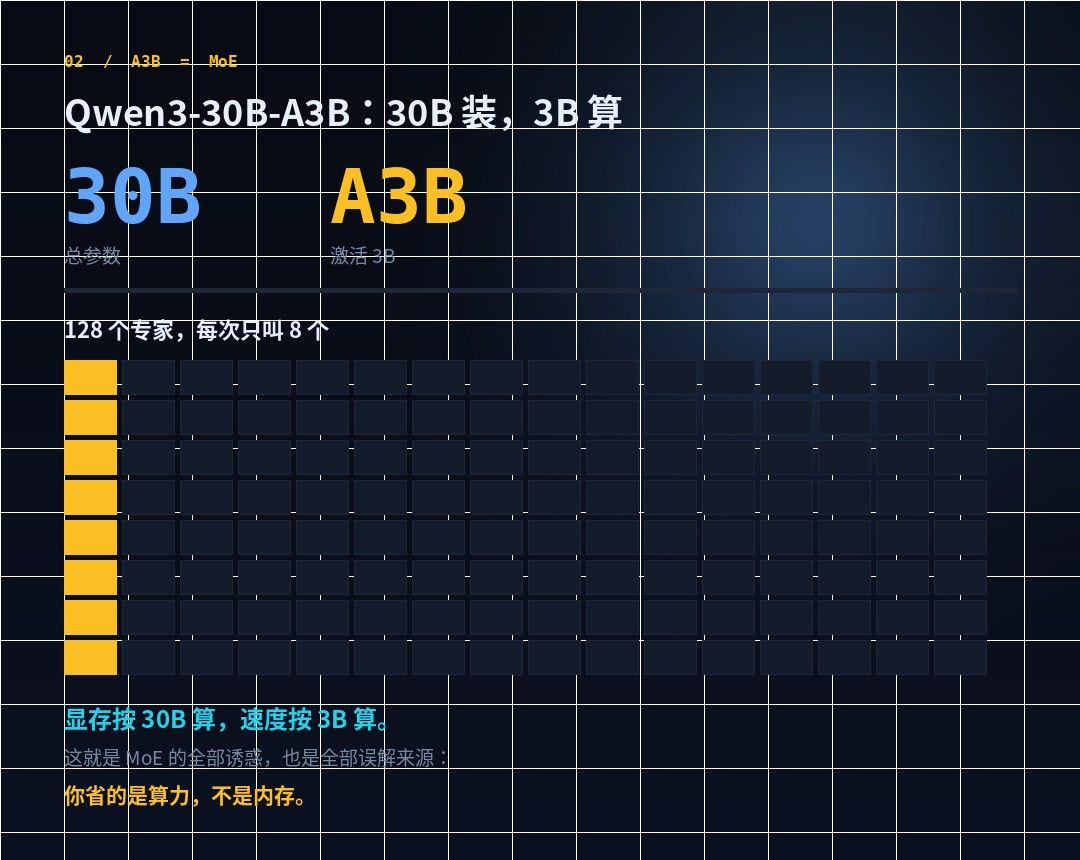
यह एमओई से है Qwen3 मॉडल के नाम के बारे में बहुत स्पष्ट है:Qwen3-235B-A22B "233.5 बिलियन कुल पैरामीटर, 22 बिलियन सक्रिय पैरामीटर" का एक बड़ा मॉडल है, और Qwen3-30B-A3B "30 बिलियन कुल पैरामीटर, 3 बिलियन सक्रिय पैरामीटर" का एक छोटा सा MoE है।
तकनीकी विवरण भी विशिष्ट हैं: 30B-A3B में 48 मंजिल, Q/KV हेड गिनती 32/4 है।128 विशेषज्ञों में से 8 सक्रिय, संदर्भ 128K। 235B-A22B 94th फ्लोर, 64/4 हेड, 128 विशेषज्ञों ने 8 सक्रिय किया है।
तो, A3B, इस चिह्न का वास्तविक अर्थ है:30B, गति 3B प्रदर्शित करता है।
यही कारण है कि सभी MoE का प्रलोभन, गलतफहमी के सभी स्रोत।आप पैसे की बचत कर रहे हैं, स्मृति नहीं है।कई लोग A3B देखते हैं और सोचते हैं कि यह एक 3B मॉडल है, जो 4GB मशीन पर लोड हो गया है और फिर इसे लोड करना असंभव है। कोई भी वजन छोटा नहीं है, बल्कि सभी आगे की गणना नहीं है।
एक आसान लिखने के साथ: GGF का SizeLabel है <expertCount>x<count><scale-prefix>♪ और इसलिए 8x7B इसे कुल 56B के लिए "8 विशेषज्ञों x 7B" कहा जाता है।यह एक गुणन ellipsis या एक गुणन है।मिक्सट्रल-8x7B को अक्सर "7B मॉडल" के रूप में गलत व्याख्या की जाती है और वास्तविक कुल पैरामीटर 56B है।
III E4B:E प्रभावशाली है, नहीं "छोटा"
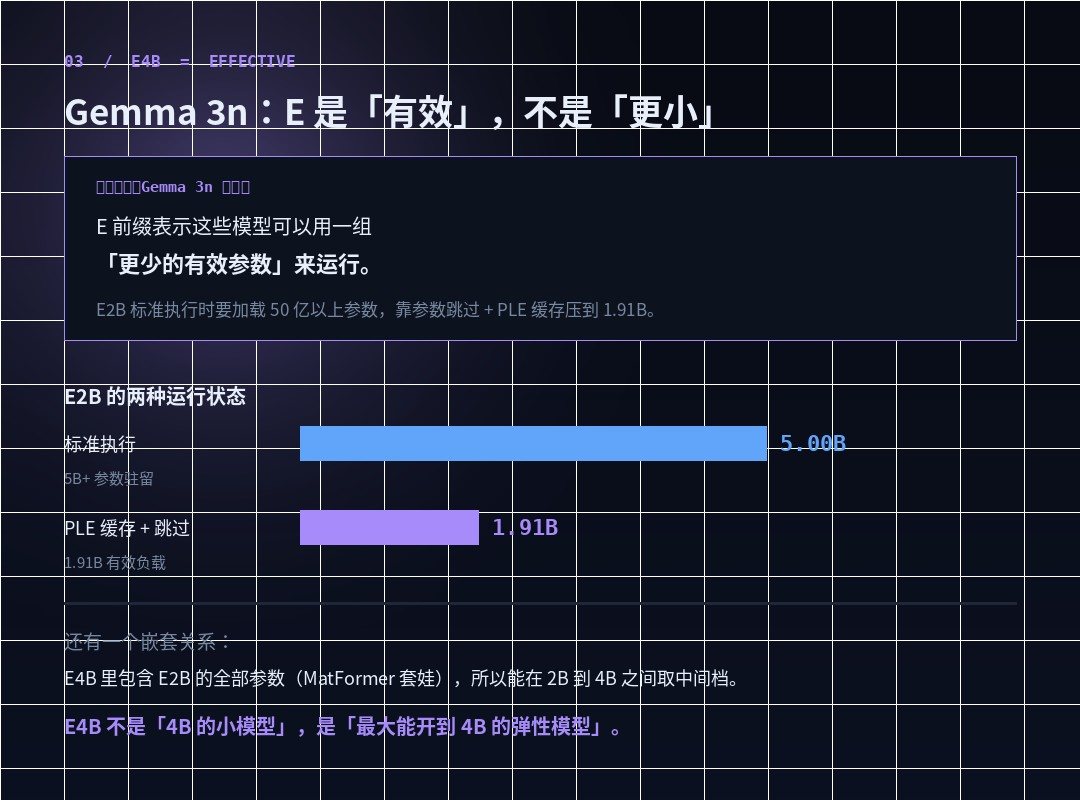
यह पूरी तरह से पढ़ने का सबसे आसान तरीका है। जेमा 3n का दस्तावेज़ स्पष्ट है:
जेमा 3n मॉडल के लिए पैरामीटर अंक (जैसे E2B, E4B)कम से कमवास्तव में मॉडल में शामिल मापदंडों की कुल राशि। E prefix इंगित करता है कि इन मॉडलों को "कम सक्रिय मापदंडों" के सेट के साथ चलाया जा सकता है।
किस हद तक? दस्तावेज़ संख्या देता है:E2B मानकों को सक्रिय मेमोरी लोड को 1.91B पर दबाने के लिए मापदंडों द्वारा 5 बिलियन से अधिक मापदंडों, स्किपिंग और PLE कैश को लोड करके कार्यान्वित किया जाता है।
इस वाक्य के मुख्य शब्दों को नोट करें:मॉडल खुद छोटा नहीं हुआ है, यह दौड़ते समय अपनी उपस्थिति के संदर्भ में छोटा हो गया है।
यह दो तंत्रों के माध्यम से प्राप्त किया जा सकता है:
- PLE कैश (Per-Layer एम्बेडिंग)।एम्बेडेड मापदंडों की प्रत्येक परत को अलग से मॉडल मेमोरी से उत्पन्न किया जा सकता है, एक तेजी से स्थानीय भंडारण में कैश किया जाता है, और प्रत्येक परत में जब चल रहा है।यह स्मृति से बाहर पैरामीटर के इस हिस्से को पूछने के बराबर है।
- MatFormer.एक बड़े मॉडल के भीतर एम्बेडेड कई छोटे मॉडल हैं, जिन्हें डिड्यूस होने पर बाहरी मापदंडों को सक्रिय करने की आवश्यकता नहीं है। इसलिए आप 2B और 4B के बीच किसी भी मध्य में ले सकते हैं।
यह एक प्रतिवादी तथ्य की ओर जाता है:E4B में सभी E2B पैरामीटर होते हैं।दो स्टैंड-अलोन मॉडल नहीं, एक ही लोचदार मॉडल के लिए दो स्लॉट। इसलिए सटीक शब्द "E4B एक 4B लघु मॉडल है" लेकिन "E4B" नहीं है।E4B अधिकतम शक्ति 4B के लिए जाने के साथ एक लोचदार मॉडल है।ऐसा नहीं है कि मैं कहीं भी जा रहा हूँ।
इस फैसले पर बहुत प्रभाव पड़ता है कि "मैं अपने उपकरणों पर चला सकता हूं":E4B कम उपकरण पर E2B की तरह चला सकते हैं और उच्च उपकरण पर 4B तक विस्तार कर सकते हैं।और A3B इस लोच नहीं है - यह 30B है, यह सिर्फ लागत बचत है।
IV. GGUF: यह एक मॉडल नहीं है, यह एक मॉडल बॉक्स है।
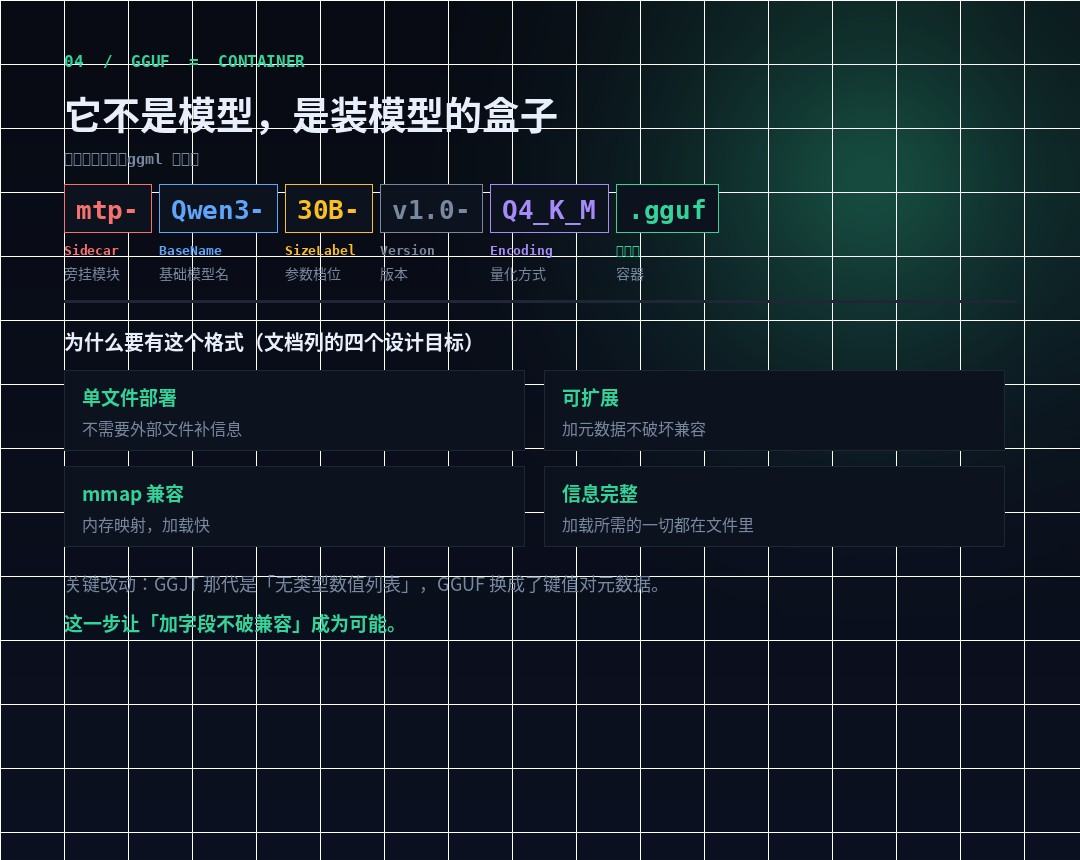
पहला तीन मॉडल का आकार है, जिसने GGUF से आयाम बदल दिया है:यह फ़ाइल प्रारूप है।सटीक होने के लिए, GGUUF GGML और इसके कार्यान्वयनकर्ता (llama.cpp) के लिए एक मॉडल भंडारण प्रारूप है।
यह GGML, GGMF, GGJT, तीन पीढ़ी के प्रारूप की जगह लेता है। आधिकारिक डिजाइन लक्ष्य चार हैं, जिनमें से प्रत्येक पिछले दर्द बिंदु से मेल खाता है:
| डिजाइन उद्देश्यों | क्या सौदा? |
|---|---|
| एकल फ़ाइल तैनाती | कोई अतिरिक्त दस्तावेज आवश्यक, प्रत्यक्ष वितरण और लोडिंग नहीं |
| विस्तारणीय | नए मेटाडाटा जोड़ना पुराने मॉडल की संगतता को कम नहीं करता है |
mmap संगतता | मेमोरी मैप लोडिंग, त्वरित |
| पूर्ण जानकारी | सब कुछ जो आपको लोड करने की आवश्यकता है वह फ़ाइल में है। उपयोगकर्ता इसे आपूर्ति करने की जरूरत नहीं है। |
इसके बीच महत्वपूर्ण अंतर और GGJT की अंतिम पीढ़ी सिर्फ एक वाक्य है, लेकिन यह कुंजी है:हाइपरपैरामीटर को मेटाडाटा के लिए एक कुंजी के बिना मूल्यों की एक सूची से बदल दिया जाता है।इस कदम ने इसे "एड फील्ड इंकॉम्पैटिबिलिटी" के लिए संभव बनाया - एक बार फील्ड जोड़ा गया था, सभी पुराने हलकों को बदलना पड़ा।
आपने इसे कैसे किया?
आधिकारिक नामकरण कोड है:
[].ggufवास्तविक उदाहरण लें।
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• साइडकार (byline Module, अगले अनुभाग देखें)Qwen3→ BaseName (base model name)27B→ SizeLabel (parameter slot)v1.0संस्करण (version)Q4_K_Mएन्कोडिंग (वजन एन्कोडिंग / मात्रा)
दो घटक होते हैं जो अक्सर ज्ञात नहीं होते हैं:
- प्रकार:
LoRAइसका मतलब यह है कि यह एक एडाप्टर है, एक पूर्ण मॉडल नहीं है;vocabशब्दावली फ़ाइल को इंगित करता है। - शाद:
00003-of-000099वें अंश को दर्शाता है।नंबर 00001 से शुरू होता है00000 नहीं।
मानक में एक महत्वपूर्ण अस्वीकरण भी है:इसे "विख्यात" कहा जाता है।क्योंकि मौजूदा Gguf फ़ाइल बहुत विविध है।इसलिए फ़ाइल नाम में क्या है, मेटाडाटा पढ़ने का नियमित अनुमान नहीं है।फ़ाइल general.basenameमुझे नहीं पता।general.size_labelमुझे नहीं पता।general.finetune यह अधिकार है।
V. Q4 K M: फाइल नाम का सबसे लंबा हिस्सा संपीड़न दर है
यह वह है जो अभ्यास में आपके अनुभव को सबसे अधिक प्रभावित करता है, और वह जो भी स्पष्ट नहीं हुआ है।यह इंगित करता है कि कितना वजन मात्रात्मक है।
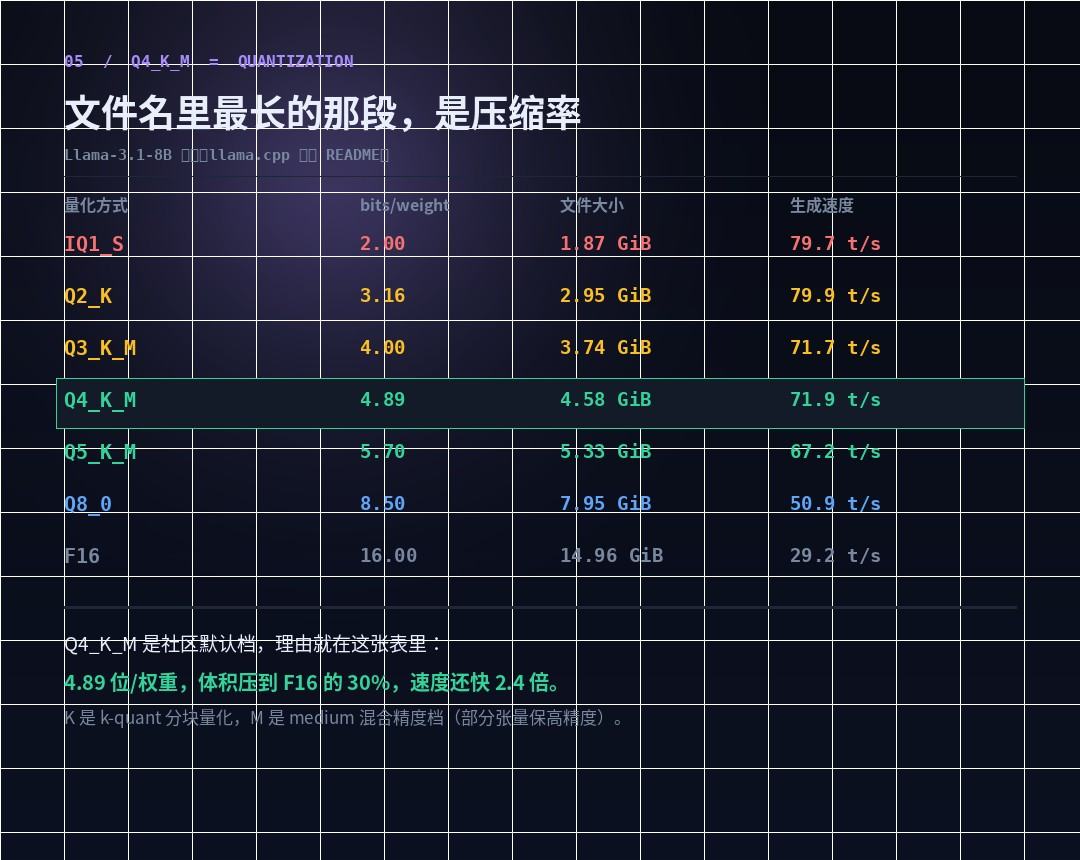
llama.cpp आधिकारिक README ने एक वास्तविक सर्वेक्षण बनाने के लिए Llama-3.1-8B का इस्तेमाल किया और मैंने कुछ कदम उठाए (मूल मॉडल 32.1 जीबी):
| मात्रा | बिट्स / राइट | फाइल साइज | उत्पन्न गति |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 जीबी | 79.7 t/s |
| Q2 K | 3.16 | 2.95 गिब | 79.9 t/s |
| Q3 K M | 4.00 | 3.74 गिब | 71.7 t/s |
| Q4 K M | 4.89 | 4.58 जीबी | 71.9 t/s |
| Q5 K M | 5.70 | 5.33 गिब | 67.2 t/s |
| Q8 0 | 8.50 | 7.95 गिब | 50.9 t/s |
| F16 | 16.00 | 14.96 गिब | 29.2 t/s |
Q4 K M इस तालिका में सभी कारणों के लिए सामुदायिक डिफ़ॉल्ट फ़ाइल बन जाता है:4.89 बिट्स / वजन, F16 के 30% के बैकलॉग के साथ, जो 2.4 गुना तेज है।Q8 0 तक, वॉल्यूम दोगुना हो जाता है और 30% तक गिर जाता है, और गुणवत्ता में बदलाव अधिकांश लोगों को नहीं पता; IQ1 S के नीचे, वॉल्यूम थोड़ा कम है, और गुणवत्ता जोखिम बहुत अधिक है।
आप अपना नाम कैसे पढ़ सकते हैं?
- रानी = नियमित मात्रा;IQ = भौतिकता मैट्रिक्स को मात्रात्मक (i-quant) कहा जाता है, जिसमें बेहतर गुणवत्ता और समान अंकों में थोड़ा धीमी गति होती है।
- संख्या = लक्ष्य अंक। Q4 4 बिट है, Q8 8 बिट है।
- K = k-quant, ब्लॉक quantification (ब्लॉक-वार), पुराने
_0/_1श्रृंखला अधिक विस्तृत है। - S / M / L = छोटे / मध्यम / बड़े, मिश्रित परिशुद्धता स्लॉट।M उन्हें उच्च रखने के लिए संवेदनशील lids में से कुछ को बाहर निकालता है।तो यह Q4 भी है, K M K S से थोड़ा बड़ा है।
कई लोग नहीं जानते हैं:क्वांटिफिकेशन को एक केस-बाय-केस आधार पर अनुकूलित किया जा सकता है।आधिकारिक उपकरण प्रकार से विभिन्न प्रकार के पदनाम का समर्थन करते हैं, जैसे: attn_v और ffn_down अलग से Q5 K M के रूप में सेट करता है, जबकि बाकी Q4 K M के रूप में बनाए रखा गया है; यह भी एक नियमित बैच संख्या से सेटिंग का समर्थन करता है। यही कारण है कि "Q4 K M" फाइल का प्रकार उस फाइल के आकार से अलग है जिसे लोग दबाव डालते हैं।यह एक डिफ़ॉल्ट रणनीति है, एक सटीक विनिर्देश नहीं है।
VI. MTP: एक छोटा मॉड्यूल जिसे "Gues next word" कहा जाता है।
यह अंतिम है जो वास्तव में मॉडल के रूप में उपयोग करना आसान है।फाइल रोल टैगमुझे नहीं पता। GGF दस्तावेज़ में mtp साइडकार (accompanied मॉड्यूल) के रूप में परिभाषित, कहावत:
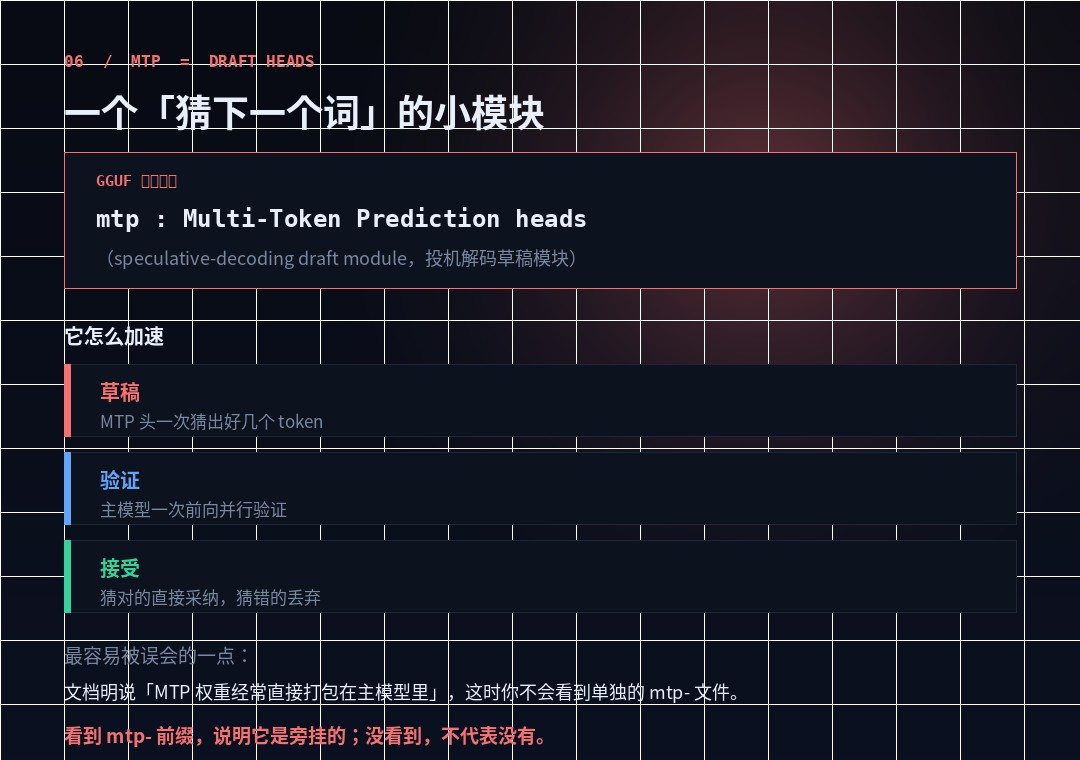
मल्टी टोकन प्रीडेशन हेडर, मसौदा मॉड्यूल फॉर स्पेक्युलेटिव डिकोडिंग, जिसे बेस मॉडल मिलान आर्किटेक्चर और संस्करणों के साथ लोड करने के लिए डिज़ाइन किया गया है।
यह सरल है:आइए अगले कुछ टोकनों का अनुमान लगाते हैं और मुख्य मॉडल को समानांतर में चलाने दें।सही प्रत्यक्ष गोद लेने, गलत ड्रॉप। चूंकि सत्यापन हमेशा एकाधिक टोकनों की पुष्टि कर सकता है, इसलिए प्रति टोकन समय में औसत गिरावट - यह स्पेक्युलेटिव डिकोडिंग का पूरा सिद्धांत है।
लेकिन दस्तावेज़ में एक वाक्यांश है जिसे इस अनुभाग में सबसे अधिक याद किया जाना चाहिए:"MTP भार अक्सर सीधे मूल मॉडल में पैक किए जाते हैं, जिसके मामले में कोई अलग Mtp-side फ़ाइल नहीं है।
इसलिए सही समझ है:हाँ। mtp- उपसर्ग, यह दर्शाता है कि वे बाहर हैं; कभी नहीं देखा, मतलब कोई नहीं है।इसलिए मॉडल सूची में MTP की तलाश में अक्सर नहीं पाया जाता है - यह पहले से ही मुख्य फ़ाइल में है।
अन्य साइडकार है ... mmproj(multimodal प्रोजेक्टर, multimodular प्रोजेक्टर), दृश्य और ऑडियो एनकोडर प्लस प्रक्षेपण परत।यह आमतौर पर एक स्टैंड-अलोन दस्तावेज़ है जिसे बेस मॉडल के साथ लोड किया जाना चाहिए।इसलिए यदि आप जीजीएफ के बहु-मोड मॉडल को नीचे रखते हैं और आपको पता है कि आप मानचित्र नहीं देख सकते हैं, तो यह शायद mmproj फ़ाइल लापता है।
VII पांच अक्षरों की पूर्ण रीडिंग
उपरोक्त सभी एक पूर्ण पठन है। मान लीजिए कि आप इस फाइल का नाम देखें:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| स्निपेट | यह कौन सा मंजिल है? | Annotation |
|---|---|---|
mtp- | फाइल रोल | संलग्न speculative decodement मॉड्यूल को मुख्य मॉडल से मिलान करने की आवश्यकता है |
Qwen3 | आदर्श पहचान | बेस मॉडल का नाम |
30B | आकार | कुल मापदंड 30 अरब मैंने निर्णय नहीं लिया है। |
A3B | गणना | एक बार तीन अरब डॉलर। कितनी तेजी से आप चलाने का फैसला किया? |
v1.0 | संस्करण | वजन संस्करण |
Q4_K_M | भंडारण | 4.89 बिट्स / वजन, मध्यम मिश्रण परिशुद्धता |
.gguf | कंटेनर | llama.cpp. |
दस्तावेज़ का सारांश:30 बिलियन का कुल पैरामीटर और एक समय में 3 बिलियन का एक एमओई मॉडल जीजीयूयूयूएफ कंटेनर में लगभग 4.9 स्थानों पर दबाया गया था, जिसमें एक अतिरिक्त सट्टा डीकोडेड त्वरण मॉड्यूल था।
VIII सबसे आम दुर्घटनाओं में से चार
- A3B को 3B मॉडल के रूप में माना जाता है।यह स्मृति नहीं है। 30B का वजन कम नहीं है और 4GB अभी भी दिखाई दे रहा है।
- E4B एक "4B छोटे मॉडल" के रूप में।यह लोचदार मॉडल का सबसे बड़ा सेट है। E4B में E2B के सभी पैरामीटर शामिल हैं। उस पर कम फिट 2B दबाते हैं, 4B रन नहीं।
- एक मॉडल के रूप में GGF का उपयोग करें।एक ही मॉडल F16, Q8 0, Q4 KM कई GGUUFs हो सकता है।GGUF एक कंटेनर है और मात्राकरण सामग्री है।"Q4 और GGUF अच्छा" पूछ रहा है "बोतल और पानी अच्छा".
- यह पोस्ट हमारे विशेष कवरेज सीरिया प्रोटेस्ट 2011 का हिस्सा है।आधिकारिक बयान कि सौदा पूरी तरह से वैध नहीं है। सटीक जानकारी के साथ फ़ाइल के मेटाडाटा तक पहुंचने के लिए नियमित नियम को न लिखें।
और वहाँ एक छिपा पांचवां है:रखना 8x7B 7Bयही है "8 विशेषज्ञों प्रत्येक 7B." कुल 56B GGUF में <expertCount>x<count> x गुणन है।
IX-PPOSE of PRACTICAL ADJUSTMENTS
अंत में, एक अनुक्रम दें जिसका पालन किया जा सकता है। किसी भी मॉडल का नाम देखें और इस क्रम में खुद से पूछें:
- पहले कंटेनरों पर नज़र डालें और quantify करें।
.gguf+Q4_K_Mइसका मतलब यह है कि यह एक स्थानीय रन-ऑफ मास संस्करण है, और गुणवत्ता और मात्रा पहले से ही रिलीज के समय निर्धारित की जाती है। - फिर से समग्र पैरामीटर पढ़ें।यह तय करें कि आपकी उपस्थिति / राम पर्याप्त है। यह एक कठिन सीमा है। यह पर्याप्त नहीं है।
- देखें कि क्या यह मो है।हाँ।
A??Bविवरण सक्रियण मापदंडों पर आधारित है, लेकिन स्मृति अभी भी कुल मापदंडों पर आधारित है। - देखें कि क्या ई उपसर्ग है।हाँ।
Eयह इंगित करता है कि यह एक लोचदार मॉडल है और वास्तविक उपस्थिति नाममात्र मूल्य के नीचे अच्छी तरह से हो सकती है - यह निर्धारित करता है कि यह सेल फोन तक पहुंच सकता है। - साइडकार पर पिछले देखो।हाँ।
mmproj-हाँ!mtp-याद रखें मिलान; न तो इसका मतलब यह है कि कोई त्वरण नहीं है।
मॉडल का नाम एक पैरामीटर तालिका नहीं है, लेकिन एक लेबल है। लेबल आपको अगले गलत फाइल से दूर रखने के लिए काम करता है, इसके स्कोर की गणना नहीं करता है।
यह हमेशा चल रहा है। लेकिन लेबल को सही ढंग से पढ़ने के लिए, कम से कम आपको 15GB डाउनलोड करने से पहले पता चल जाएगा कि यह स्थापित नहीं किया जा सकता है।इस बचाया समय, किसी भी बेंचमार्क स्कोर से अधिक है।