
B, GGUF, MTP, A3B, E4B: 5 karakter dalam nama model, bukan satu. Ya.
Mari kita mulai dengan kesimpulan yang menyimpan setengah dari kebingungan:Lima hal ini tidak sama sekali dimensi.B adalah kata, A3B dan E4B adalah "kuantitas", GGUF adalah wadah, MTP adalah plugin. Bahkan, mereka menjawab pertanyaan yang sama sekali berbeda.
Divisi khusus tenaga kerja adalah sebagai berikut:"B", "Seberapa besar", "A3B", "Berapa banyak pekerjaan", "E4B", "berapa banyak yang benar-benar dalam memori", "GGUF", "Apa yang ada di dalamnya", "MTP", "bagaimana percepatan".Empat atau lima dokumen muncul bersamaan karena mereka perlu diekspresikan secara bersamaan - tapi kebingungan sering terjadi ketika mereka diperlakukan sebagai jenis informasi yang sama.
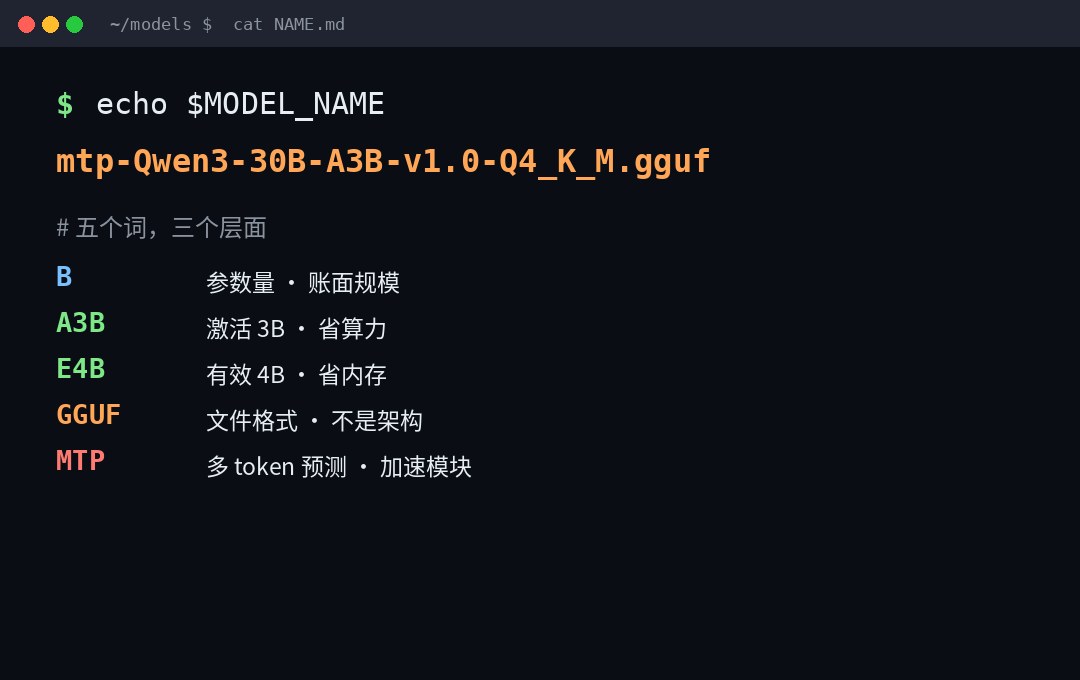
Satu, B: itu hanya satu miliar.
B adalah miliar, satu miliar.7B Ini adalah parameter 7 miliar dolar.235B Itu 235 miliar. Ini adalah satu set skala prefix dalam kode nama GGUF:K RibuanM Jutaan,B Satu miliar.T Trilyunan dolar,Q Miliaran.
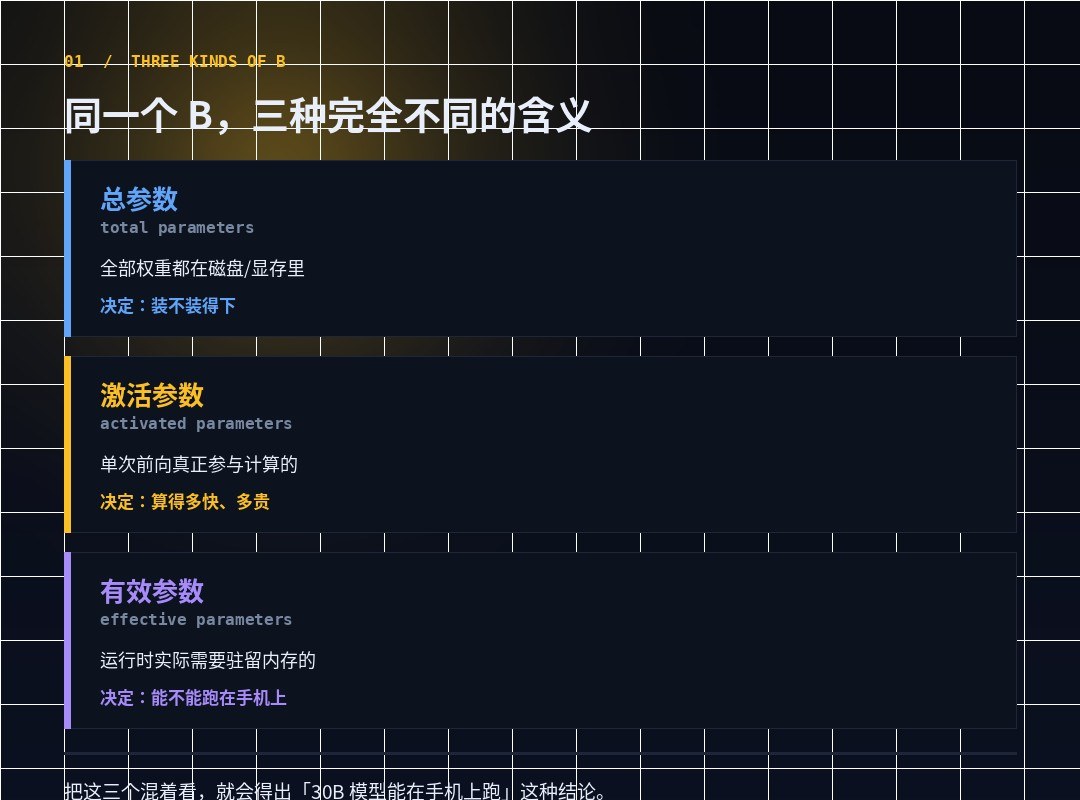
Sepertinya yang paling sederhana, sebenarnya memiliki tiga arti yang sama sekali berbeda. Ini adalah hal pertama yang harus jelas:
| Menulis | Artinya | Memutuskan apa? |
|---|---|---|
30B | Parameter overall: berat penuh | Kau bisa memainkannya?(disk, terlihat) |
30B-A3B | Total 30B, satu aktivasi 3B | Seberapa cepat? Seberapa mahal? |
E4B | Parameter valid: kehadiran aktual pada saat operasi | Dapatkah Anda menjalankan di telepon? |
Jika Anda melihat tiga baris ini bersama-sama, Anda akan mendapatkan kesimpulan bahwa model 30B dapat berjalan pada ponsel.Mungkin benar, tapi itu tidak sama dengan 30B yang Anda pikir itu.
A3B: parameter umum dan parameter aktivasi bukan sekali ya.
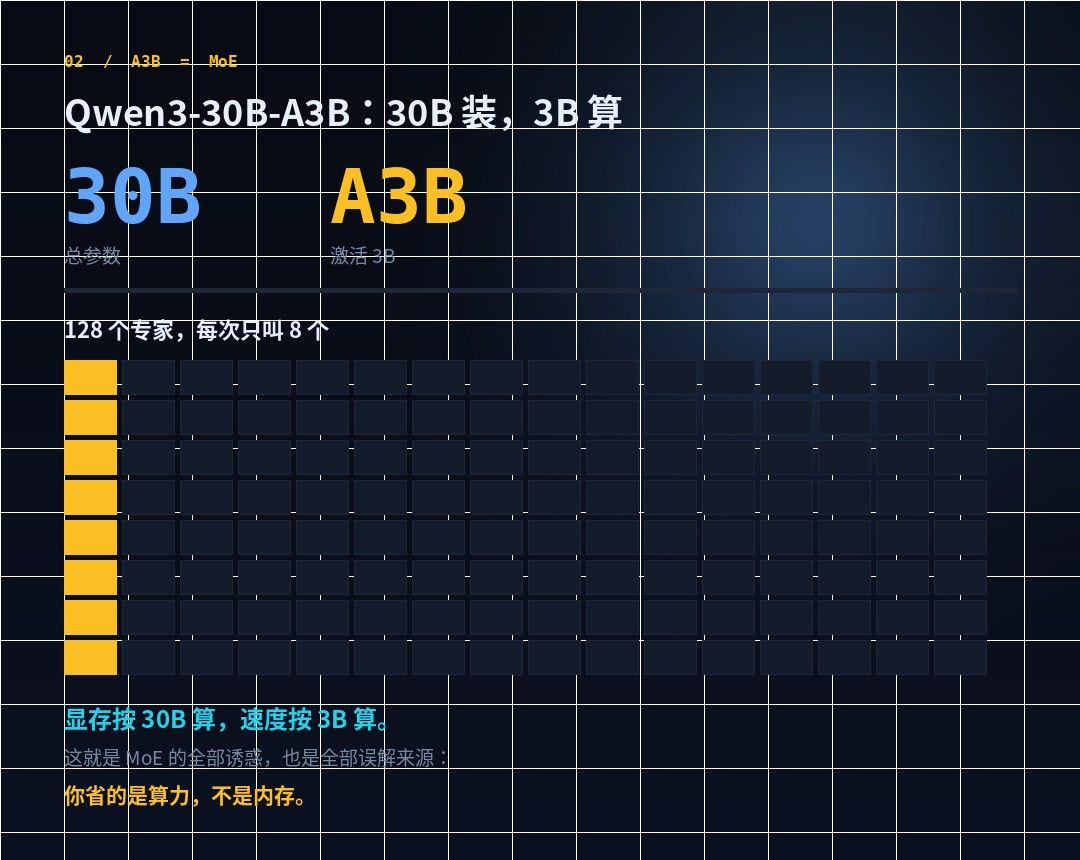
Qwen3 sangat jelas tentang nama model:Qwen3-235B-A22B adalah model besar dari "233,5 miliar parameter total, 22 miliar parameter aktif", dan Qwen3-30B- A3B adalah MoE kecil dari "30 miliar parameter total, 3 miliar parameter aktif".
Rincian teknis juga spesifik: 30B-A3B memiliki 48 lantai, Q / K.V kepala menghitung 32 / 48 dari 128 spesialis diaktifkan, konteks 128K. 235B-A22B adalah lantai 94, 64 / 4 kepala, juga 128 ahli diaktifkan 8.
A3B, arti sebenarnya dari tanda ini adalah:Tampilkan 30B, kecepatan 3B.
Itu semua godaan dari MoE, semua sumber kesalahpahaman.Kau menyimpan uang, bukan memori.Banyak orang melihat A3B dan berpikir itu adalah model 3B, dimuat pada mesin 4GB, dan kemudian menemukan mustahil untuk memuat. Tak satu pun dari bobot kecil, tetapi tidak semua perhitungan ke depan.
Seiring dengan mudah mengabaikan menulis: SizeLabel dari GGF adalah <expertCount>x<count><scale-prefix>♪ And so ♪ 8x7B Ini disebut "8 ahli x 7B", total 56B.Itu adalah ellipsis perkalian atau perkalian.Mixtral- 8x7B sering disalahartikan sebagai "model 7B" dan parameter total aktual adalah 56B.
III. E4B: E efisien, bukan "lebih kecil"
Ini salah satu yang paling mudah dibaca. Dokumen Gemma 3n jelas:
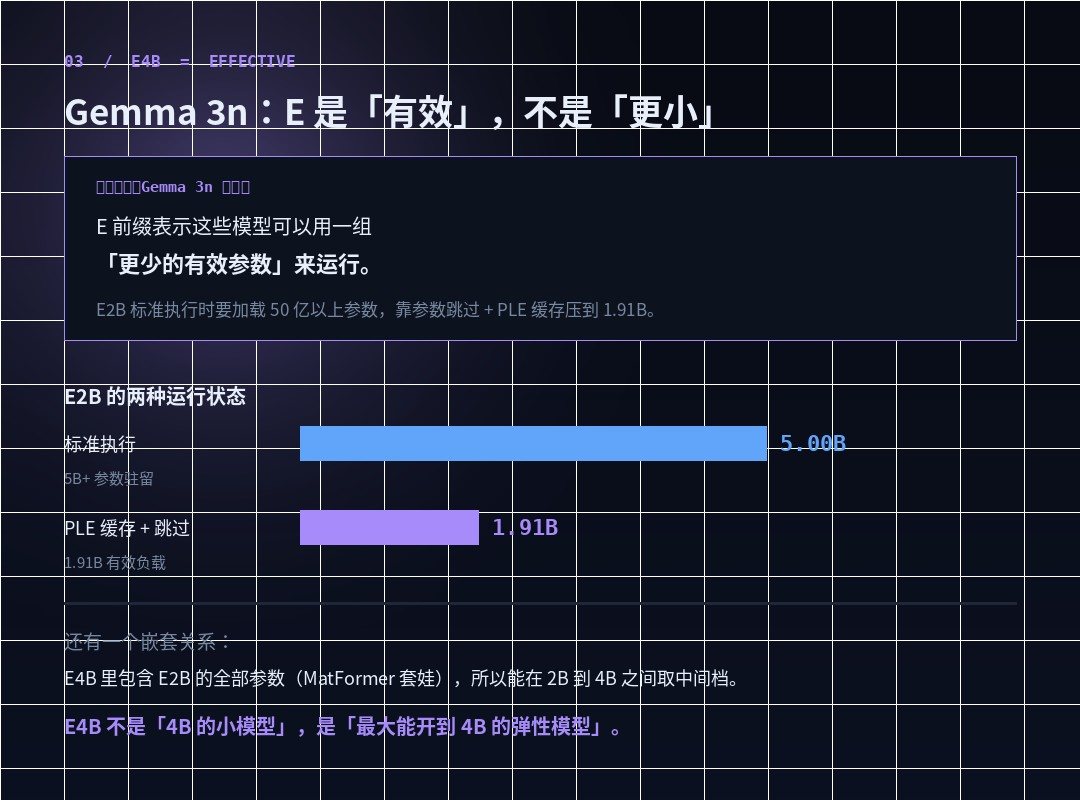
Tanda parameter untuk model Gemma 3n (misalnya E2B, E4B)Kurang dariJumlah total parameter sebenarnya termasuk dalam model. Prefiks E mengindikasikan model-model ini dapat dijalankan dengan seperangkat parameter "kurang aktif".
Sampai sejauh mana? Dokumen memberikan nomor:Standar E2B diimplementasikan dengan memuat lebih dari 5 miliar parameter, melewati dan PLE cache berdasarkan parameter untuk menekan muatan memori aktif menjadi 1.91B.
Perhatikan kata-kata utama dari kalimat ini:Model itu sendiri tidak menjadi lebih kecil, ia telah menjadi lebih kecil dalam hal kehadirannya ketika berjalan.
Hal ini dapat dicapai melalui dua mekanisme:
- PLE Cache (Per- Layer Embeding).Setiap lapisan parameter tertanam dapat dihasilkan secara terpisah dari memori model, cached ke penyimpanan lokal cepat, dan ditambahkan ke setiap lapisan ketika berjalan.Hal ini sama dengan meminta bagian ini dari parameter keluar dari memori.
- Mates.Ada beberapa model kecil yang tertanam dalam model besar, yang tidak perlu untuk mengaktifkan parameter luar ketika dideduksi. Jadi Anda dapat mengambil setiap tengah antara 2B dan 4B.
Ini mengarah ke fakta yang berlawanan:E4B berisi semua parameter E2B.Tidak dua berdiri saja model, dua slot untuk model elastis yang sama. Jadi istilah yang tepat bukan "E4B adalah 4B model kecil" tapi "E4B".E4B adalah model elastis dengan kekuatan maksimum menuju 4B.Aku tidak akan kemana-mana.
Ini memiliki dampak besar pada penilaian bahwa "bisa saya jalankan pada peralatan saya":E4B dapat menjalankan E2B seperti pada peralatan peralatan rendah dan memperluas ke 4B pada peralatan tinggi.Dan A3B tidak memiliki elastisitas ini - itu 30B, itu hanya biaya - menghemat.
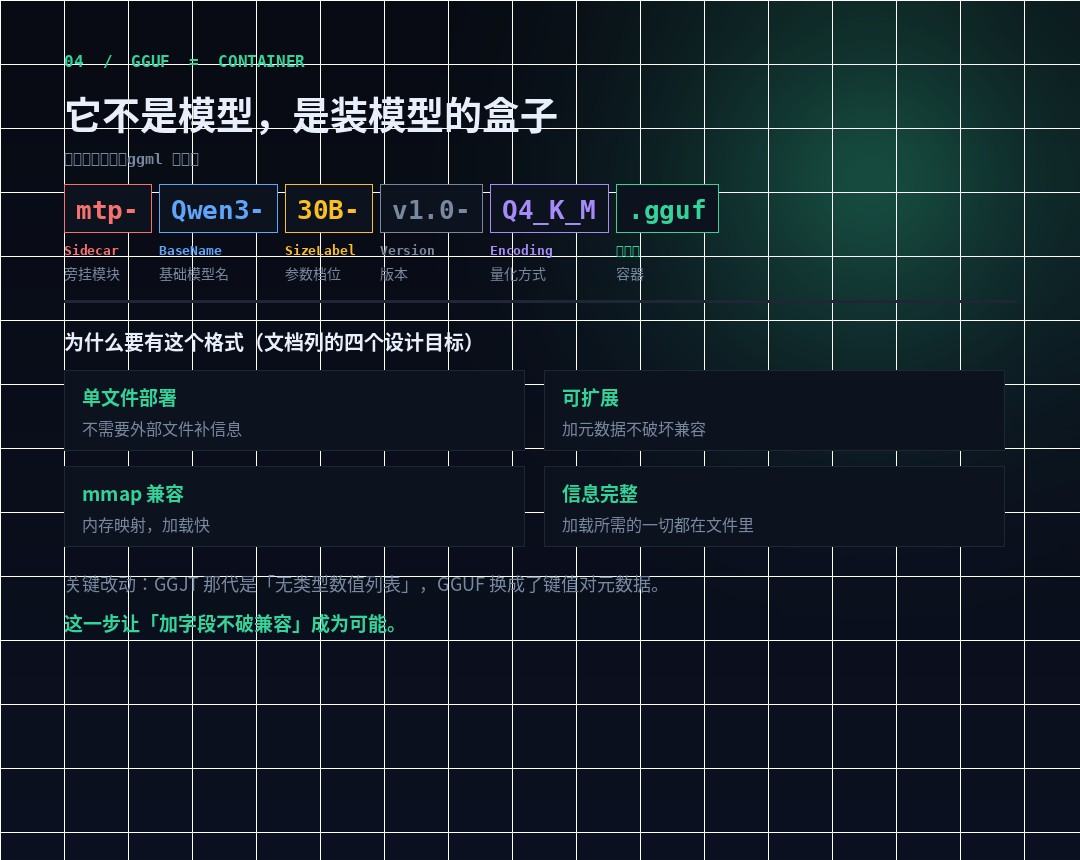
Ini bukan model, ini kotak model.
Yang pertama tiga adalah ukuran model, yang telah mengubah dimensi dari GGUF:Ini adalah format berkas.Tepatnya, GGUUF adalah format penyimpanan model untuk GGML dan penerapannya (llama.cpp).
Ini menggantikan format ggML, GGMF, GGJT, tiga generasi. Target desain resmi adalah empat, masing-masing sesuai dengan titik nyeri masa lalu:
| Mendesain tujuan | Menangani apa? |
|---|---|
| Penyebaran berkas tunggal | Tak ada dokumentasi tambahan yang diperlukan, distribusi langsung dan pemuatan |
| Expandable | Menambahkan metadata baru tidak merusak kompatibilitas model lama |
mmap Kompatibilitas | Peta Memori dimuat, cepat |
| Informasi lengkap | Semua yang kau butuhkan ada dalam berkas. Pengguna tidak perlu memasoknya. |
Perbedaan kunci antara itu dan generasi terakhir GJT hanyalah satu kalimat, tapi itulah kuncinya:Hiperparameter diubah dari daftar nilai tanpa tipe ke kunci ke metadata.Langkah ini memungkinkan untuk "menambah bidang ketidakcocokan" - setelah sebuah bidang ditambahkan, semua pemecah tua harus diubah.
Bagaimana kau mengejanya?
Kode penamaan resmi adalah:
[].ggufAmbil contoh nyata.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-Sidecar (modul baris, lihat bagian selanjutnya)Qwen3BaseName (nama model dasar)27BSizeLabel (slot parameter)v1.0Versi (versi)Q4_K_MEncoding (weight encoding / quantification)
Ada dua komponen yang tidak sering muncul untuk diketahui:
- Tipe.:
LoRAIni berarti adaptor, bukan model lengkap;vocabmengindikasikan berkas kosakata. - Shad.:
00003-of-00009Menunjukkan fraksi, 3 dari 9 Perhatian.Numbering dimulai di 00001Tidak 000.
Ada juga penyangkalan penting dalam norma:Ini disebut "tidak akan benar-benar dapat diuraikan di alam liar"., karena berkas gguf yang ada terlalu beragam.Jadi jangan menulis tebakan biasa tentang apa yang ada dalam nama berkas, baca metadata.Berkas general.basenameAku tidak tahu.general.size_labelAku tidak tahu.general.finetune Ini otoritas.
V. Q4 K M: Bagian terpanjang dari nama berkas adalah tingkat kompresi
Ini adalah salah satu yang paling mempengaruhi pengalaman Anda dalam praktek, dan salah satu yang tidak ada yang jelas.Ini menunjukkan berapa banyak berat badan telah diukur.
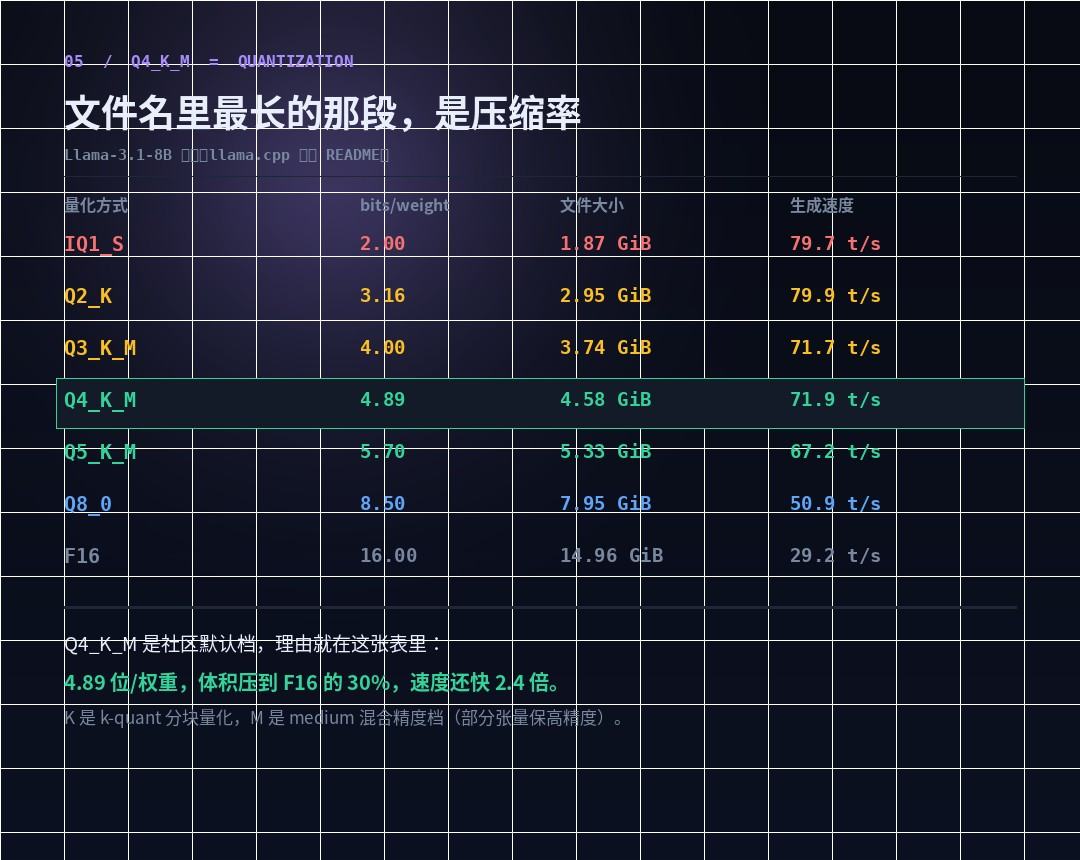
lama.cpp README resmi digunakan Llama - 3.1-8B untuk membuat survei faktual, dan saya mengambil beberapa langkah (model asli 32.1 GB):
| Kuantifikasi | bit / right | Ukuran Berkas | Buat Kecepatan |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79,7 t / s |
| Q2 K | 3.16 | 2.95 GiB | 79,9 t / s |
| Q3 K M | 4.00 | 3.74 GiB | 71.7 t / s |
| Q4 K M | 4.89 | 4.58 GiB | 71.9 t / s |
| Q5 K M | 5.70 | 5.33 GiB | 67.2 t / s |
| Q8 0 | 8.50 | 7.95 GiB | 50.9 t / s |
| F16 | 16.00 | 14.96 GiB | 29.2 t / s |
Q4 K M menjadi file baku komunitas untuk semua alasan dalam tabel ini:4,89 Bits / weight, dengan backlog dari 30% dari F16, yang 2.4 kali lebih cepat.Sampai Q8 0, volume ganda dan tetes dengan 30%, dan perubahan kualitas kebanyakan orang tidak tahu, ke IQ1 S, volume sedikit kurang, dan risiko kualitas jauh lebih tinggi.
Bagaimana Anda membaca nama Anda?
- Ratu = Kuantifikasi reguler;IQ = Matriks materialitas diukur (i-quant), dengan kualitas yang lebih baik dan sedikit lebih lambat kecepatan dalam digit yang sama.
- Nomor = target digit. Q4 adalah 4 bit, Q8 adalah 8 bit.
- K = k-quant, blok kuantifikasi (block-wise), lebih tua
_0/_1Serinya lebih rinci. - S / M / L = kecil / media / besar, slot presisi campuran.M mengambil beberapa kelopak sensitif untuk membuatnya tetap tinggi.Jadi juga Q4, K M sedikit lebih besar dari K S
Ada fakta lain bahwa banyak orang tidak tahu:Kuantifikasi dapat disesuaikan pada kasus-oleh-kasus.Perkakas resmi mendukung sebutan dari tipe yang berbeda dengan tipe, seperti: attn_v dan ffn_down Seting secara terpisah sebagai Q5 K M, sementara sisanya dipertahankan sebagai Q4 K M; juga mendukung pengaturan dengan nomor batch biasa. Dan itulah mengapa jenis berkas "Q4 K M" yang sama berbeda dari ukuran berkas yang ditekan orang.Ini adalah strategi standar, bukan spesifikasi yang tepat.
VI.
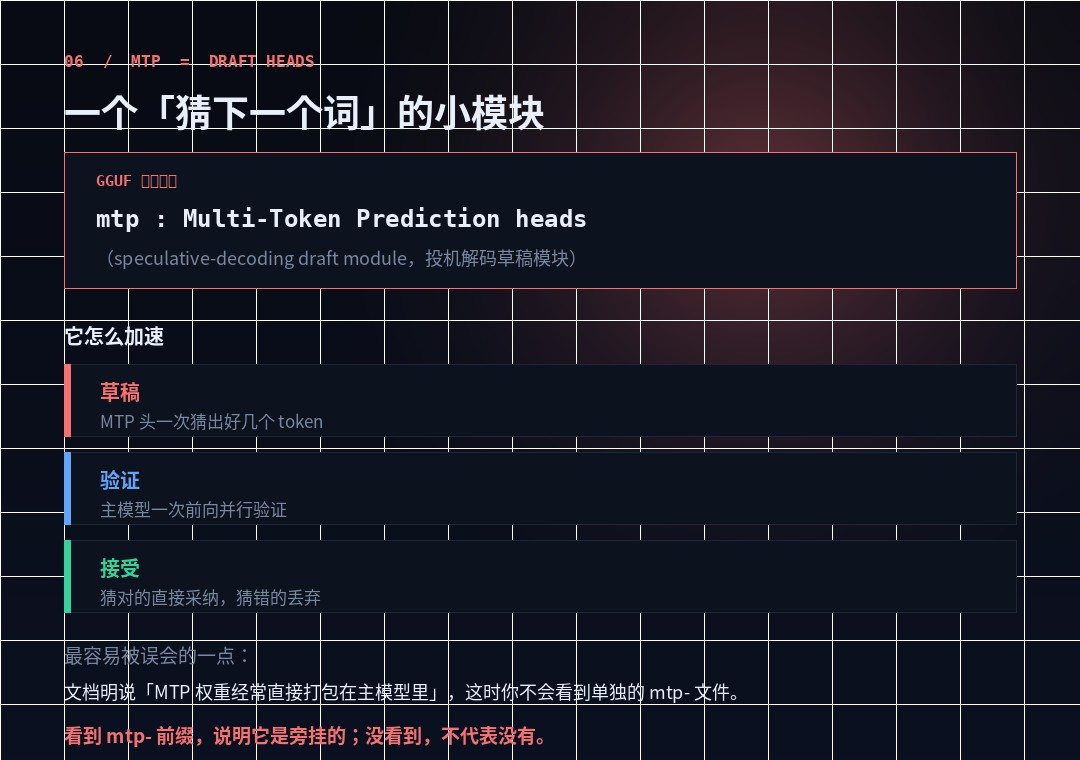
Ini yang terakhir yang mudah digunakan sebagai model, sebenarnya.Tag Peran BerkasAku tidak tahu. Dalam dokumen GGF mtp Didefinisikan sebagai Sidecar (modul ditemani), menyatakan:
Kalikan-Token Predation Header, modul rancangan untuk decodering spekulatif, dirancang untuk dimuat dengan model dasar cocok arsitektur dan versi.
Sederhana:Mari kita tebak beberapa token berikutnya, dan biarkan model utama berjalan secara paralel.Adopsi langsung, drop salah. Karena verifikasi selalu dapat mengkonfirmasi beberapa token, rata-rata penurunan waktu per token -- ini adalah prinsip keseluruhan dari decodering spekulatif.
Tapi ada frase dalam dokumen yang harus paling diingat dalam bagian ini:"MTP bobot sering dikemas langsung ke model dasar, dalam hal ini tidak ada file mtp- terpisah."
Jadi pemahaman yang benar adalah:Ya. mtp- Prefiks, menunjukkan bahwa mereka berada di luar; tidak terlihat, tidak berarti tidak ada.Itulah mengapa mencari MTP dalam daftar model seringkali tidak ditemukan. Ini sudah ada di berkas utama.
Sisi lain adalah... mmproj(Proyektor multimodal, proyektor multimodular), enkoder visual dan audio ditambah lapis proyeksi.Ini biasanya dokumen stand- alone yang harus dimuat dengan model dasar.Jadi jika Anda meletakkan model multi- mode dari GGF dan Anda tahu Anda tidak dapat melihat peta, itu mungkin hilang file mmproj.
VII. Pembacaan penuh dari lima karakter
Semua yang di atas adalah bacaan lengkap. Misalkan Anda melihat nama berkas ini:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Snippet | Lantai berapa itu? | Anotasi |
|---|---|---|
mtp- | Peran Berkas | Modul decodement spekulatif yang terpasang perlu cocok dengan model utama |
Qwen3 | Identitas Model | Nama Model Dasar |
30B | Ukuran | Total parameter 30 miliar Aku telah memutuskan untuk tidak berpura-pura. |
A3B | Hitung | Tiga miliar kali. Seberapa cepat kau memutuskan untuk lari? |
v1.0 | Versi | Versi Berat |
Q4_K_M | Penyimpanan | 4,89 bit / weight, perpaduan presisi sedang |
.gguf | Kontainer | Untuk llama. |
Ringkasan dokumen:Sebuah parameter total dari 30 miliar dan model MoE dari 3 miliar pada suatu waktu ditekan untuk sekitar 4.9 tempat ke dalam GGUUF kontainer, dengan tambahan spekulatif decode akselerasi modul.
VIII. Empat dari kesalahan yang paling umum
- Pertimbangkan A3B sebagai model 3B.Ini bukan memori. 30B tidak memiliki berat badan lebih sedikit, dan 4GB masih terlihat.
- E4B sebagai "4B model kecil".Ini adalah set terbesar model elastis. E4B berisi semua parameter E2B. Lower cocok di atasnya tekan 2B, bukan 4B run.
- Gunakan GGF sebagai model.Model yang sama dapat F16, Q8 0, Q4 K M beberapa GGUUFs.GGUF adalah wadah dan kuantifikasi adalah konten.Meminta "Q4 dan GGUF baik" seperti bertanya "Botol dan air yang baik".
- Pos ini adalah bagian dari liputan khusus Protes Suriah 2011.Pernyataan resmi bahwa kesepakatan itu tidak sepenuhnya dapat dibaca. Jangan tulis aturan reguler untuk mengakses metadata berkas dengan informasi yang akurat.
Dan ada kelima tersembunyi:Taruh 8x7B Baca 7B.Itu "8 ahli masing-masing 7B". Total 56B. Dalam GGUF <expertCount>x<count> X adalah perkalian.
IX.
Akhirnya, memberikan urutan yang dapat diikuti. Lihatlah nama model apapun dan tanyakan pada diri sendiri dalam urutan ini:
- Pertama melihat kontainer dan mengukur.
.gguf+Q4_K_MIni berarti bahwa ini adalah versi massa lokal, dan kualitas dan volume telah ditetapkan pada saat rilis. - Baca parameter keseluruhan lagi.Putuskan apakah kehadiran Anda / RAM cukup. Ini ambang batas yang sulit. Ini tidak cukup.
- Lihat apakah itu Moe.Ya.
A??BKeterangan didasarkan pada parameter aktivasi, tapi memori masih didasarkan pada parameter total. - Lihat apakah ada awalan E.Ya.
EHal ini menunjukkan bahwa itu adalah model elastis dan bahwa kehadiran yang sebenarnya mungkin baik di bawah nilai nominal - ini menentukan apakah dapat mengakses ponsel. - Terakhir melihat Sidecar.Ya.
mmproj-Ingat untuk datang bersama-sama; ya.mtp-Ingat pencocokan; juga tidak berarti bahwa tidak ada percepatan.
Nama model bukan tabel parameter, tapi label. Label bekerja untuk menjauhkan Anda dari file yang salah berikutnya, tidak menghitung nilainya.
Selalu berjalan. Tapi untuk membaca label dengan benar, setidaknya Anda akan tahu sebelum mengunduh 15-GB yang tidak dapat dipasang...Ini menghemat waktu, lebih dari skor benchmark.