
GPT-6.1 Terra 不是骨折价,是这家终于把中间那层补上了
先说结论:GPT-6.1 Terra 是真的便宜,$1 输入 / $5 输出,比 GPT-6.1 Sol 正好砍一半。但它不是「骨折」,是「重新分层」。而且它不是这家最便宜的模型——同一个价目表往下还有一层,便宜十倍。
这两件事如果没搞清,你换模型的时候会换错方向:以为自己在捡漏,其实是在往中间那层挤。
一、先把「骨折」这个词拆了
官方的原话是这么写的:标准 API 价格比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%。
这个对比对象选得很讲究。Sol 是 $2 / $10,砍一半正好 $1 / $5,数字对得上。但它拿来当锚点的 GPT-5.6 Terra,在现在这张旗舰价目表上已经找不到了。我去翻了定价页,旗舰档只剩四个:Astra、6.1 Sol、6.1 Terra、6 Luna。
也就是说,这不是「同一个模型降价」,是「用一个新的便宜模型,替掉了一个已经下架的旧模型」。这两件事在采购上的含义完全不同:前者是存量客户省钱,后者是你要主动迁移。
还有个更没被提到的:它压根不是这家最便宜的。
二、四层价目表,跨度 100 倍
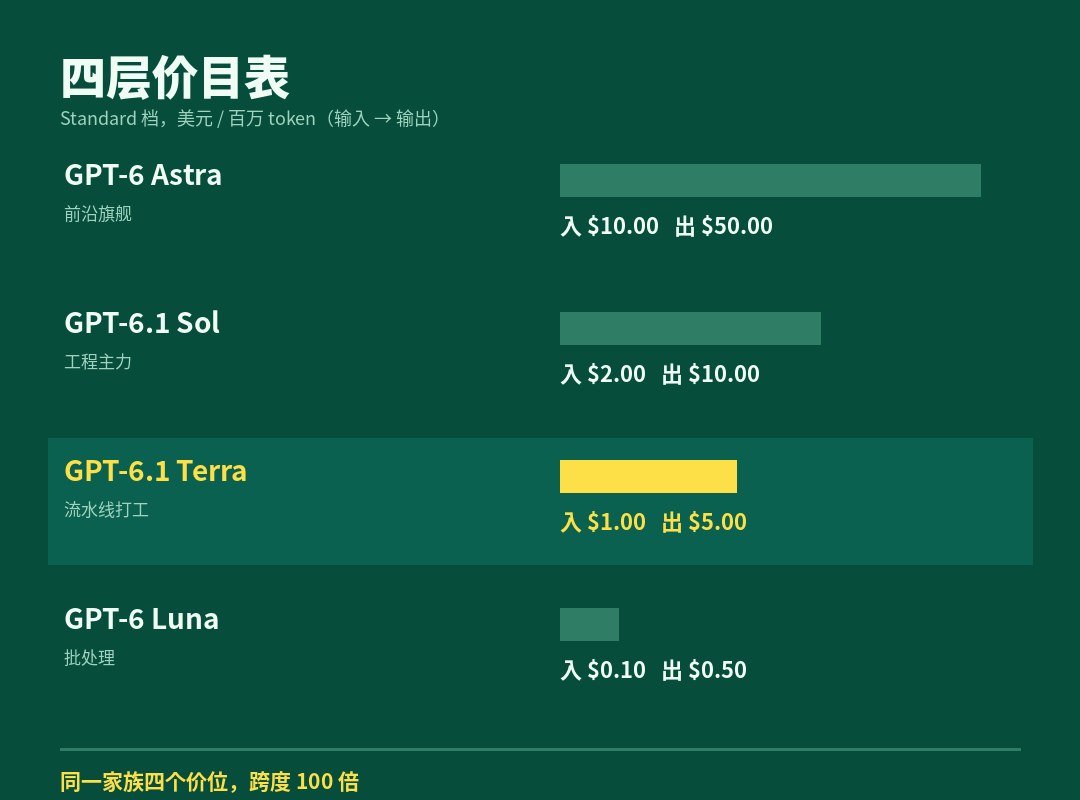
把 Standard 档拉平了看,是这个样子(美元 / 百万 token,输入 → 输出):
| 模型 | 输入 | 输出 | 缓存输入 | 定位 |
|---|---|---|---|---|
| GPT-6 Astra | 10.00 | 50.00 | 1.00 | 前沿旗舰 |
| GPT-6.1 Sol | 2.00 | 10.00 | 0.10 | 工程主力 |
| GPT-6.1 Terra | 1.00 | 5.00 | 0.05 | 流水线打工 |
| GPT-6 Luna | 0.10 | 0.50 | 0.01 | 批处理 |
从 Astra 到 Luna,输入价差 100 倍。Terra 卡在中间偏下的位置——比它便宜十倍的 Luna 就在下面一行,只是官方发布说明里一个字没提。
所以「骨折价」这个说法,准确讲是「中层降价」。它的真实作用是:把原来「要么用贵的旗舰、要么用凑合的旧款」这个二选一,换成了「中间有个够用的档」。
这对做 Agent 的人是好事,而且是真好事。但别把它理解成「全网最低」。
三、它的定位其实写在标题里:打工模型
官方描述里有个词用得很准——它擅长的是「填满工作日的那些沟通和电脑操作任务」:起草方案、看技术图纸、填表、剪视频。
注意这四个例子的共同点:都不需要「最聪明」,只需要「别犯蠢、别太慢、别太贵」。
这正是 Agent 流水线的真实需求。一个跑在后台、一天调用几千次的 Agent,它需要的不是奥赛金牌,是稳定的手和便宜的账单。Terra 就是冲这个来的。
官方给的数字里,最能说明这一点的是速度:比 GPT-6 Astra 和 GPT-6.1 Sol 都快三倍以上。
快三倍这件事,在 Agent 场景里的价值被严重低估。一个多步任务跑十轮工具调用,每轮慢两秒,整个任务就多二十秒——用户感知不到「模型更聪明了」,只感知到「怎么还没好」。
四、跑分里哪几个是真提升
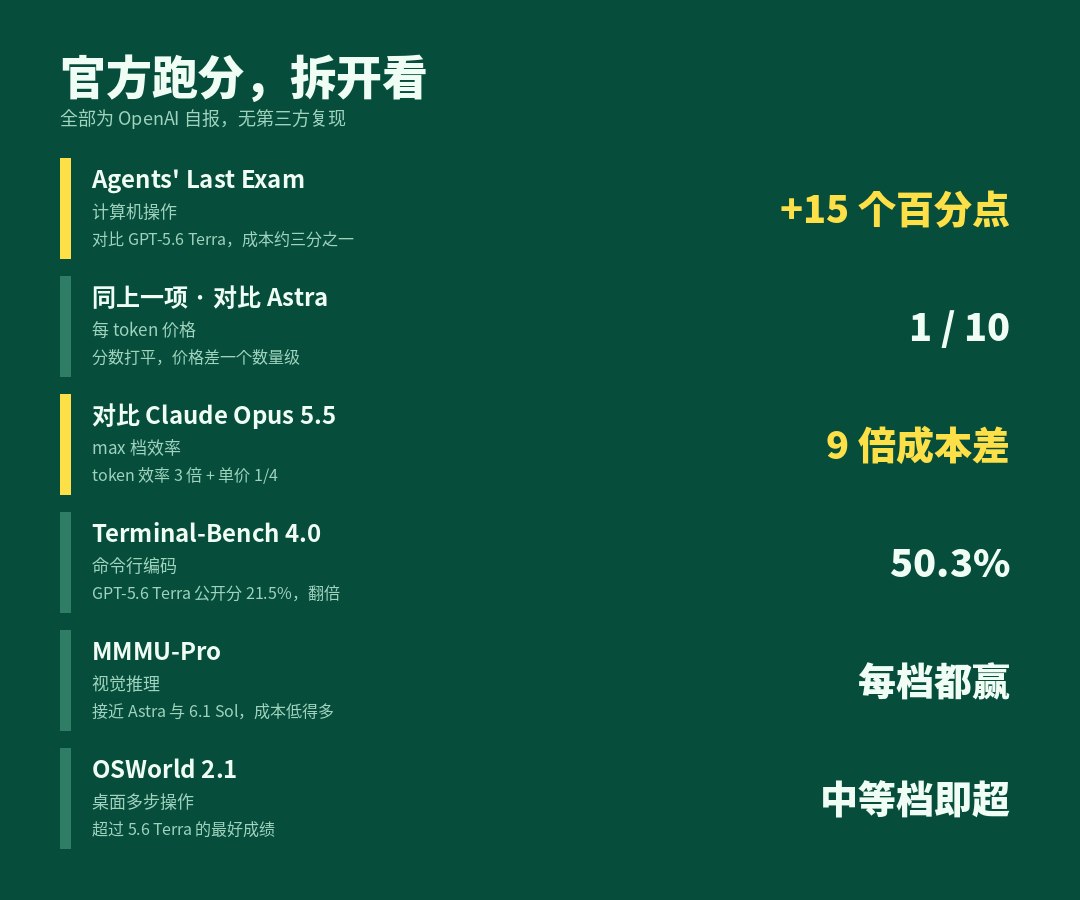
我把官方给的六个基准拆开看了一遍,按「可信度」排一下。
真提升:错误率
这个数字我最看重:在它内部那套「诱导出错」的测试集上,低推理档的错误率从 53.6% 掉到 16.7%,降了将近 37 个百分点;最高档从 22.3% 掉到 4.3%。
为什么这个比跑分重要?因为 Agent 场景里,错一次的成本不是重试一次,是整个流程要回滚。一个填表 Agent 把金额填错,后面人工复核、对账、退款,全是真实工时。错误率从一半掉到六分之一,这是质变。
真提升:命令行编码
Terminal-Bench 4.0,最高推理档 50.3%,对比 GPT-5.6 Terra 公开的 21.5%,翻了一倍多。
这个提升幅度大得有点可疑,但方向上合理:一半任务能跑通,说明它真的能读报错、改命令、再跑一遍。到 50% 这个水位,才勉强算「可以放进 CI 里试」。
要打折看的:和竞品的对比
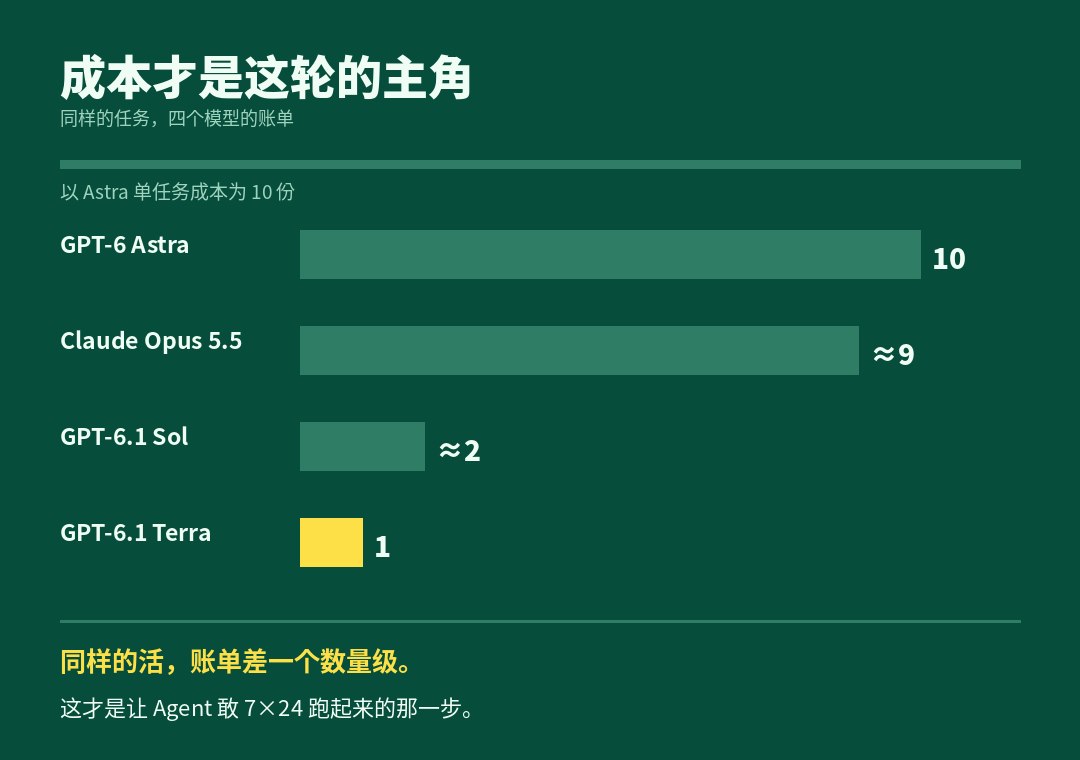
「比 Claude Opus 5.5 的 token 效率高 3 倍、单价是它的四分之一、单任务成本低约 9 倍」——这句话我算了一下,3 × 4 = 12,官方写的是约 9 倍。
差的那部分大概是任务长度分布和缓存命中率带来的,官方用「约」把它圆过去了。不是造假,但你得知道这种复合倍率是乘出来的,任一项口径变了,结论就变。看到「9 倍」这种数字,去问它乘的是哪两项。
没法验证的:全部
以上所有数字,全部来自 OpenAI 自报,没有第三方复现。LMArena 上还没有它的位置,独立测评机构也来不及跑。看这类发布文,我一般把自报分当成「上限」,把第三方分当成「实际」。
五、真正该警惕的不是价格,是那行小字
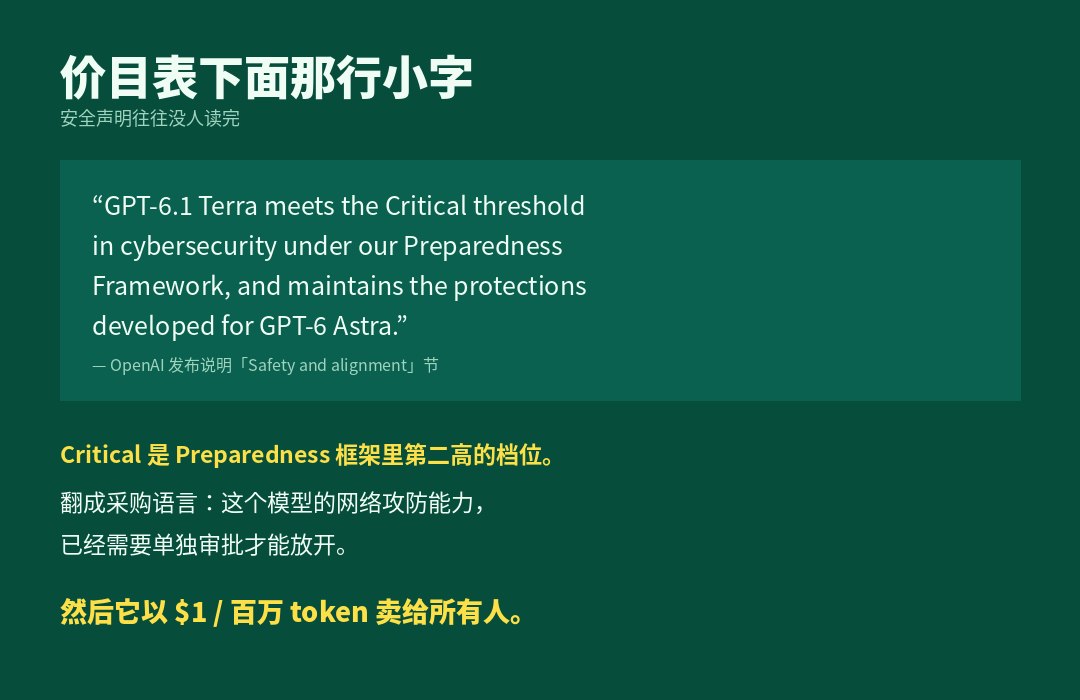
我读发布说明的时候,翻到「安全与对齐」那一节,看到一句很多人会一眼扫过去的话:
「GPT-6.1 Terra 在我们的 Preparedness 框架下,达到网络安全的 Critical 阈值,并保持为 GPT-6 Astra 开发的各项防护。」
Critical 是这套框架里第二高的档位——上面只剩一个「高于 Critical」。翻成采购语言:这个模型的网络攻防能力,已经跨过了需要单独评估、单独管控的那条线。
然后它以 $1 / 百万 token 的价格,卖给了所有人。
这两件事单独看都没问题。放一起看就有意思了:一个被自己家安全框架标为「Critical 级网络能力」的模型,现在成了全家族里性价比最高的通用模型。
我不打算在这里喊「AI 危险」,那没意义。但如果你是甲方安全负责人,这里有个具体的问题需要现在回答:当公司里任何一个开发都能用一杯咖啡的钱跑起一个 Critical 级网络能力的模型,你的边界管在哪一层?
上周微软那套框架给的答案是把权限从模型手里拿走(详见我上一篇)。Terra 这种定价,等于把这个答案的紧迫性又往前推了一格:能力在通胀,价格在通缩,这两条曲线交叉的地方,就是管控必须落地的地方。
六、什么人现在该换,什么人不该
该换的
- 跑批量文档处理的。读发票、填表、提取合同条款——这类任务对「聪明」要求低,对「稳定 + 便宜」要求高。$1 输入价配 16.7% 的错误率,这个组合目前是甜点。
- 做多步 GUI 自动化的。OSWorld 2.1 上它中等档就超过了上一代的最好成绩,而 GUI 自动化最怕的就是慢和贵。
- 把 Agent 当「基础设施」而不是「亮点功能」的团队。你需要的是一天跑十万次还不心疼的模型,不是一个能写诗但一次三毛钱的模型。
别急着换的
- 做最复杂编码任务的。官方自己说了,最难的编码活还是 Sol 和 Astra 更合适。Terra 的 50.3% 是「一半能过」,不是「都过」。
- 已经深度调过 Sol 的。换模型不是改个 model id 就完事——提示词、工具描述、重试策略、上下文裁剪,全都得重调。省下的那点 token 钱,可能不够两天的人力。
- 要发合规报告的。没有任何第三方复现,你的评估报告里写不了「经独立验证」。
还有一类特殊情况:如果你的业务量小,这次的降价对你几乎没意义。一天跑几百次调用,从 $2 降到 $1,一个月省下的钱不够买杯咖啡。这个价目表是给量大的团队看的。
七、最后一句话
这一轮发布,标题都盯着「骨折价」,但我看下来觉得真正的信号是另外三个:
- 中间档被做实了。原来只有「旗舰」和「凑合」两档,现在有了一个明确的「够用且便宜」。这对整个 Agent 生态是结构性利好。
- 价格战打到了第三层。前两家降价的时候,砍的是旗舰;这次砍的是主力档。主力档一降,靠「便宜」活着的那批小模型就没位置了。
- 能力和价格的剪刀差在扩大。Critical 级网络能力 + $1 定价,这个组合不是一家的问题,是整条产业链要面对的。
模型越便宜,Agent 越多;Agent 越多,能被自动化的事就越多。这不是一句感慨,是一道算术题。
至于 Terra 本身:它是一个好模型,价格也确实狠。但它不是「骨折」,是这家终于把中间那层补上了。你要做的不是冲进去抢,是回头看看自己那堆 Agent,哪些活本来就该交给一个便宜、稳定、快三倍的工人干。
该换的换掉,省下来的钱比你想象的多。剩下的,该用旗舰就用旗舰——别为了省钱,让一个打工模型去干总监的活。