
Indtast, output, cache liv: navnet på AI token regningen.
Lad os starte med resultaterne:Der er kun to ord i disse udtryk, der virkelig koster dig mere: "Cacheft" og "output" token.Resten er deres noter.
Jeg er blevet faktureret tre gange på to måneder, og det er det samme: Jeg tror, jeg sparer penge, og jeg betaler den fulde pris for det samme præfiks. Det er her, du kan besvare mindst et spørgsmål...Hvorfor har jeg 8.000 tokens på regningen, når jeg kun har sagt ét ord?
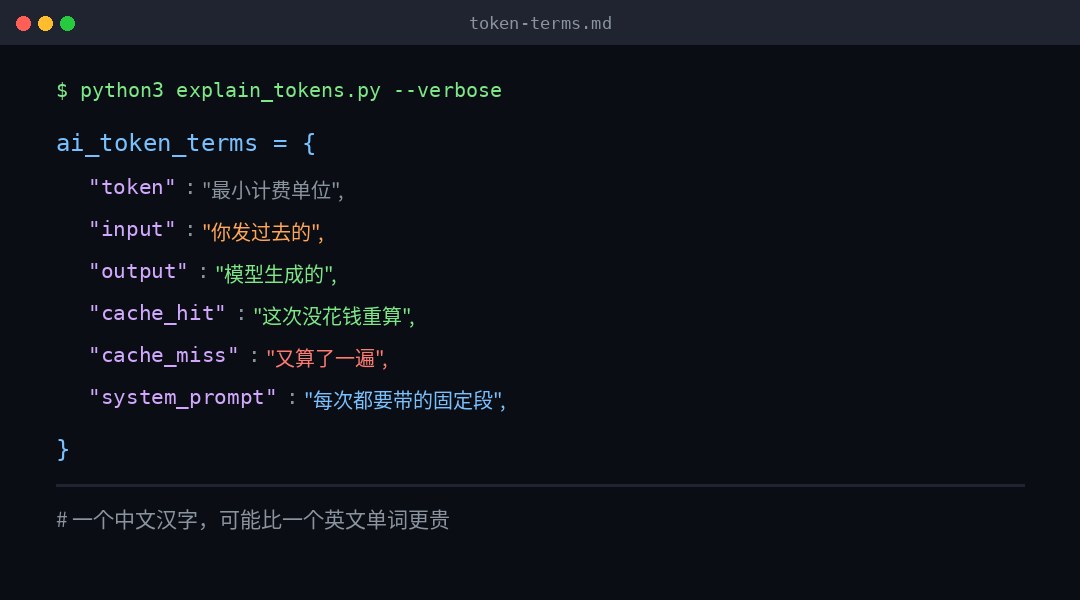
I. Token. Hvorfor er kinesisk dyrere?
Token er den mindste enhed til modeltekstbehandling. Det er ikke et ord. Det er ikke et ord.Det er et stykke skåret af semantikken.Det ved jeg ikke. I samme sætning kan antallet af blokke være forskelligt fra model til kode.
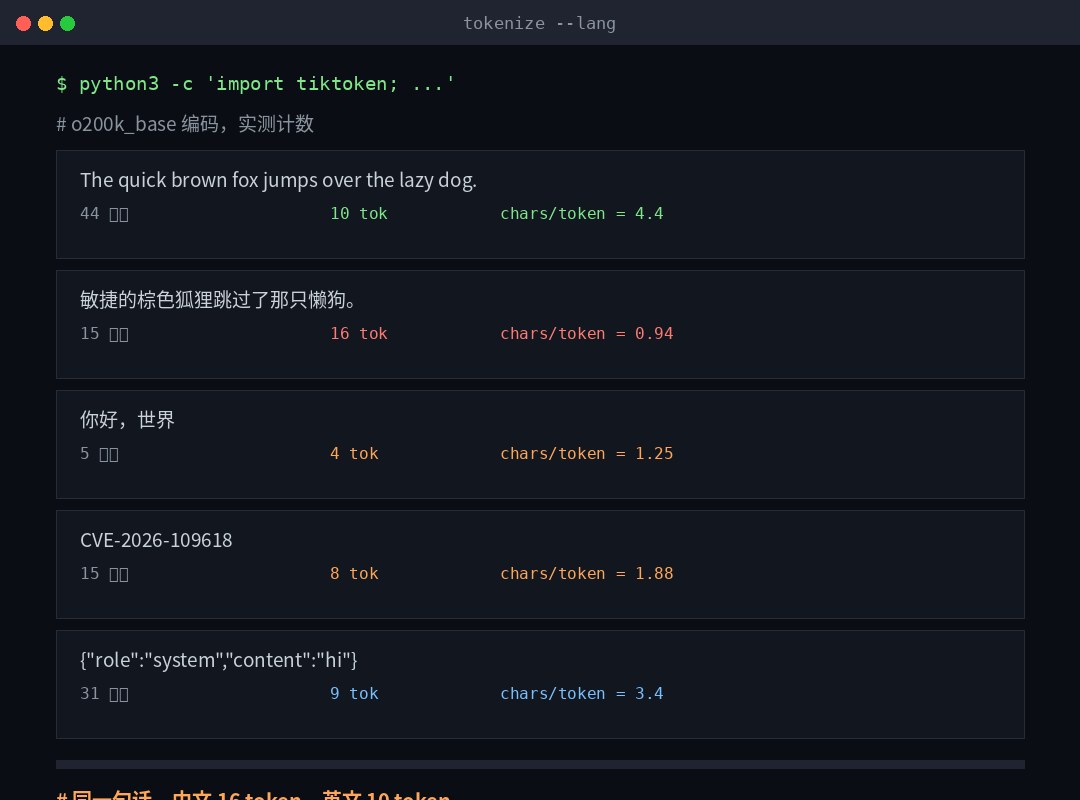
Jeg tager den. o200k_base Koden målte faktisk flere grupper, og forskellen var større end forventet:
| Tekst | Antal tegn | Tokenummer | Tegn / token |
|---|---|---|---|
| Den hurtige brune kasse springer over den dovne hund. | 44 | 10 | 4.4 |
| Den hurtige brune ræv sprang over den dovne hund. | 15 | 16 | 0.94 |
| Hej, verden. | 5 | 4 | 1.25 |
| CVE- 2026- 109618 | 15 | 8 | 1.88 |
Se problemet.I samme sætning, 10 tokens på engelsk og 16 i kinesisk.Om 4 tegn på engelskEt ord, et tegnDet ved jeg ikke.
Dette er meget uvenligt over for kinesiske brugere: "1 token" karakter "er en engelsk-sprog oplevelse.Du undervurderer mere end halvdelen på kinesisk.
Der er en kontraintuitiv:CVE-2026-109618 Dette nummer, 15 tegn brænde 8 tokens. Tal og bindestreger er meget dårlige.Så det er meget dyrere end det ser ud til.
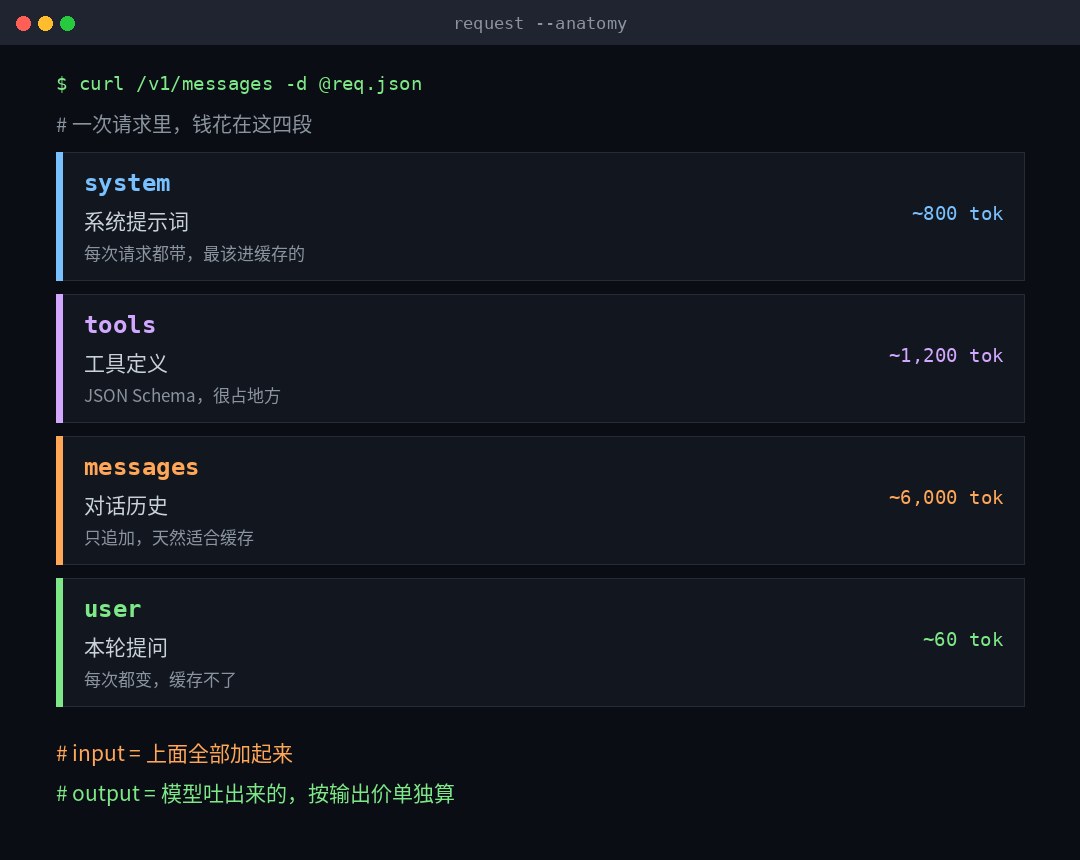
To, en anmodning, fire afsnit.
Første gang jeg så på regningen, var det ikke dyrt.Det er kun et ord, men 8.000 token.Det ved jeg ikke. Så blev det klart, at mere end du gjorde.
Indgangen til en anmodning er normalt foretaget i fire stykker:
| Afsnit | Engelsk navn | Hvad er det? | Vil det ændre sig? |
|---|---|---|---|
| System Hint | System / inddragelse | Hvem er du, reglerne, output format? | Det er stort set det samme. |
| Værktøjs definition | Det tror jeg ikke. | Funktion JSON Schema og beskrivelse | Meget sjældent. |
| Dialogens historie | Meddelelser / historik | Hver runde af spørgsmål og svar foran dig, tage dem alle. | Tilføj kun |
| Spørgsmål til denne runde | Undskyld, sir. | Det, du lige har ringet til. | Hver gang. |
Første gang jeg var bange, var det.Værktøjet definerer mængden af 1.200 tokensDet ved jeg ikke. En funktion med parameter beskrivelse, JSON Schema udvider til at tage særlig plads. Du skrev 20 værktøjer, du kunne spise 2.000 pr. definition.Du skrev ikke et ord, men det er altid opladet.
Der er et centralt punkt bag det:De første tre afsnit er "supplerende og ikke-ændrede", og fjerde afsnit ændres hver gang.Det er ikke tilfældigt. Det afgør, om cachen kan rammes.
Tre: input, output, og at en i output.
Den officielle kaliber af disse tre relationer er som følger:
- Indtast token (input / policy tokens): Alt hvad du sender igennem indeholder de fire afsnit ovenfor.
- Output: Modelleret. Hør efter...Ikke kun teksten, du så.
- Token (gendannelsestokens): Den ræsonnement model er, hvad den mener, før den giver svaret. Du kan ikke se, men det...I produktionspriserDet ved jeg ikke.
Den tredje er den virkelige grund for mange mennesker til at fordoble deres regninger. Jeg har en slags job med en teori model, og jeg ser 20 ord i svaret, og regningen er mere end 900.Det 880 usynlige symbol er derinde.
Så det er normalt at have en modsætning:Jo kortere svar, jo billigere.
Produktionsprisen er normalt ca. 5 gange prisen (se tabellen nedenfor for hver husstand). Dette forklarer et princip om integritet:Det kan løses med input. Luk den ikke ud.Sæt svaret skabelon, formatet eksempel, i systemet hint (lavere), så det ikke organisere sig på en sådan måde, at det er dyrt.
Cacheline og utiltrækkende: Dette er den del af hele teksten, der skal huskes
Hvad er det?
Modeller tælles som mellemliggende, når de læses. Denne del er den dyreste.
Hurtig cache er en forudbestemt tilstand.Næste gang vi møder det samme præfiks, vil vi bruge det direkte og ikke længere genberegne.
Så der var to ord:
- Cache hit: Dette præfiks blev fundet i cachen. Denne del blev indtastet og presset.Rabat.Gebyrer.
- Cache miss- Jeg kan ikke finde den. Regn prisen igen.
Vilkårene er hårdere, end du tror.
Nøglen er ordet "præfiks".Det handler ikke om at spørge om det samme.
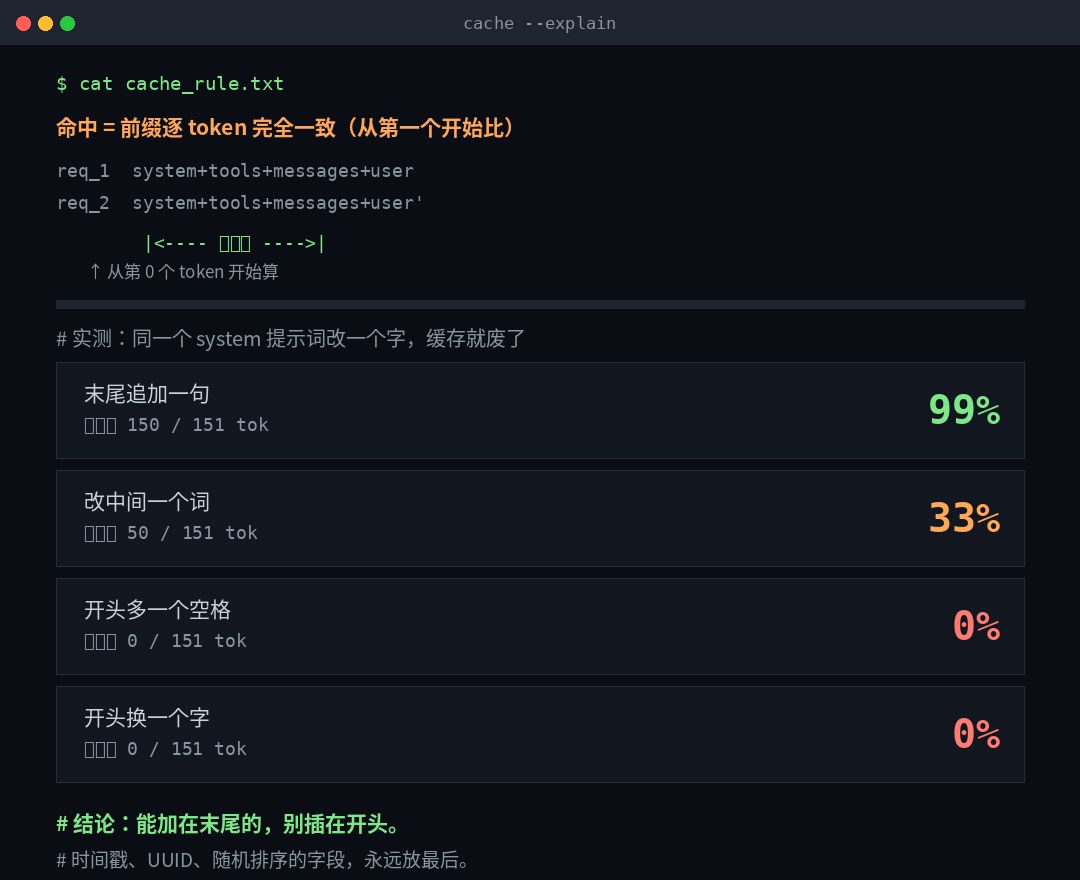
Jeg gjorde et eksperiment: Jeg tog en 151 token system hint, ændrede det til forskellige steder, og kiggede på, hvor meget det kunne genbruges.
| Ændringer | Genanvendeligt præfiks | Procentdel |
|---|---|---|
| Tilføj en sætning til sidst | 150 / 151 | 99% |
| Skift ordet i midten. | 50 / 151 | 33% |
| En plads mere i begyndelsen | 0 / 151 | 0% |
| Begynd med et ord. | 0 / 151 | 0% |
Kan du se det "en plads mere i begyndelsen"?Et rum, cache, kasseret, genberegnet 151 tokens til oprindelige priser.
Det er ikke en fejl, det er princippet: Cache er den tilstand af akkumulering fra begyndelsen, den første token ændringer, og ryggen er alle døde.
Så der er en regel, der kan anvendes med det samme:Det konstante indhold er foran og det variable indhold i sidste.
Den mest almindelige måde at vende er at indsætte den aktuelle tid, anmodet om ID, tilfældigt sorterede felter i begyndelsen af systemet hint. Det er som et nyt cache hver gang.Disse felter er enten flyttet til slutningen eller simpelthen ikke sat i.
Der er et par let-til-forsømmelse tærskler.
- Der er en mindste længde.For kort et præfiks giver slet ikke cachen. OpenAI er GPT- 5.6 og senere 1.024 token; Anthropic er opdelt efter model, både i 512 / 1.024 / 2,048 / 4.096. Hvis det ikke er længe nok, er det ikke forkert.Stille.Man kan kun se ved at returnere kvantefeltet.
- Der er tid til overlevelse.OpenAI standard 30 minutter (op til 12 timer); Anthropic standard 5 minutter, op til 1 time. Og denne gang...Start efter anmodning, ikke tælle fra slutningen af svaret -- hvis svaret løber i fire minutter, 5- minutters slot har kun et minut vindue.
- Vi venter på hinanden.Cache Entry venter på første anmodningBegynd at vende tilbageSå er den ledig. Ti anmodninger blev sendt i samme sekund, og alle 10 blev savnet.
- Ændrede modeller, ændrede værktøjer, ændrede ræsonnementer.Præfikset ændres, og hithastigheden er nul.
Hvad er lejemorderen?
Gæt ikke. Begge familier gav dem et lydfelt:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Anthropic, den specielle intuitive:Begge returnerede 0, så de nåede ikke engang til kassen.- Normalt fordi præfikserne ikke er minimale.
V. Prisstruktur: at skrive flere penge til at læse mindre
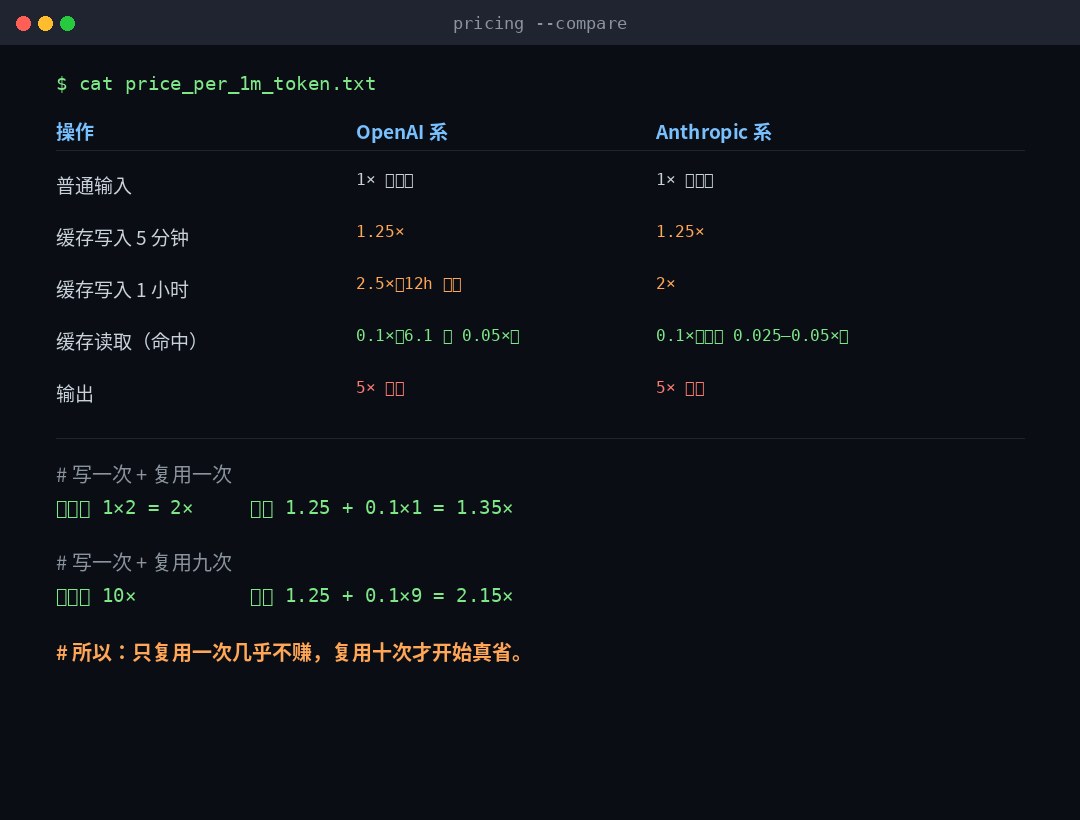
Cache er ikke gratis, og mange har savnet det.Første gang du skriver i cachen, skal du hæve prisen; derefter læse det, før du laver en rabat.
| Operation | OpenAI | Anthropisk |
|---|---|---|
| Normal indgang | 1x (baseline) | 1x (baseline) |
| Cache skriver. Kort slot | 1, 25 x (30 minutter) | 1, 25 x (5 minutter) |
| Cache skriver langsigtet | 2, 5 x (12 timer) | 2x (1 time) |
| Cache Read (Kategori) | 0, 1 x(GPT- 6, 1 er 0, 05 x) | 0, 1 x(Delvis model 0, 025 - 0, 05 x) |
| Output | Omkring 5x | Omkring 5x |
Tag den normale 0,1 x læse, 1,25 x skrive to bøger:
- Skriv én + genbrug én gangCache 1, 25 + 0, 1 = 1, 35 x; ingen cache er 1 + 1 = 2 x.Provins 32%.
- Skriv en gang + gentag ni gange: Cache 1, 25 + 0, 9 = 2, 15 x; ikke cache er 10x.Provins 78%.
Dette betyder:I et tilfælde var cachen knap eller lidt tabt; det var først, når det blev gentaget mere end ti gange, at besparelserne var reelle.De "engangssamtaler" er bare et problem.
Forresten:Cache skrivning er baseret på token segment, ikke af antallet.Breakpoint i sig selv er gratis, og de penge, der bruges, afhænger af, hvor længe du faktisk har.
VI. PUNISEMENTER, SYSTEM PUNISEMENTER, min
De to udtryk bruges ofte sammenblandet, men de er forskellige med hensyn til omkostninger og autoritet.
| Navn | Engelsk | Hvem skrev det? | Prioriteret | Tildeling af gebyrer |
|---|---|---|---|---|
| System Hint | Stamprompt / institutioner | Platformr eller programudvikler | Højeste | Indtast token |
| Udvikler brev | Det ved jeg ikke, om jeg kan. | Anvend udvikler | Lavere (over brugere) | Indtast token |
| Brugerhentydning | Det er vores sag. | Slutbruger | Mindre end de to ovennævnte | Indtast token |
| Assisterende meddelelse | Der er ingen grund til, at du er her. | Modeller genererer sig selv | Det ved jeg ikke. | Output Token |
To nemme punkter:
- Ordet "reklame" er et stort ord.Det henviser generelt til alle de tekstinstruktioner, du sender til modellen, og den "systemale antydning" er den, der er den mest fremadrettede og højeste prioritet. Når det kommer til "reklamer er for lange", det virkelige problem er ofte, at systemet er for lang til at definere dem.
- Rollen er også dyr.Hver besked er et lag
{"role":...,"content":...}Og selve laget tæller som symbolsk. Når der er mange beskeder, vil det være tusindvis af ting.
Så oprydningsdialogen virker -- ikke genialt, ja.Skær den del af historien af.Det ved jeg ikke. Men til gengæld er det vigtigt at bemærke, at de historiske præfikser for den tidligere førte dialog ikke er nødvendige efter opklaringen.
Syv eller syv af de miner, jeg trådte på, kopi af konklusionerne.
- Brug ordet "karakter" til at vurdere det kinesiske budget.Forkert. Kineserne er tæt på et ord, og du vil være dobbelt så kort. Den er klar.
tiktokenDefinerer, eller ser tilbage på brugen. - Jeg troede, jeg ville blive ramt, hvis jeg stillede et lignende spørgsmål.Det kan jeg ikke. Det må være helt konsekvent fra første tegn.
- Indsætter et tidsstempel i begyndelsen af systemvinklen.Dette er den mest almindelige cache morder. Gå til enden.
- Det er billigt at se korte svar.Den ræsonnement model 's tænkning proces koster til output pris, svar 20 ord, afgift 900 token er normalt.
- Cache for engangs dialog.Genbrug kun sparet 32%, men tilføjet et lag af kompleksitet og debugging omkostninger. Det er det værd mindst tre gange.
- Man kan gætte hithastigheden uden at se på et målefelt.To.
cached_tokens/cache_read_input_tokensDe vendte alle tilbage i klar kode. - Han bad også om at bruge cachen til at øge hastigheden.Cachen vil ikke være tilgængelig, før det første svar begynder, og anmodninger om det samme andet er stort set savnet.
VIII. En liste over, hvad der er gjort
Vi kan ændre os i dag.
- Definer systemhints og værktøjerAlt, der ændrer sig.Flyt til slutningen af beskeden.
- VærktøjspresseFast ordreArranger. Ordren ændrer præfikset, præfikset ændrer.
- Første tæller: Skriv antallet af tokens i systemet + værktøj definition. Mere end 2.000 er værd at optimere.
Det er en halv dag værd.
- Afmontere en lang- system vink ind i en "konsistent + variabel segment", med en cache pause i slutningen af den konstante segment.
- Løb rundt med rigtig trafik. Optag.
cached_tokensProcentdel af de samlede input. Mindre end 30% indikerer prefix design problemer. - Tryk også på output side: "kun output" er ikke tilladt at forklare, output prisen er fem gange input.
Gør det ikke.
- Skriv ikke et 90-30 tip til cachen.Cache er penge, ikke klarhed.
- Må ikke tilføje til en-off scripts logikken i caches, som er mere kompliceret end besparelser.
- Det antages ikke, at cache kan anvendes på tværs af forskellige modeller.Skifter modeller ændrer cache, med nul hits.
Endelig.
Disse ord er taget til ende, og de siger kun én ting:Modellen koster "hvor meget det læser i" og "hvor meget det skriver", og cachen er den eneste mekanisme, der kan rabat "læse".
Så det er ikke ligefrem, hvor smukt vinklen er, vel?Læg den bunke ting, der ikke ændrer sig hver gang. Kom så.Det ved jeg ikke.
De fleste af de penge, du ikke kan spare, er ikke for dyre. Dit præfiks ændrer sig hver gang.
Jeg vil efterlade dig med den mest praktiske handling: næste gang jeg ser en unormal regning, ikke tvivl om modellens prisstigning. cached_tokens Den kolonne.Det er ikke nul, beslutte, om du betaler for matematik eller dobbelt.