
Enter, output, cache life: nama pada UU AI token.
Mari kita mulai dengan hasilnya:Hanya ada dua kata dalam istilah ini yang benar-benar biaya Anda lebih: "Cacheft" dan "output" token.Sisanya adalah catatan mereka.
Saya telah ditagih tiga kali dalam dua bulan, dan hal yang sama: saya pikir saya menabung uang, dan saya membayar harga penuh untuk awalan yang sama. Ini adalah satu di mana Anda dapat menjawab setidaknya satu pertanyaan ...Mengapa saya memiliki 8.000 token pada tagihan ketika saya hanya mengatakan satu kata?
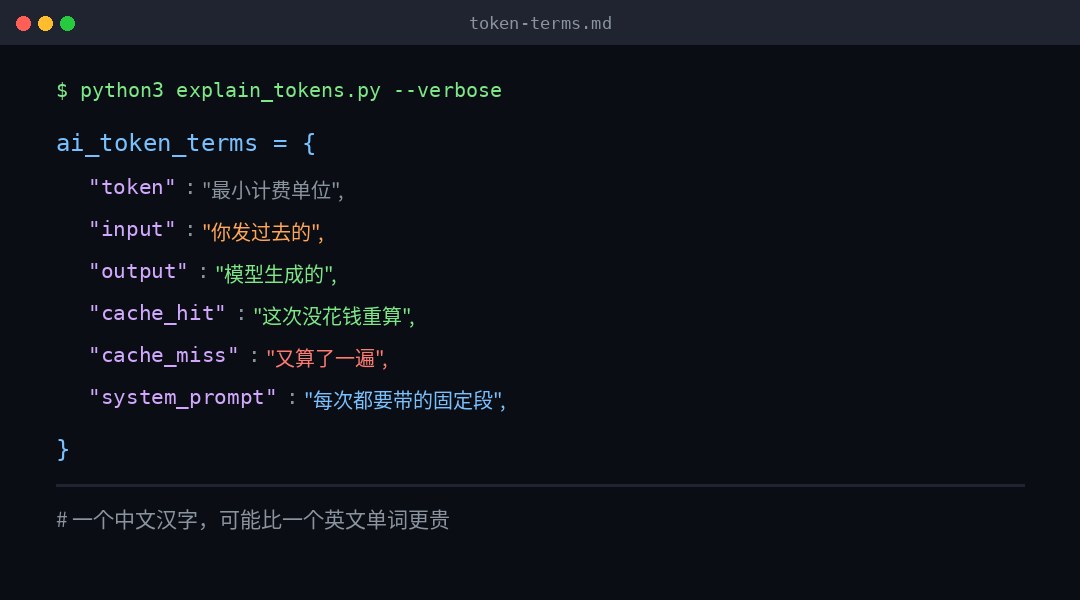
Aku Token. Mengapa Cina lebih mahal?
Token adalah unit terkecil untuk pengolahan teks model. Ini bukan sebuah kata. Ini bukan sebuah kata.Ini potongan semantik.Aku tidak tahu. Dalam kalimat yang sama, jumlah potongan blok dapat berbeda dari model ke kode.
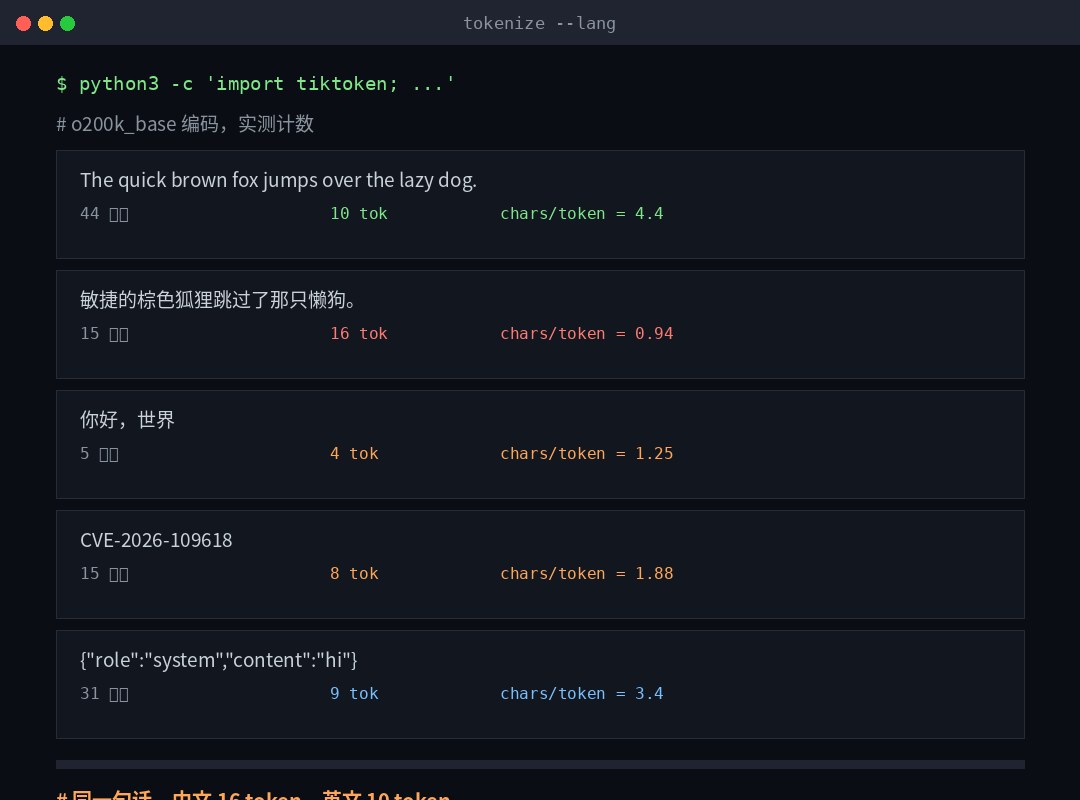
Aku akan mengambilnya. o200k_base Kode itu sebenarnya mengukur beberapa kelompok dan perbedaannya lebih besar dari yang diperkirakan:
| Teks | Bilangan karakter | Nomor Token | Aksara/token |
|---|---|---|---|
| Kekotak cokelat cepat melompati anjing malas. | 44 | 10 | 4.4 |
| Seekor arnab coklat cepat melompati anjing pemalas itu. | 15 | 16 | 0.94 |
| Halo, dunia. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Lihat masalahnya.Dalam kalimat yang sama, 10 token dalam bahasa Inggris dan 16 dalam bahasa Tionghoa.Sekitar 4 karakter dalam bahasa InggrisSatu kata, satu tokenAku tidak tahu.
Ini sangat tidak ramah bagi pengguna Cina: token "1 ≈4 karakter ≈ adalah pengalaman berbahasa Inggris.Anda akan meremehkan lebih dari setengah dari itu dalam bahasa Cina.
Ada yang berlawanan:CVE-2026-109618 Nomor ini, 15 karakter membakar 8 token. Bilangan dan tanda hubung dipotong sangat buruk.Jadi itu jauh lebih mahal dari kelihatannya.
Dua, satu permintaan, empat paragraf.
Pertama kali aku melihat tagihan, itu tidak mahal.Hanya satu kata, tapi 8.000 token.Aku tidak tahu. Kemudian menjadi jelas bahwa lebih dari yang Anda lakukan.
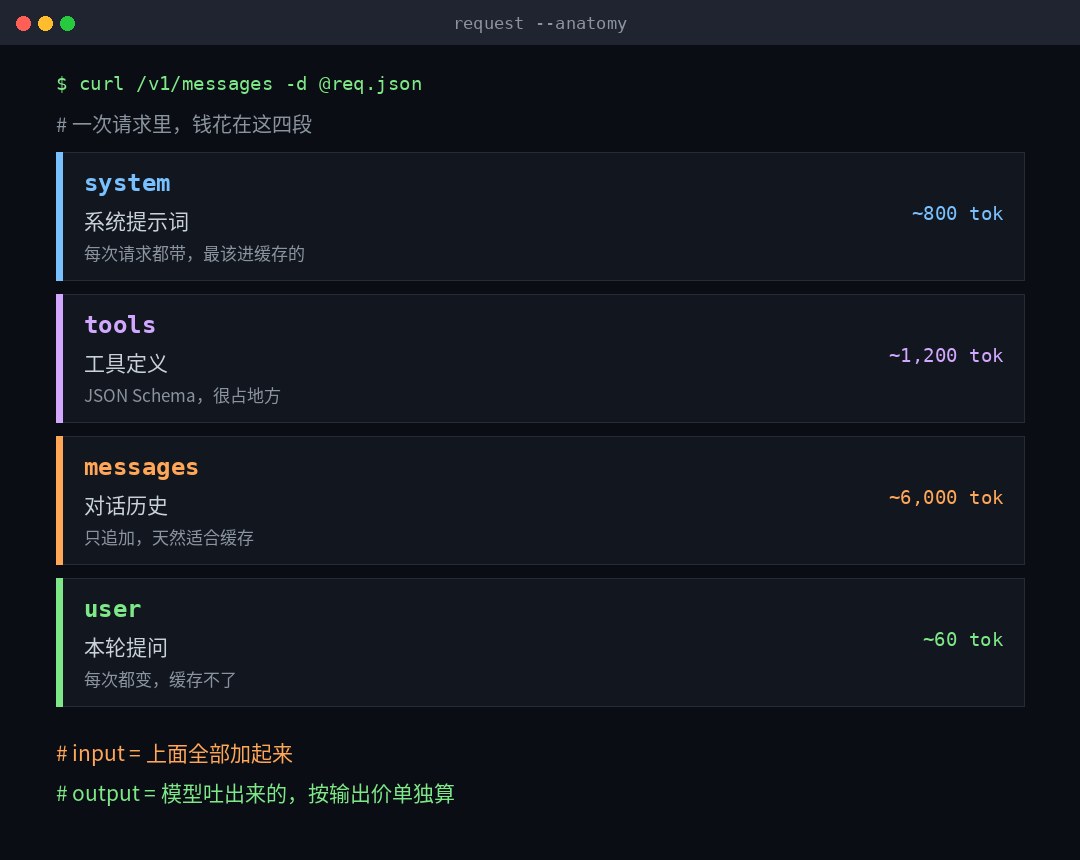
Input dari sebuah permintaan biasanya dibuat dalam empat bagian:
| Perenggan | Nama Inggris | Apa itu? | Apa akan berubah? |
|---|---|---|---|
| Petunjuk Sistem | Sistem / inklusi | Siapa kau, aturan, format output? | Pada dasarnya sama. |
| Takrifan Alat Infinasi | Kurasa tidak. | Fungsi Pustaka JSON Skema dan keterangan | Sangat jarang. |
| Sejarah dialog | Mesej | Setiap putaran pertanyaan dan jawaban sebelum Anda, ambil semuanya. | Hanya menambah |
| Pertanyaan untuk ronde ini | Maafkan aku, Pak. | Hal yang baru saja kau sebut. | Setiap kali. |
Pertama kali aku takut, itu.Alat ini mendefinisikan jumlah 1.200 tokenAku tidak tahu. Fungsi dengan parameter deskripsi, JSON Schema memperluas untuk mengambil tempat khusus. Kau menulis 20 alat, kau bisa makan 2.000 per definisi.Dan kau tidak mengetik kata di bagian ini, tapi selalu dikenakan biaya.
Ada titik kunci di belakangnya:Tiga paragraf pertama adalah \"tambahan dan tidak diubah\" dan perubahan paragraf keempat setiap kali.Ini bukan kebetulan. Ini menentukan apakah cache dapat dipukul.
input, output, dan yang itu di keluaran.
Kaliber resmi dari ketiga hubungan ini adalah sebagai berikut:
- Token masukan (masukan / token kebijakan)Semua yang kau kirim berisi empat paragraf di atas.
- KeluaranModeled. Perhatian...Bukan hanya teks yang kau lihat.
- ♪ Token ♪Model penalaran adalah apa yang dipikirkan sebelum memberikan jawaban. Kau tak bisa melihat, tapi...Pada harga outputAku tidak tahu.
Yang ketiga adalah alasan sebenarnya bagi banyak orang untuk menggandakan tagihan mereka. Saya menjalankan semacam pekerjaan dengan model teori, dan saya melihat 20 kata di jawabannya, dan tagihannya lebih dari 900.Tanda tak terlihat 880 itu, semuanya ada di sana.
Jadi normal untuk memiliki kontradiksi:Semakin pendek jawabannya, semakin murah.
Harga output biasanya sekitar lima kali lipat dari harga input (lihat tabel di bawah untuk setiap rumah tangga). Ini menjelaskan prinsip integritas:Ini dapat diselesaikan dengan input. Jangan biarkan keluar.Ia menempatkan templat jawaban, contoh format, dalam petunjuk sistem (lebih rendah), sehingga tidak menyusun dirinya sedemikian rupa sehingga harganya mahal.
Cacheline dan tidak menarik: ini adalah bagian dari seluruh teks yang harus diingat
Apa itu?
Model-model ari dihitung sebagai perantara ketika mereka dibaca. Bagian ini paling mahal.
Cache pengumpan adalah keadaan awalan.Kali berikutnya kita bertemu awalan yang sama, kita akan menggunakannya secara langsung dan tidak lagi menghitung ulang.
Jadi ada dua kata:
- Cache cache rusakAwalan ini ditemukan di dalam cache. Bagian ini dimasukkan dan ditekan.Diskon.Fees.
- Cache Cache misAku tidak bisa menemukannya. Hanya menghitung ulang harga.
Istilah dari hit lebih sulit dari yang Anda pikirkan.
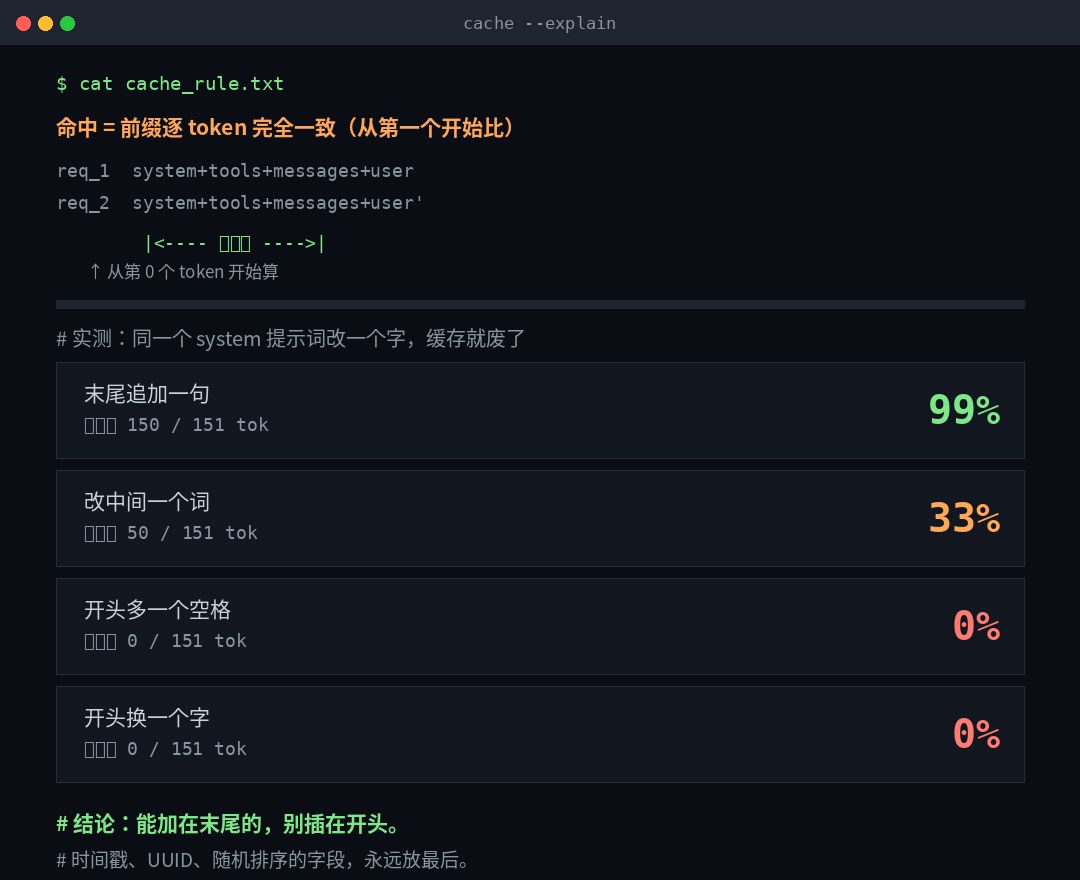
Kuncinya adalah kata "prefix."Ini bukan tentang menanyakan pertanyaan yang sama.
Saya melakukan percobaan: saya mengambil 151 petunjuk sistem token, mengubahnya ke lokasi yang berbeda, dan melihat berapa banyak itu bisa digunakan kembali.
| %d Perubahan | Awalan yang Menyenangkan | Peratus |
|---|---|---|
| Tambahkan kalimat di akhir | 150 / 151 | 99% |
| Perubahan kata di tengah. | 50 / 151 | 33% |
| Satu ruang lagi di awal | 0 / 151 | 0% |
| Mulai dengan kata. | 0 / 151 | 0% |
Lihat bahwa "satu ruang lagi di awal"?Satu ruang, cache, tergores, menghitung kembali 151 token dengan harga asli.
Cache adalah keadaan akumulasi dari awal, perubahan token pertama, dan belakang semuanya mati.
Jadi ada aturan yang bisa segera diterapkan:Konten konstan berada di depan dan konten variabel di terakhir.
Cara paling umum untuk flip adalah dengan menyisipkan waktu saat ini, ID yang diminta, medan yang diurutkan secara acak di awal petunjuk sistem. Itu seperti cache baru setiap waktu.Bidang ini dipindahkan ke ujung atau tidak dimasukkan.
Ada beberapa ambang yang mudah dicerna.
- Ada panjang minimum.Terlalu pendek sebuah prefiks tidak memberikan cache sama sekali. OpenAI adalah GPT-5,6 dan kemudian 1,024 token; Antropik dipisahkan oleh model, baik dalam 512 / 1,024 / 2,048 / 4,096. Jika tidak cukup lama, itu tidak salah.Diam.Kau hanya bisa melihat dengan mengembalikan medan kuantum.
- Ada waktu untuk bertahan hidup.OpenAI default 30 menit (sampai 12 jam); Anthropic default 5 menit, sampai 1 jam. Dan kali ini...Mula pada permintaan, tidak menghitung dari akhir jawabannya -- jika jawabannya berjalan dalam empat menit, slot 5 menit hanya memiliki satu jendela menit.
- Kita akan menunggu satu sama lain.Entri Cache Cache Cache Menunggu Permintaan PertamaMula kembaliMaka itu tersedia. 10 permintaan dikirim pada detik yang sama, dan semua 10 dilewatkan.
- Model-model yang diubah, mengubah alat, mengubah slot penalaran.Awalan perubahan dan laju hit adalah nol.
Apa nilainya?
Jangan menebak. Kedua keluarga itu memberi mereka lapangan volume:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antropik, intuitif khusus:Keduanya mengembalikan 0, yang berarti mereka bahkan tidak mencapai cache.- Biasanya karena prefiks tidak minim.
Struktur harga: menulis lebih banyak uang untuk membaca lebih sedikit
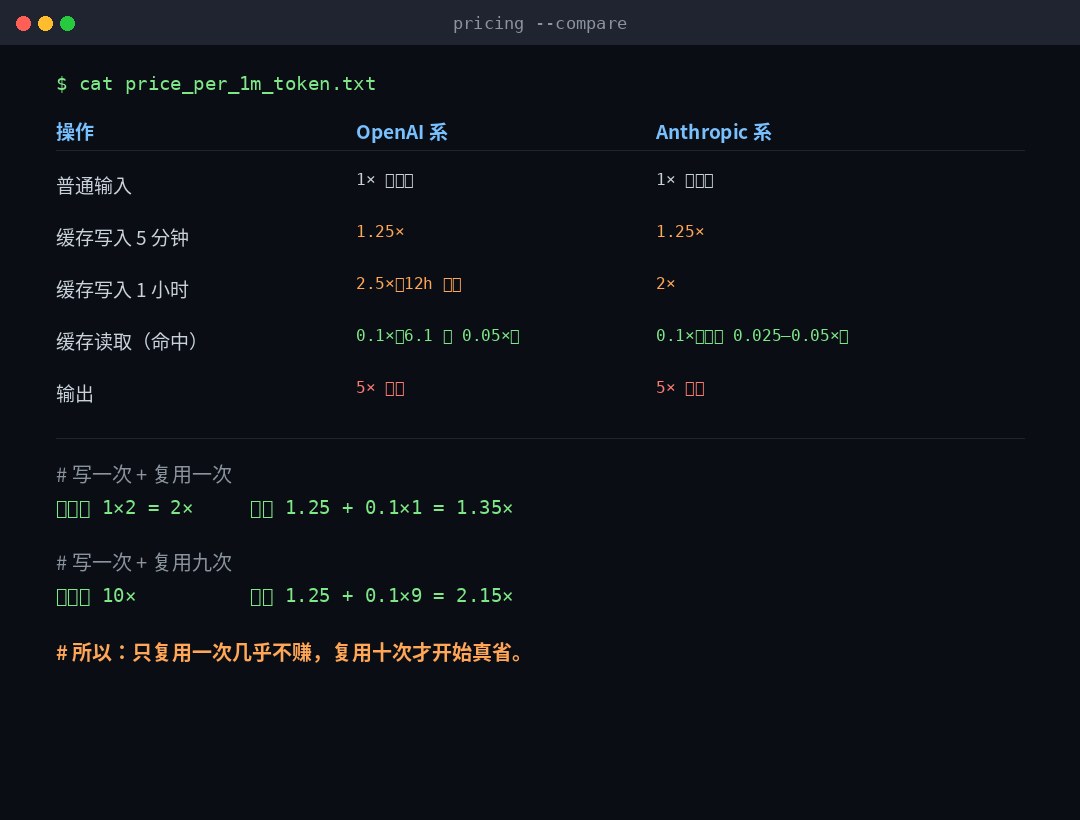
Cache tidak gratis, dan banyak yang melewatkannya.Pertama kali Anda menulis di cache, Anda harus menaikkan harga, kemudian membacanya sebelum Anda membuat diskon.
| Operasi | Buka | Antropik |
|---|---|---|
| Input Normal | 1x (garis dasar) | 1x (garis dasar) |
| Penulisan cache. Slot pendek Could | 25 x 30 menit | 25 x 5 menit |
| Cache cache menulis jangka panjang | 2 2.55 x (12 jam) | 2x (1 jam) |
| Cache Cache Baca (Kategori) | 0.1 x(GPT-6.1 adalah 0,05 x) | 0.1 x***** *** **** ****** ***** ***** ***** ***** **** ***** **** *** *** ** *** ** ** ** ** ** * ** * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * |
| Keluaran | Perihal 5x | Perihal 5x |
Ambil 0.1 x normal, 1,25 x tulis dua buku:
- Write Write sekali + reuse sekaliCache Cache 1.25 + 0.1 = ♪ ♪ ♪ 1,35 x ♪;tidak ada cache adalah 1 + 1 = 2 x.Provinsi 32 persen.
- Tulis sekali + ulangi sembilan kali: Cache 1,25 + 0,9 = 2 2.15 x;bukan cache adalah 10x.Provinsi 78 persen.
Ini berarti:Dalam satu kasus, cache nyaris atau bahkan sedikit hilang; itu hanya ketika itu diulang lebih dari sepuluh kali bahwa tabungan itu nyata.Mereka "satu kali percakapan sementara" hanya masalah.
Ngomong-ngomong:Penulisan cache didasarkan pada segmen token, bukan dengan nomor.Titik breakpoint itu sendiri bebas, dan uang yang dikeluarkan tergantung berapa lama yang Anda miliki.
VI . PENYIAR , SISTEM PENYELAS , min
Dua istilah tersebut sering digunakan berinterpelasi, tetapi berbeda dalam hal biaya dan otoritas.
| Nama | Bahasa Inggris | Siapa yang menulisnya? | (Prioritas) | Atribusi Fee |
|---|---|---|---|---|
| Petunjuk Sistem | Stymprompt / institusi | Performer atau Pengembang Aplikasi | Paling Tinggi | ♪ Enter token ♪ |
| Pembangun Pesan | Aku tak yakin bisa melakukan itu. | Pembangun | Rendahkan (lebih banyak pengguna) | ♪ Enter token ♪ |
| Pembayang pengguna | Ini urusan kita. | Pengguna akhir | Kurang dari dua di atas | ♪ Enter token ♪ |
| Pesan Pembantu | Tak ada alasan kenapa kau di sini. | Model - model yang dihasilkan sendiri | Aku tidak tahu. | Keluaran Token |
Dua poin mudah:
- Kata advertisement" adalah kata besar.Ini mengacu secara umum kepada semua instruksi teks yang Anda kirim ke model, dan "sistemal petunjuk" adalah yang paling maju dan prioritas tertinggi. "advertisements terlalu panjang", masalah sebenarnya sering kali bahwa sistem terlalu panjang untuk mendefinisikannya.
- Peranan suku cadang juga mahal.Setiap pesan adalah satu lapisan
{"role":...,"content":...}Dan lapisan itu sendiri dianggap sebagai token. Ketika ada banyak pesan, itu akan menjadi ribuan hal.
Jadi dialog pembersihan bekerja -- bukan jenius, ya.Potong bagian sejarah itu.Aku tidak tahu. Namun pada gilirannya, penting untuk diperhatikan bahwa setelah kliring, awalan sejarah dari dialog yang sebelumnya diadakan tidak akan diperlukan.
Tujuh atau tujuh pits saya menginjak, menyalin kesimpulan.
- "character untuk memperkirakan anggaran belanja Cina.Salah. Cina dekat dengan satu kata, dan Anda akan dua kali lebih pendek. Sudah siap.
tiktokenPenentangan, atau melihat kembali pada penggunaan. - Saya pikir saya akan mendapatkan hit jika saya mengajukan pertanyaan yang sama.Tidak bisa. Harus benar-benar konsisten dari token pertama.
- Dia memasukkan cap waktu di awal petunjuk sistem.Ini adalah pembunuh cache yang paling umum. Pindah ke akhir.
- Ini murah untuk melihat jawaban singkat.Cara berpikir model penalaran yang dihasilkan dari harga output, jawaban 20 kata, biaya 900 token adalah normal.
- Cache untuk satu kali dialog.Re-use hanya disimpan 32 persen, tetapi menambahkan lapisan kompleksitas dan biaya debugging. Ini layak setidaknya tiga kali.
- Anda dapat menebak tingkat hit tanpa melihat pada bidang pengukuran.Dua.
cached_tokens/cache_read_input_tokensMereka semua kembali dalam kode yang jelas. - Dia juga meminta untuk menggunakan cache untuk meningkatkan kecepatan.Cache tidak akan tersedia sampai respon pertama dimulai, dan permintaan untuk kedua yang sama sebagian besar hilang.
VIII. Daftar apa yang telah dilakukan
Kita bisa berubah hari ini.
- Takrifkan petunjuk dan alat sistemSemua yang berubah.Pindah ke akhir pesan.
- Alat TekanKetertiban TetapArrange. Urutan-urutan tersebut mengubah awalan, perubahan awalan.
- Hitungan pertama: Ketikkan jumlah token dalam sistem + definisi alat. Lebih dari 2.000 layak dioptimasi.
Ini bernilai setengah hari.
- , dengan jeda cache di akhir segmen konstan.
- Jalan bulat dengan lalu lintas nyata. Catatan.
cached_tokensPeratusan total masukan. Kurang dari 30% menunjukkan masalah desain awalan. - Pers sisi output juga: "output hanya " tidak diizinkan untuk menjelaskan, harga output adalah lima kali input.
Jangan lakukan itu.
- Jangan menulis sembilan-tiga puluh tip untuk cache.Cache adalah uang, bukan kejelasan.
- Jangan menambahkan satu-off skrip logika cache, yang lebih rumit daripada tabungan.
- Tidak diasumsikan bahwa cache dapat digunakan di seluruh model yang berbeda.Model switching adalah mengubah cache, dengan nol hits.
Akhirnya.
Kata-kata ini diambil sampai akhir, dan mereka mengatakan hanya satu hal:Tuduhan model itu "berapa banyak itu dibaca dalam" dan " berapa banyak itu menulis," dan cache adalah satu-satunya mekanisme yang dapat diskon "baca."
Jadi itu tidak seberapa indah petunjuknya, bukan?Ada banyak hal yang tak berubah setiap saat. Ayo pergi.Aku tidak tahu.
Sebagian besar uang yang tidak bisa kau simpan tidak terlalu mahal. Awalanmu berubah setiap saat.
Saya akan meninggalkan Anda dengan tindakan yang paling praktis: lain kali saya melihat tagihan abnormal, jangan ragu harga model meningkat. cached_tokens Kolom itu.Ini bukan nol, memutuskan apakah Anda membayar untuk matematika atau ganda.