
Introduzca, salida, vida de caché: el nombre en la factura de fichas de AI.
Empecemos con los resultados:Sólo hay dos palabras en estos términos que realmente le cuestan más: "Cacheft" y "output" token.El resto son sus notas.
He sido facturado tres veces en dos meses, y es lo mismo: creo que estoy ahorrando dinero, y estoy pagando el precio completo por el mismo prefijo. Este es el que puede responder al menos una pregunta...¿Por qué tengo 8.000 fichas en la cuenta cuando sólo he dicho una palabra?
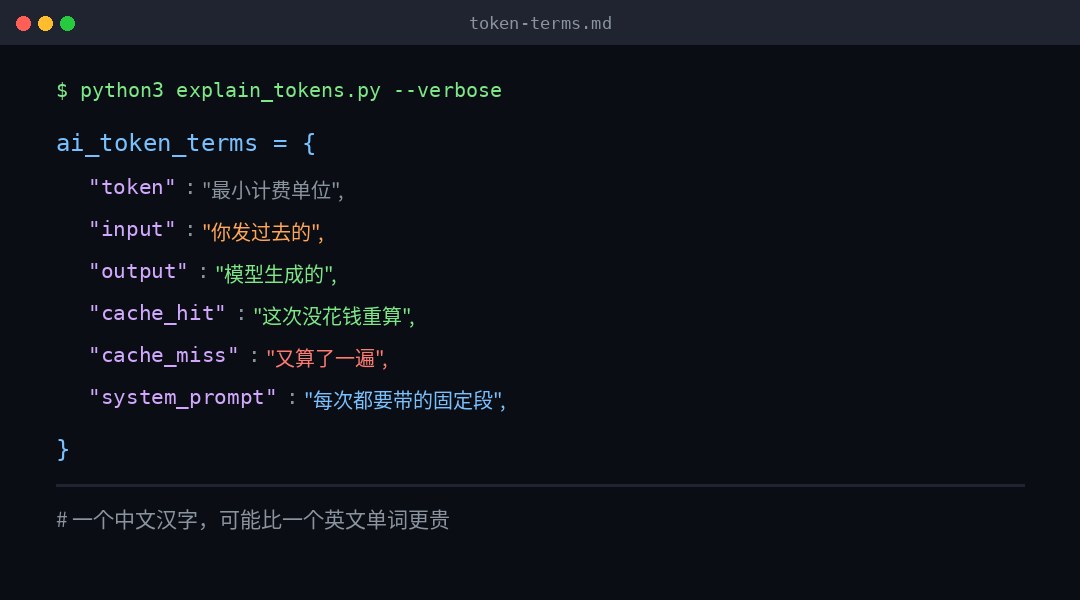
I. Token. ¿Por qué el chino es más caro?
Token es la unidad más pequeña para el procesamiento de texto modelo. No es una palabra. No es una palabra.Es una pieza cortada por el semántico.No lo sé. En la misma frase, el número de bloques cortados puede variar de modelo a código.
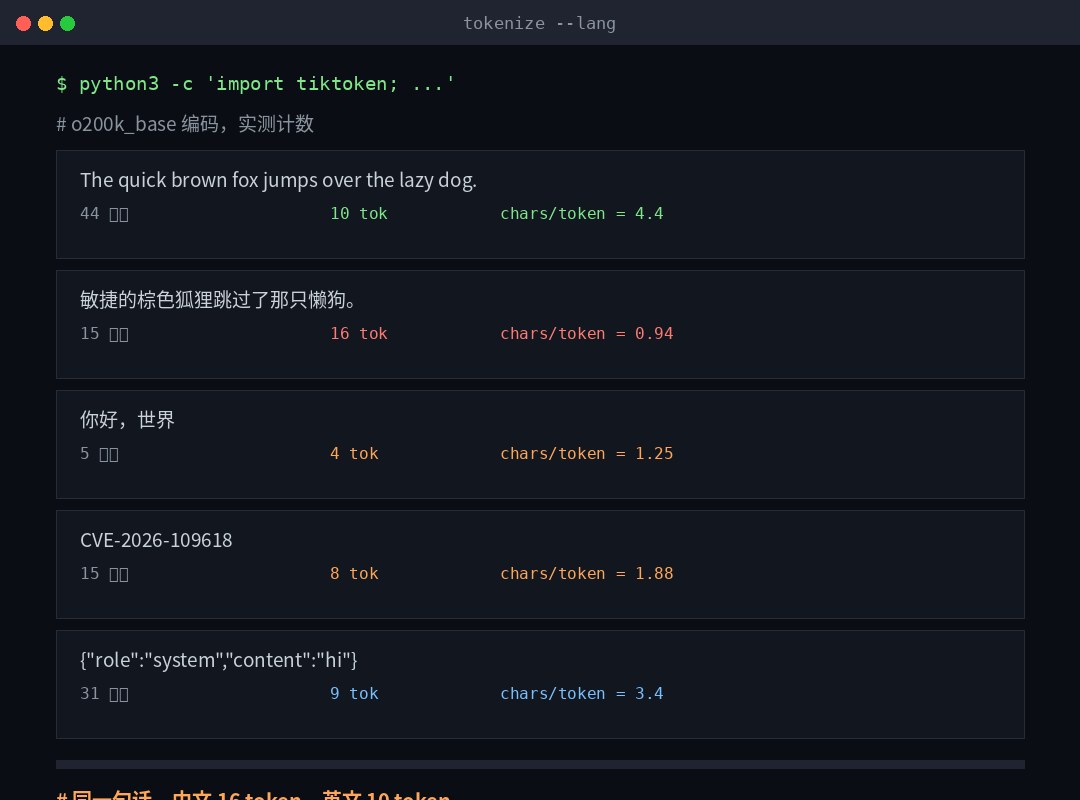
Lo tomaré. o200k_base El código de hecho midió varios grupos y la diferencia fue mayor de lo esperado:
| Texto | Número de caracteres | Número de fichas | Carácter/token |
|---|---|---|---|
| La caja marrón rápida salta sobre el perrito perezoso. | 44 | 10 | 4.4 |
| El zorro marrón rápido saltó sobre ese perro perezoso. | 15 | 16 | 0.94 |
| Hola, mundo. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Mira el problema.En la misma frase, 10 fichas en inglés y 16 en chino.Sobre 4 caracteres en inglésUna palabra, una señalNo lo sé.
Esto es muy poco agradable para los usuarios chinos: el "1 token Ω4 carácter" es una experiencia en inglés.Subestimarás más de la mitad en chino.
Hay una contraintuitiva:CVE-2026-109618 Este número, 15 caracteres queman 8 fichas. Los números y las hipnosis se cortan muy mal.Así que es mucho más caro de lo que parece.
Dos, una petición, cuatro párrafos.
La primera vez que miré la cuenta, no fue caro.Es sólo una palabra, pero 8.000 token.No lo sé. Entonces quedó claro que más de lo que hiciste.
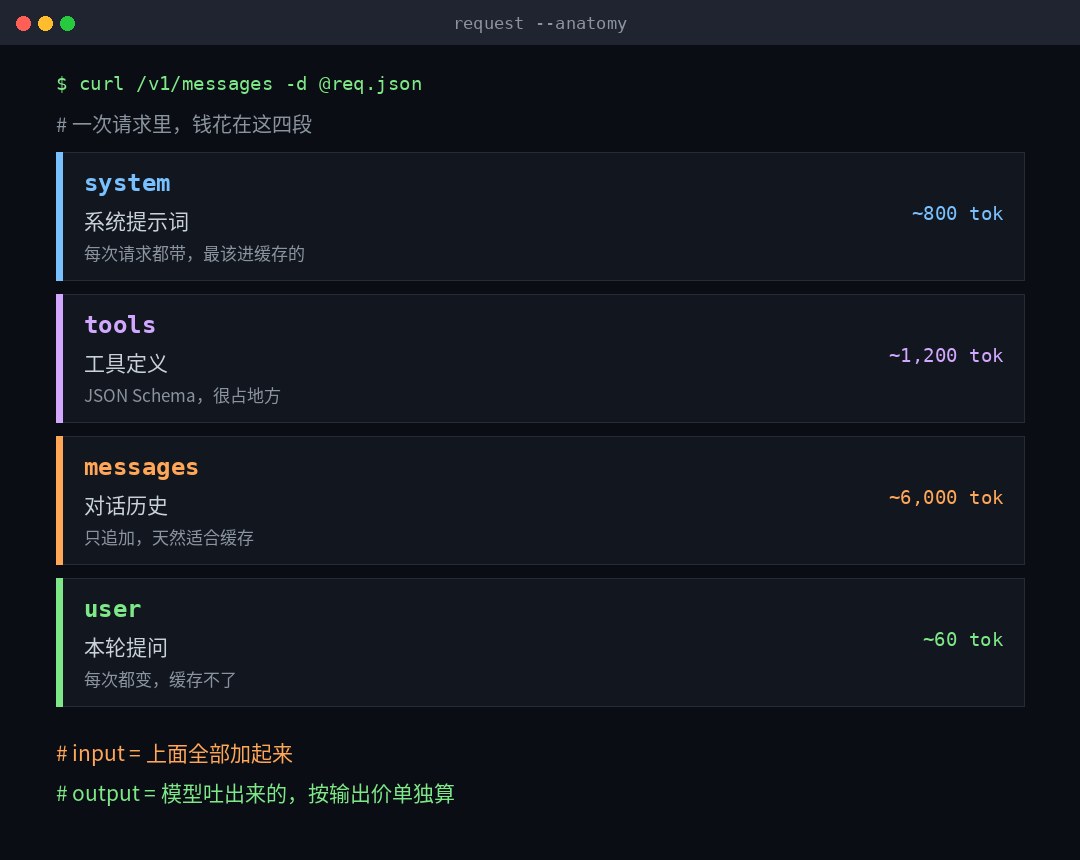
La entrada de una solicitud se hace generalmente en cuatro piezas:
| Párrafo | Nombre del inglés | ¿Qué pasa? | ¿Cambiará? |
|---|---|---|---|
| System Hint | Sistema / inclusión | ¿Quién es usted, las reglas, el formato de salida? | Es básicamente lo mismo. |
| Definición | No lo creo. | Función JSON Schema y descripción | Muy rara vez. |
| Historia del diálogo | Mensajes / historia | Cada ronda de preguntas y respuestas ante ustedes, tomen todas. | Añadir sólo |
| Preguntas para esta ronda | Lo siento, señor. | Esa cosa que acabas de llamar. | Cada vez. |
La primera vez que tuve miedo, lo fue.La herramienta define la cantidad de 1.200 fichasNo lo sé. Una función con descripción del parámetro, JSON Schema se expande para ocupar un lugar especial. Escribiste 20 herramientas, podrías comer 2.000 por definición.Y no escribiste una palabra en esta parte, pero siempre está cargada.
Hay un punto clave detrás de él:Los tres primeros párrafos son “adicionales y no modificados” y el cuarto párrafo cambia cada vez.No es una coincidencia. Determina si el caché puede ser golpeado.
Tres: entrada, salida y esa en la salida.
El calibre oficial de estas tres relaciones es el siguiente:
- Ingrese a la ficha (introducción / fichas de política): Todo lo que envía contiene los cuatro párrafos anteriores.
- Producto: Modelado. Atención...No sólo el texto que viste.
- Token (resonando fichas): El modelo de razonamiento es lo que piensa antes de dar la respuesta. No puedes ver, pero...A precios de salidaNo lo sé.
La tercera es la verdadera razón para que muchas personas doblen sus cuentas. Dirijo una especie de trabajo con un modelo de teoría, y veo 20 palabras en la respuesta, y la cuenta es más de 900.Ese token invisible de 880, está todo ahí.
Así que es normal tener una contradicción:Cuanto más corto sea la respuesta, más barato menos.
El precio de salida es generalmente alrededor de cinco veces el precio de entrada (ver la tabla abajo para cada hogar). Esto explica un principio de integridad:Se puede resolver con entrada. No lo dejes salir.Ponga la plantilla de respuesta, el ejemplo de formato, en la indirecta del sistema (más baja), para que no se organice de tal manera que sea caro.
Cacheline y poco atractivo: esta es la sección de todo el texto que debe ser recordado
¿Qué son?
Los modelos se cuentan como intermedios cuando se leen. Esta parte es la más cara.
Es un estado prefijado.La próxima vez que nos encontremos con el mismo prefijo, lo usaremos directamente y ya no volveremos a calcular.
Así que hubo dos palabras:
- Cache hitEste prefijo fue encontrado en el caché. Esta parte fue ingresada y presionada.El descuento.Fees.
- Cache miss- No puedo encontrarlo. Recalcula el precio.
Los términos del golpe son más difíciles de lo que crees.
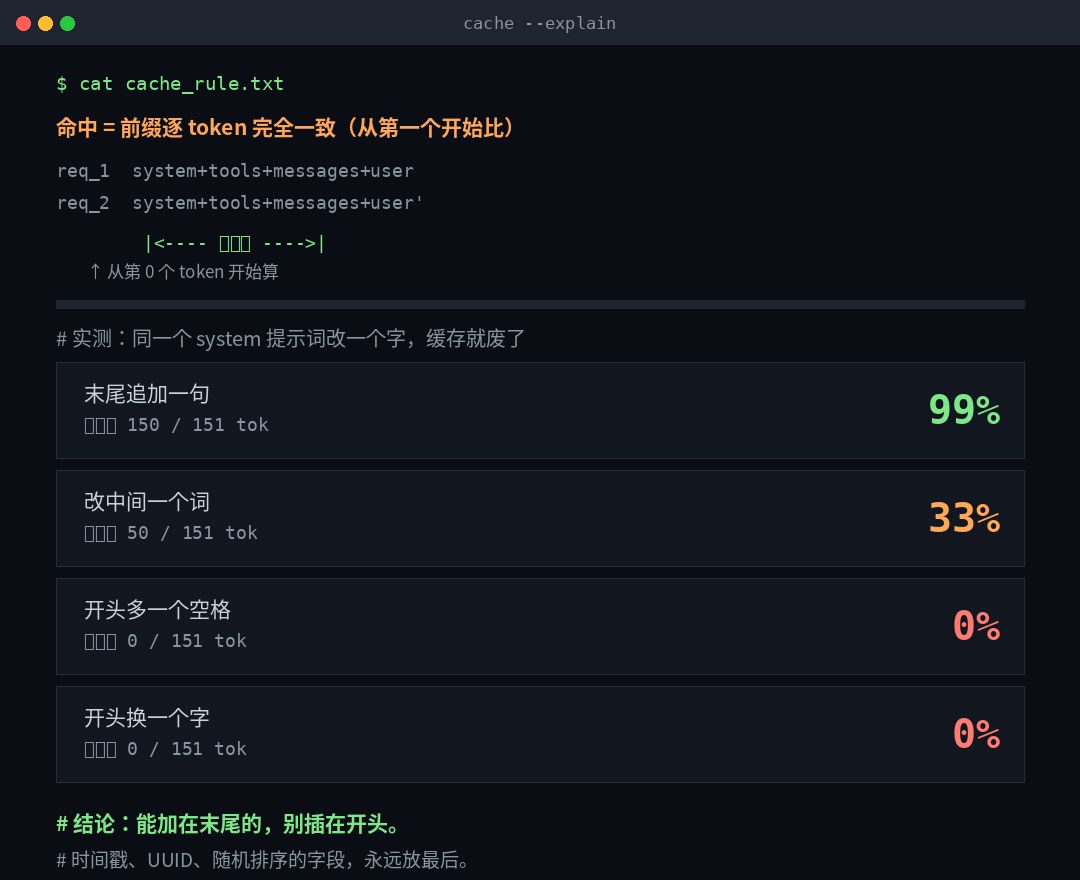
La clave es la palabra "prefijo".No se trata de hacer la misma pregunta.
Hice un experimento: tomé una pista de 151 token del sistema, la cambié a diferentes lugares, y miré cuánto podría ser reutilizado.
| Cambios | Prefijo reutilizable | Porcentaje |
|---|---|---|
| Agregar una frase al final | 150 / 151 | 99% |
| Cambia la palabra en el medio. | 50 / 151 | 33% |
| Un espacio más al principio | 0 / 151 | 0% |
| Empieza con una palabra. | 0 / 151 | 0% |
¿Ves ese "un espacio más al principio"?Un espacio, caches, raspado, recalculado 151 fichas a precios originales.
No es un error, es el principio: Cache es el estado de acumulación desde el principio, los primeros cambios token, y la espalda está muerta.
Así que hay una regla que se puede aplicar inmediatamente:El contenido constante está en el frente y el contenido variable en el último.
La forma más común de voltear es insertar el tiempo actual, el ID solicitado, los campos ordenados al azar al principio de la pista del sistema. Es como un nuevo caché cada vez.Estos campos se mueven al final o simplemente no se ponen.
Hay un par de umbrales fáciles de desviar.
- Hay una longitud mínima.Demasiado corto un prefijo no da el caché en absoluto. OpenAI es GPT-5.6 y más tarde 1.024 token; Antrópico se segrega por modelo, ambos en 512 / 1.024 / 2.048 / 4.096. Si no es lo suficientemente largo, no está mal.Silencio., sólo se puede ver devolviendo el campo cuántico.
- Hay tiempo para sobrevivir.OpenAI predeterminado 30 minutos (hasta 12 horas); Antrópico predeterminado 5 minutos, hasta 1 hora. Y esta vez...Inicio a petición, sin contar desde el final de la respuesta - si la respuesta funciona en cuatro minutos, la ranura de 5 minutos tiene sólo una ventana de minuto.
- Nos esperamos.Cache Entry espera la primera solicitudEmpieza a regresar.Entonces está disponible. Diez solicitudes fueron enviadas en el mismo segundo, y las 10 fueron perdidas.
- Modificar modelos, cambiar herramientas, cambiar las ranuras de razonamiento.El prefijo cambia y la tasa de éxito es cero.
¿Cuál es la tasa de éxito?
No lo supongas. Ambas familias les dieron un campo de volumen:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antrópico, el especial intuitivo:Ambos regresaron 0, lo que significa que ni siquiera llegaron al caché.- Normalmente porque los prefijos no son mínimos.
V. Estructura de precios: escribir más dinero para leer menos
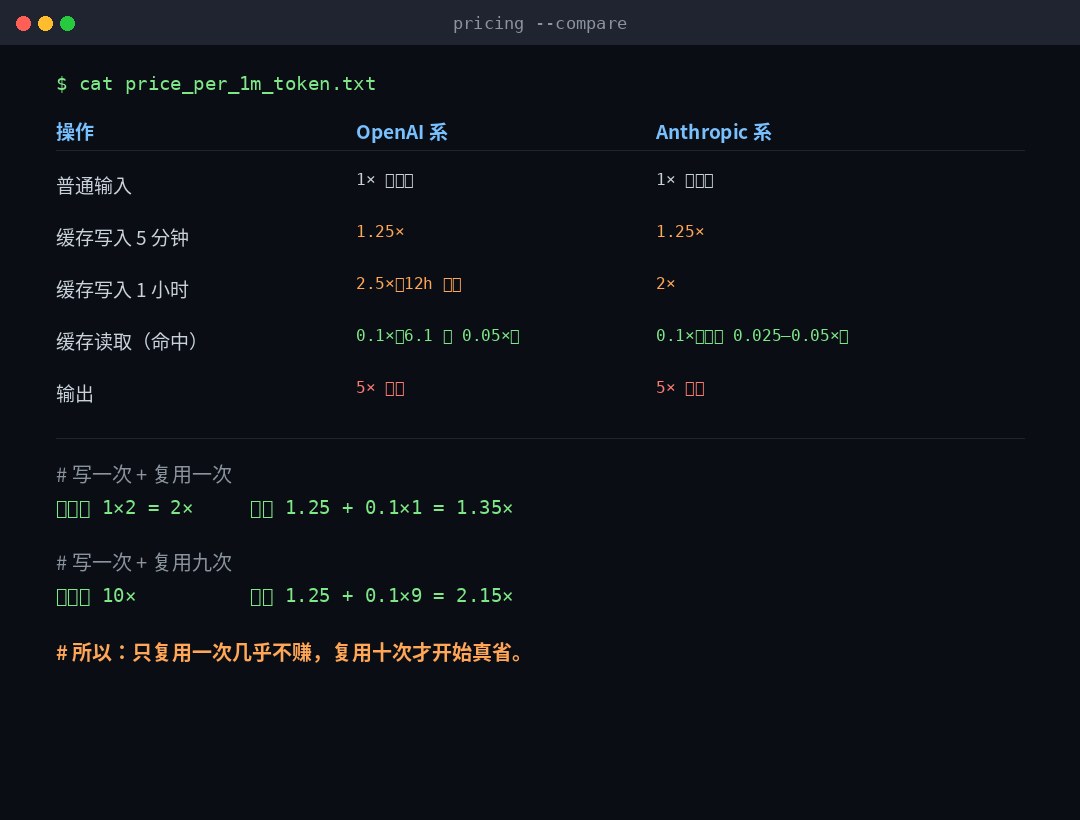
Cache no es libre, y muchos lo han perdido.La primera vez que escribes en el caché, tienes que subir el precio; luego leerlo antes de hacer un descuento.
| Operación | OpenAI | Antrópico |
|---|---|---|
| Entrada normal | 1x (baseline) | 1x (baseline) |
| Caché escribiendo. Rango corto | 1,25 x (30 minutos) | 1,25 x (5 minutos) |
| Cache writing long-term | 2,5 x (12 horas) | 2x (1 hora) |
| Cache Read (Categoría) | 0.1 x(GPT-6.1 es 0,05 x) | 0.1 x(Modelo parcial 0,025 – 0,05 x) |
| Producto | Acerca de 5x | Acerca de 5x |
Tome el 0.1 x leer normal, 1.25 x escribir dos libros:
- Escribe una vez + reutiliza una vezCache 1.25 + 0.1 = 1.35 x; ninguna caché es 1 + 1 = 2 x.Provincia 32%.
- Escribe una vez + repite nueve veces: Cache 1.25 + 0.9 = 2.15 x; no cache es 10x.Provincia 78%.
Esto significa:En un caso, el cache estaba apenas o incluso ligeramente perdido; sólo cuando se repitió más de diez veces que los ahorros eran reales.Esas "conversaciones temporales de una sola vez" son sólo un problema.
Por cierto:La escritura de caché se basa en el segmento token, no por el número.El punto de ruptura es libre, y el dinero gastado depende de cuánto tiempo tengas.
VI. PUNISHMENTS, SYSTEM PUNISHMENTS, min
Los dos términos se utilizan a menudo entremezclados, pero son diferentes en términos de costo y autoridad.
| Nombre | Inglés | ¿Quién lo escribió? | Prioridad | Tasa de atribución |
|---|---|---|---|---|
| System Hint | Stymprompt / instituciones | Desarrollador de plataformas o aplicaciones | Más alto | Introducir token |
| Mensaje de desarrollo | No estoy seguro de poder hacerlo. | Apply Developer | Menor (más usuarios) | Introducir token |
| Nota de usuario | Es asunto nuestro. | Usuario final | Menos de los dos anteriores | Introducir token |
| Assistant | No hay razón para que estés aquí. | Los modelos se generan | No lo sé. | Producto Token |
Dos puntos fáciles:
- La palabra "advertencia" es una gran palabra.Se refiere en general a todas las instrucciones de texto que envía al modelo, y la "insinuación sistemática" es la que es la prioridad más avanzada y más alta. Cuando se trata de "los anuncios son demasiado largos", el problema real es a menudo que el sistema es demasiado largo para definirlos.
- El papel también es caro.Cada mensaje es una capa
{"role":...,"content":...}Y la capa misma cuenta como señal. Cuando haya muchos mensajes, serán miles de cosas.
Así que el diálogo de limpieza está funcionando... no es un genio, sí.Corta esa parte de la historia.No lo sé. Pero a su vez, es importante señalar que después de aclarar, no se necesitarán los prefijos históricos del diálogo previamente sostenido.
Siete o siete de los hoyos que pisé, copian las conclusiones.
- Utilice la palabra "caracter" para estimar el presupuesto chino.Incorrecto. Chino está cerca de una palabra, y serás el doble de corto. Está listo.
tiktokenDefinir o mirar hacia atrás el uso. - Pensé que me golpearían si hiciera una pregunta similar.No puedo. Debe ser completamente consistente desde el primer token.
- Inserta un sello de tiempo al comienzo de la pista del sistema.Este es el asesino de caché más común. Muévete al final.
- Es barato ver respuestas cortas.El proceso de pensamiento del modelo de razonamiento se calcula a precio de salida, respuesta 20 palabras, carga 900 token es normal.
- Busca un diálogo único.La reutilización sólo salvó el 32%, pero añadió una capa de complejidad y costos de depuración. Vale la pena al menos tres veces.
- Puedes adivinar la tasa de éxito sin mirar un campo de medición.Dos.
cached_tokens/cache_read_input_tokensTodos regresaron en código claro. - También pidió usar el caché para aumentar la velocidad.El caché no estará disponible hasta que comience la primera respuesta, y las solicitudes para el mismo segundo se pierden en gran medida.
VIII. Una lista de lo que se ha hecho
Podemos cambiar hoy.
- Define las pistas y herramientas del sistemaTodo lo que cambia.Muévete al final del mensaje.
- Herramientas de prensaOrden fijaArreglense. El pedido cambia el prefijo, el prefijo cambia.
- Primer recuento: Introduzca el número de fichas en el sistema + definición de herramienta. Más de 2.000 vale la pena optimizar.
Vale la pena medio día.
- Disassembly un indicio de largo sistema en un segmento "consistente + variable", con una rotura de caché al final del segmento constante.
- Corre con tráfico real. Grabar.
cached_tokensPorcentaje del total de insumos. Menos del 30% indica problemas de diseño prefijo. - Presione también el lado de salida: el "sólo salida" no se permite explicar, el precio de salida es cinco veces la entrada.
No lo hagas.
- No escribas un consejo de nueve mil para el caché.Cache es dinero, no claridad.
- No añadas a scripts one-off la lógica de caches, que son más complicados que los ahorros.
- No se supone que los caches puedan ser utilizados en diferentes modelos.Los modelos de cambio están cambiando caches, con cero golpes.
Por fin.
Estas palabras se toman al final, y dicen sólo una cosa:El modelo carga "cuánto lee" y "cuánto escribe", y el caché es el único mecanismo que puede descartar "leer".
Así que no es exactamente lo hermosa que es la pista, ¿verdad?Pon esa pila de cosas que no cambian cada vez. Vamos.No lo sé.
La mayoría del dinero que no puedes ahorrar no es demasiado caro. Tu prefijo cambia cada vez.
Te dejaré con la acción más práctica: la próxima vez que vea una factura anormal, no dudes del aumento del precio del modelo. cached_tokens Esa columna.No es cero, decide si pagas matemáticas o dobles.