
Voer, uitvoer, cache leven: de naam op de AI token factuur.
Laten we beginnen met de resultaten:Er zijn slechts twee woorden in deze termen die je echt meer kosten: "Cacheft" en "output" token.De rest zijn hun aantekeningen.
Ik ben drie keer in twee maanden in rekening gebracht, en het is hetzelfde: ik denk dat ik geld spaar, en ik betaal de volledige prijs voor hetzelfde voorvoegsel. Hier kun je tenminste één vraag beantwoorden...Waarom heb ik 8.000 tokens op de rekening als ik maar één woord heb gezegd?
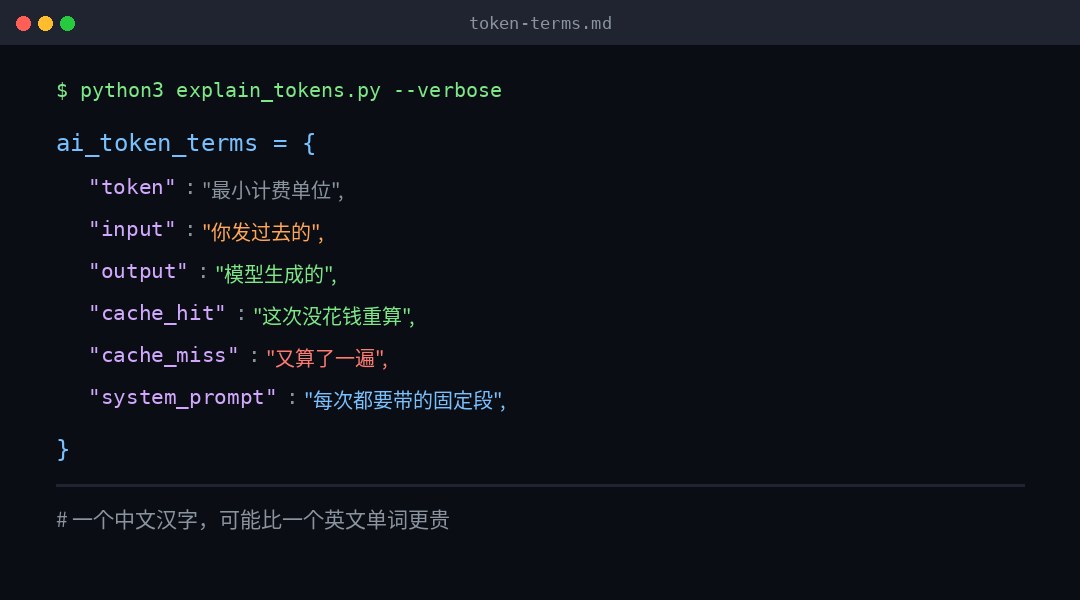
Ik. Token. Waarom is Chinees duurder?
Token is de kleinste eenheid voor modeltekstverwerking. Het is geen woord. Het is geen woord.Het is een stuk doorgesneden door de semantiek.Ik weet het niet. In dezelfde zin kan het aantal blokken van model tot code verschillen.
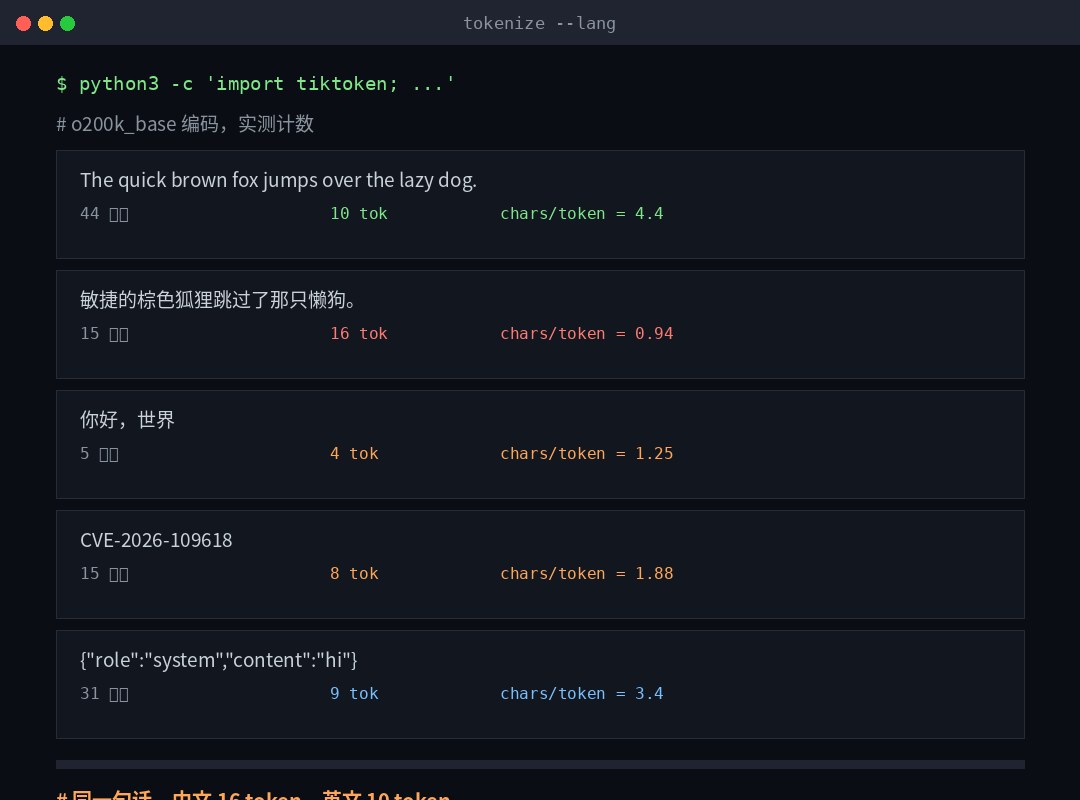
Ik neem het. o200k_base De code heeft verschillende groepen gemeten en het verschil was groter dan verwacht:
| Tekst | Aantal tekens | Tokennummer | Teken/teken |
|---|---|---|---|
| De snelle bruine doos springt over de luie hond. | 44 | 10 | 4.4 |
| De snelle bruine vos sprong over die luie hond. | 15 | 16 | 0.94 |
| Hallo, wereld. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Zie het probleem.In dezelfde zin, 10 penningen in het Engels en 16 in het Chinees.Ongeveer 4 karakters in het EngelsEén woord, één teken.Ik weet het niet.
Dit is zeer onvriendelijk voor Chinese gebruikers: de "1 token ≈4 karakter" is een Engelstalige ervaring.Je onderschat meer dan de helft in het Chinees.
Er is een tegenintuïtief:CVE-2026-109618 Dit nummer, 15 karakters branden 8 tokens. Nummers en koppeltekens zijn erg slecht gesneden.Dus het is veel duurder dan het lijkt.
Twee, één verzoek, vier paragrafen.
De eerste keer dat ik naar de rekening keek, was het niet duur.Het is maar één woord, maar 8.000 token.Ik weet het niet. Toen werd het duidelijk dat meer dan jij.
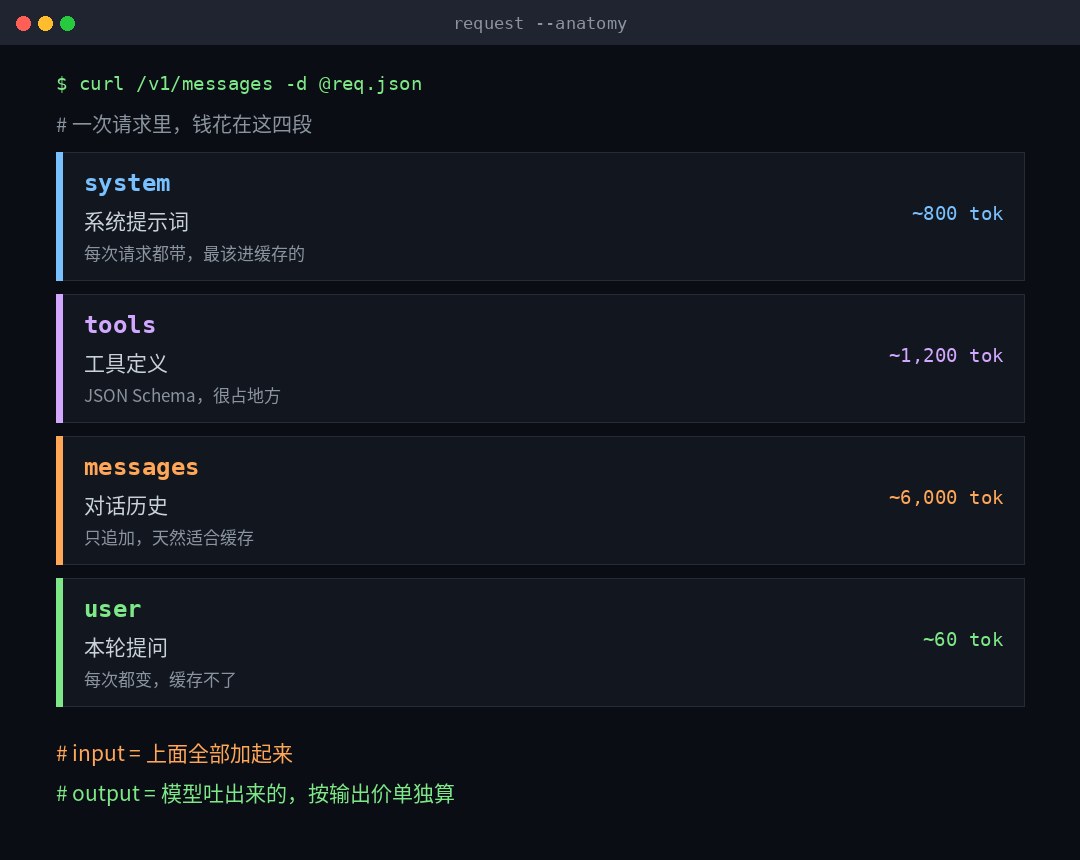
De input van een verzoek wordt meestal in vier delen gedaan:
| Paragraaf | Engelse naam | Wat is er? | Zal het veranderen? |
|---|---|---|---|
| Systeemhint | Systeem / inclusie | Wie zijn jullie, de regels, het uitvoerformaat? | Het is eigenlijk hetzelfde. |
| Hulpmiddeldefinitie | Ik denk het niet. | Functie JSON Schema en beschrijving | Zeer zelden. |
| Geschiedenis van de dialoog | Berichten / geschiedenis | Elke ronde vragen en antwoorden voor u, neem ze allemaal. | Alleen toevoegen |
| Vragen voor deze ronde | Het spijt me, meneer. | Dat ding dat je net belde. | Elke keer. |
De eerste keer was ik bang.Het gereedschap definieert het bedrag van 1200 tokensIk weet het niet. Een functie met parameter beschrijving, JSON Schema breidt uit naar speciale plaats. Je schreef 20 gereedschappen, je kon per definitie 2000 eten.En je typte geen woord in dit deel, maar het is altijd geladen.
Er zit een belangrijk punt achter:De eerste drie alinea's zijn "extra" en "niet" en de vierde alinea verandert telkens.Het is geen toeval. Het bepaalt of de cache geraakt kan worden.
Drie: input, output en die in de output.
Het officiële kaliber van deze drie relaties is als volgt:
- Voer token in (input / policy tokens): Alles wat u doorstuurt bevat de vier bovenstaande paragrafen.
- Uitvoer: Gemodelleerd. Attentie...Niet alleen de sms die je zag.
- Token: Het model is wat het denkt voordat het het antwoord geeft. Je kunt niets zien, maar het...Tegen productieprijzenIk weet het niet.
De derde is de echte reden voor veel mensen om hun rekeningen te verdubbelen. Ik heb een soort baan met een theoriemodel, en ik zie 20 woorden in het antwoord, en het wetsvoorstel is meer dan 900.Dat 880 onzichtbare teken, het staat er allemaal in.
Dus het is normaal om een tegenstrijdigheid te hebben:Hoe korter het antwoord, hoe goedkoper hoe minder.
De outputprijs is meestal ongeveer vijf keer de inputprijs (zie onderstaande tabel voor elk huishouden). Dit verklaart een integriteitsbeginsel:Het kan worden opgelost met input. Laat het er niet uit.Zet het antwoord sjabloon, het formaat voorbeeld, in de systeem hint (onder), zodat het zich niet zodanig organiseren dat het is duur.
Cacheline en onaantrekkelijk: dit is het gedeelte van de hele tekst dat moet worden onthouden
Wat zijn dat?
Modellen worden als tussenliggende gerekend wanneer ze worden gelezen. Dit deel is het duurste.
Prompt cache is een vooraf vastgestelde staat.De volgende keer dat we hetzelfde voorvoegsel ontmoeten, gebruiken we het direct en berekenen we niet meer opnieuw.
Dus er waren twee woorden:
- Cache hit: Dit voorvoegsel werd gevonden in de cache. Dit deel werd ingevoerd en geperst.De korting.Vergoedingen.
- Cache mistIk kan het niet vinden. Bereken gewoon de prijs.
De voorwaarden van de aanslag zijn moeilijker dan je denkt.
De sleutel is het woord "prefix."Het gaat niet over dezelfde vraag stellen.
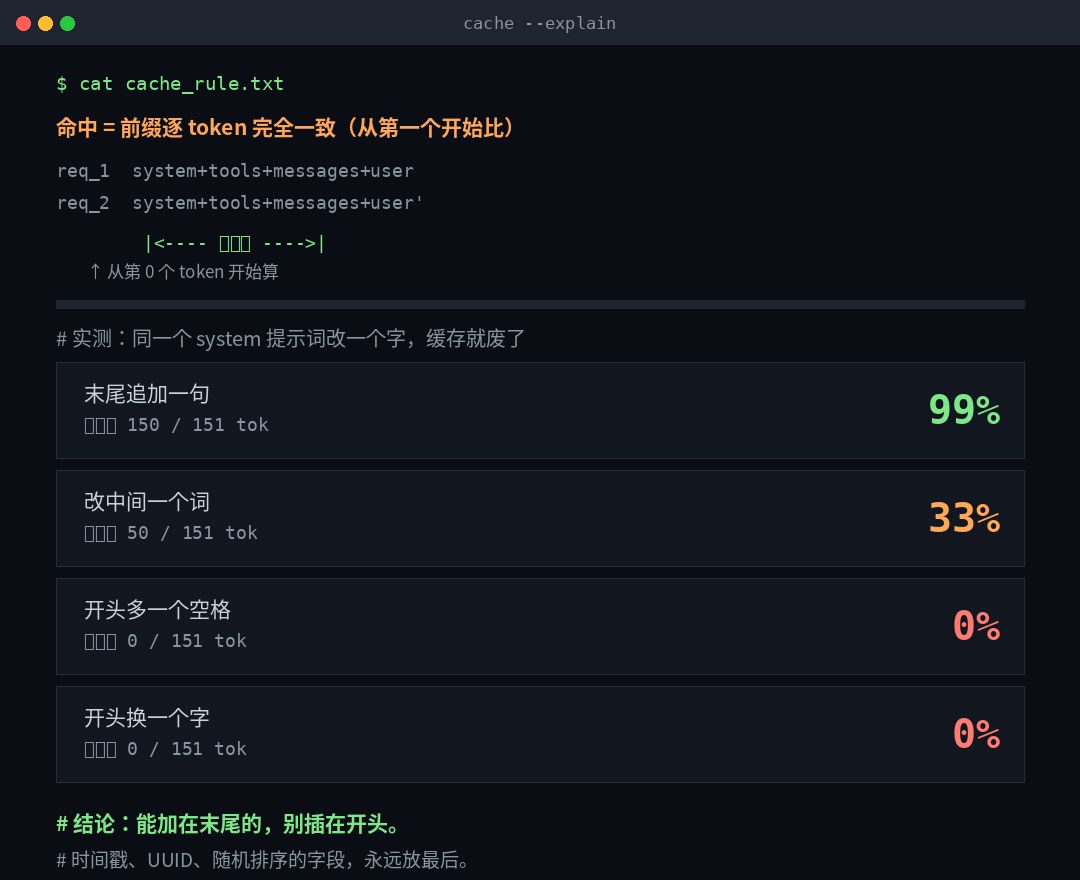
Ik deed een experiment: Ik nam een 151 token systeem hint, veranderde het naar verschillende locaties, en keek hoeveel het kan worden hergebruikt.
| Wijzigingen | Herbruikbare voorvoegsel | Percentage |
|---|---|---|
| Aan het eind een zin toevoegen | 150 / 151 | 99% |
| Verander het woord in het midden. | 50 / 151 | 33% |
| Nog één ruimte aan het begin | 0 / 151 | 0% |
| Begin met een woord. | 0 / 151 | 0% |
Zie je die "nog één ruimte aan het begin"?Een ruimte, caches, gesloopt, herberekend 151 tokens tegen originele prijzen.
Het is geen bug, het is het principe: Cache is de staat van accumulatie vanaf het begin, de eerste token verandert, en de achterkant is allemaal dood.
Er is dus een regel die onmiddellijk toegepast kan worden:De constante inhoud is aan de voorzijde en de variabele inhoud aan de laatste.
De meest voorkomende manier om te flippen is om de huidige tijd, gevraagde ID, willekeurig gesorteerde velden aan het begin van het systeem hint in te voegen. Dat is als een nieuwe cache elke keer.Deze velden worden verplaatst naar het einde of gewoon niet in gezet.
Er zijn een paar makkelijk te negeren drempels.
- Er is een minimale lengte.Te kort een voorvoegsel geeft de cache helemaal niet. OpenAI is GPT-5.6 en later 1.024 token; Antropisch wordt gescheiden door model, beide in 512 / 1.024 / 2.048 / 4.096. Als het niet lang genoeg is, is het niet verkeerd.Stilte.Je kunt alleen zien door het kwantumveld terug te geven.
- Er is tijd om te overleven.OpenAI standaard 30 minuten (tot 12 uur); Antropische standaard 5 minuten, tot 1 uur. En deze keer...Begin op verzoek, niet tellen vanaf het einde van het antwoord -- als het antwoord over vier minuten loopt, heeft het 5 minuten durende slot slechts één minuut venster.
- We wachten op elkaar.Cache-invoer wacht op eerste verzoekBegin terug te kerenDan is het beschikbaar. Tien verzoeken werden verzonden in dezelfde seconde, en alle tien werden gemist.
- Veranderde modellen, veranderde hulpmiddelen, veranderde redenering slots.Het voorvoegsel verandert en de hit rate is nul.
Wat is de hits?
Niet raden. Beide families gaven hen een volumeveld:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antropisch, het speciale intuïtief:Beiden gaven 0 terug, wat betekent dat ze niet eens de cache bereikten.- Meestal omdat voorvoegsels niet minimaal zijn.
V. Prijsstructuur: meer geld schrijven om minder te lezen
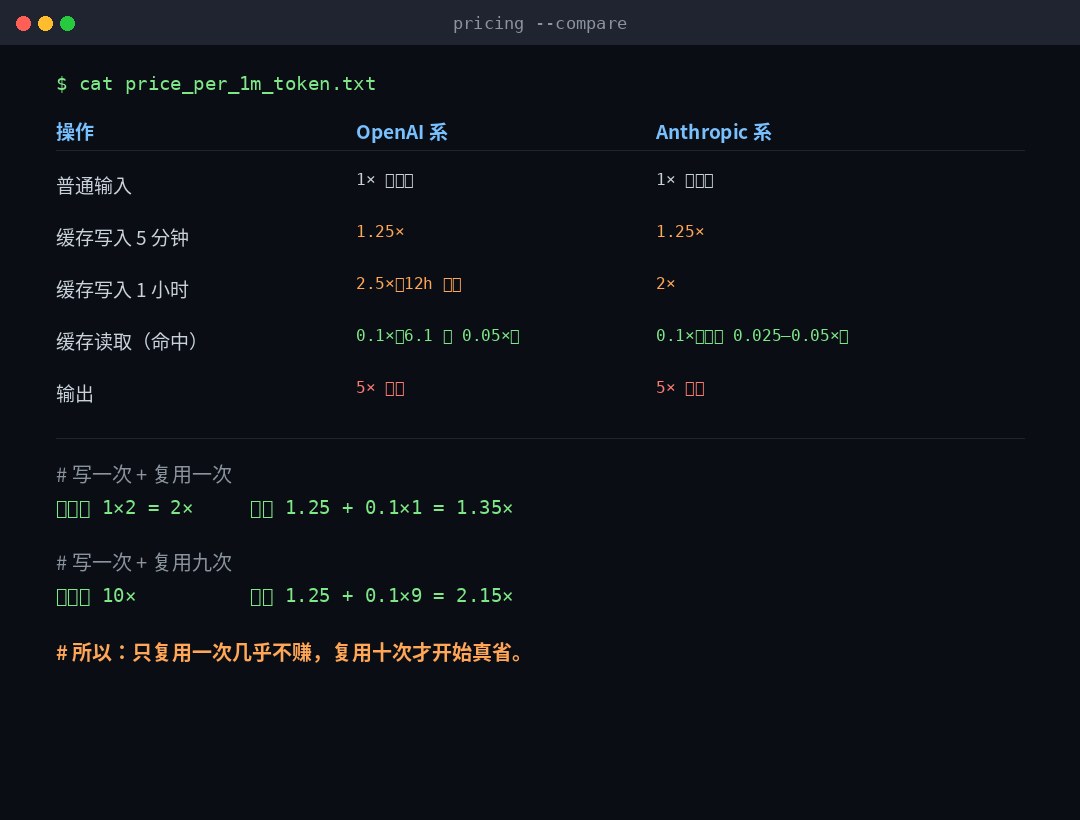
Cache is niet gratis, en velen hebben het gemist.De eerste keer dat je in de cache schrijft, moet je de prijs verhogen; lees het dan voordat je een korting maakt.
| Werking | OpenAI | Antropisch |
|---|---|---|
| Normale invoer | 1x (basislijn) | 1x (basislijn) |
| Cache schrijven. Korte slot | 1,25 x (30 minuten) | 1,25 x (5 minuten) |
| Cache schrijven op lange termijn | 2,5 x (12 uur) | 2x (1 uur) |
| Cache Read (categorie) | 0,1 x(GPT-6.1 is 0,05 x) | 0,1 x(Deelmodel 0.025 |
| Uitvoer | Ongeveer 5x | Ongeveer 5x |
Neem de normale 0.1 x lezen, 1,25 x twee boeken schrijven:
- Eén keer schrijven + één keer hergebruikenCache 1,25 + 0,1 = 1,35 x;geen cache is 1 + 1 = 2 x.Provincie 32%.
- Eén keer + negen keer herhalen: Cache 1,25 + 0,9 = 2,15 x;geen cache is 10x.provincie 78 procent.
Dit betekent:In één geval was de cache nauwelijks of zelfs licht verloren gegaan; alleen bij herhaalde meer dan tien keer waren de besparingen echt.Die eenmalige tijdelijke gesprekken zijn gewoon een probleem.
Trouwens:Cache schrijven is gebaseerd op het token segment, niet op het nummer.Het breekpunt zelf is gratis, en het geld dat wordt uitgegeven hangt af van hoe lang je eigenlijk hebt.
VI. GESCHILLEN, SYSTEEMGESCHILLEN, min.
De twee termen worden vaak onderling vermengd gebruikt, maar zij verschillen qua kosten en autoriteit.
| Naam | Engels | Wie heeft het geschreven? | Prioriteit | Toeschrijving van de vergoeding |
|---|---|---|---|---|
| Systeemhint | Instellingen | Platformer of Application Developer | Hoogste | Token invoeren |
| Ontwikkelaarbericht | Ik weet niet of ik dat wel kan. | Ontwikkelaar toepassen | Lager (boven gebruikers) | Token invoeren |
| Gebruikershint | Het zijn onze zaken. | Eindgebruiker | Minder dan de twee hierboven | Token invoeren |
| Assistentbericht | Er is geen reden waarom je hier bent. | Modellen genereren zichzelf | Ik weet het niet. | Uitvoer Token |
Twee eenvoudige punten:
- Het woord "advertentie" is een groot woord.Het verwijst in het algemeen naar alle tekstinstructies die u naar het model stuurt, en de "systemale hint" is degene die de meest vooruitstrevende en hoogste prioriteit heeft. Als het gaat om "advertenties zijn te lang" is het echte probleem vaak dat het systeem te lang is om ze te definiëren.
- Rol is ook duur.Elk bericht is één laag
{"role":...,"content":...}En de laag zelf telt als token. Als er veel berichten zijn, zullen het duizenden dingen zijn.
Dus de opruimdialoog werkt -- niet geniaal, ja.Snij dat deel van de geschiedenis af.Ik weet het niet. Maar op zijn beurt is het belangrijk op te merken dat na het opruimen de historische voorvoegsels van de eerder gehouden dialoog niet nodig zijn.
Zeven of zeven van de pits waar ik op stapte, kopieer de conclusies.
- Gebruik het woord "karakter" om het Chinese budget te schatten.Fout. Chinees is bijna één woord, en je bent twee keer zo kort. Het is klaar.
tiktokenHet definiëren of terugkijken op gebruik. - Ik dacht dat ik geraakt zou worden als ik een soortgelijke vraag stelde.Kan niet. Moet volledig consistent zijn vanaf het eerste teken.
- Plaatst een tijdstempel aan het begin van het systeem hint.Dit is de meest voorkomende cache moordenaar. Ga naar het einde.
- Het is goedkoop om korte antwoorden te zien.Het denkproces van het redeneren model wordt geprijsd tegen de output prijs, antwoord 20 woorden, lading 900 token is normaal.
- Cache voor eenmalige dialoog.Hergebruik bespaarde slechts 32 procent, maar voegde een laag van complexiteit en debugging kosten. Het is het minstens drie keer waard.
- Je kunt de slagsnelheid raden zonder naar een meetveld te kijken.Twee.
cached_tokens/cache_read_input_tokensZe kwamen allemaal terug in duidelijke code. - Hij vroeg ook om de cache te gebruiken om snelheid te verhogen.De cache zal niet beschikbaar zijn totdat het eerste antwoord begint, en verzoeken voor dezelfde seconde worden grotendeels gemist.
VIII. Een lijst van wat er is gedaan
We kunnen vandaag veranderen.
- Systeemhints en -tools definiërenAlles wat verandert.Ga naar het einde van het bericht.
- DrukkenVaste volgordeRegel. De volgorde verandert het voorvoegsel, het voorvoegsel verandert.
- Eerste telling: Typ het aantal tokens in het systeem + gereedschapsdefinitie. Meer dan 2000 is het optimaliseren waard.
Het is een halve dag waard.
- Demonteer een lange systeem hint in een "consistent + variabel segment " , met een cache pauze aan het einde van het constante segment.
- Ren rond met echt verkeer. Opname.
cached_tokensPercentage van de totale productie. Minder dan 30% duidt op voorvoegselontwerpproblemen. - Druk ook op de output kant: de "output alleen" is niet toegestaan om uit te leggen, de output prijs is vijf keer de input.
Doe het niet.
- Schrijf geen half tien fooi voor de cache.Cache is geld, geen duidelijkheid.
- Voeg niet toe aan eenmalige scripts de logica van caches, die zijn ingewikkelder dan besparingen.
- Er wordt niet aangenomen dat caches kunnen worden gebruikt in verschillende modellen.Schakelen modellen verandert caches, met nul hits.
Eindelijk.
Deze woorden worden tot het einde genomen, en ze zeggen maar één ding:Het model rekent "hoeveel het leest in" en "hoeveel het schrijft," en de cache is het enige mechanisme dat kan korting "lezen."
Dus het is niet precies hoe mooi de hint is?Zet die stapel dingen die niet elke keer veranderen. Laten we gaan.Ik weet het niet.
Het meeste geld dat je niet kunt besparen is niet te duur. Je voorvoegsel verandert elke keer.
Ik laat u met de meest praktische actie: de volgende keer dat ik een abnormale rekening zie, twijfel niet aan de prijsverhoging van het model. cached_tokens Die kolom.Het is niet nul, beslist of je betaalt voor wiskunde of dubbel.