
輸入、輸出、緩存命中:AI token 賬單上的名詞,看懂這一篇就夠了
先說結果:這些名詞裏,真正會讓你多花錢的只有兩個——「緩存未命中」和「輸出 token」。剩下的都是它們的註釋。
我這兩個月被賬單教育了三次,都是同一個毛病:以爲自己在省錢,其實在給同一個前綴反覆付全價。這篇把我踩過的坑和查到的官方口徑一次寫清楚,看完你至少能回答一個問題——爲什麼我明明只發了一句話,賬單上卻有八千個輸入 token。
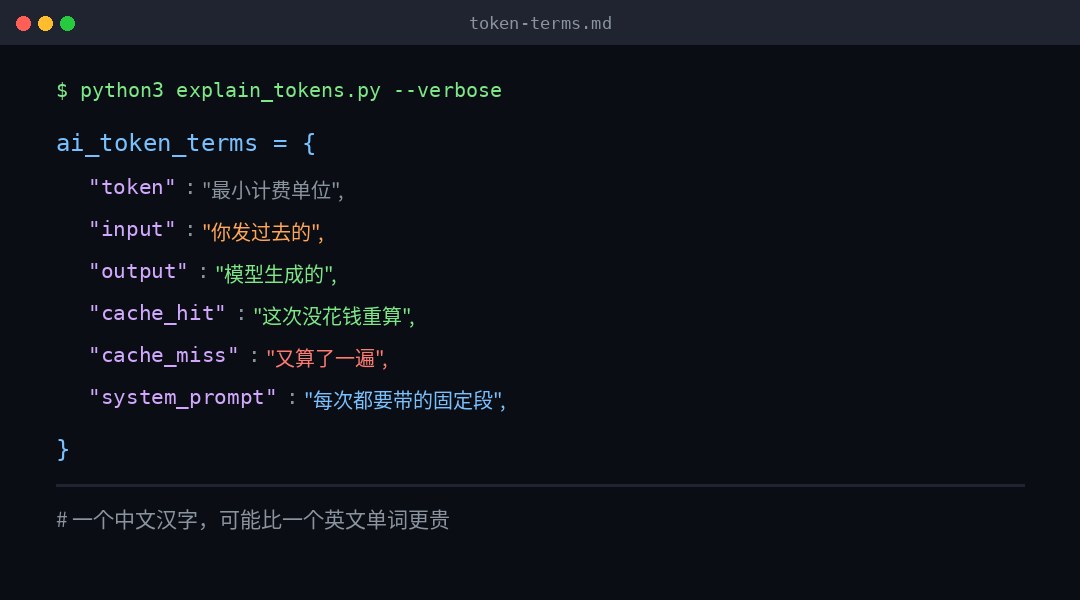
一、token 是什麼,爲什麼中文更貴
token 是模型處理文本的最小單位。它不是字,也不是詞,是分詞器切出來的一塊。同一句話,不同模型、不同編碼,切出來的塊數可以不一樣。
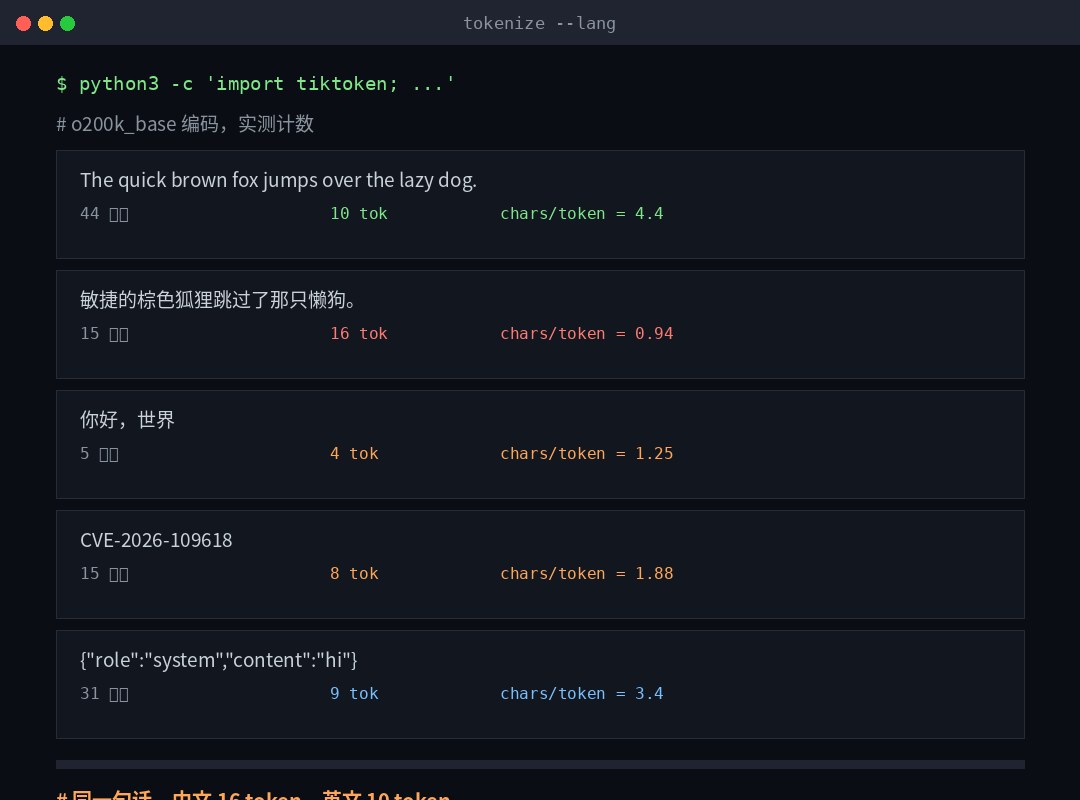
我拿 o200k_base 編碼實測了幾組,差別比想象的大:
| 文本 | 字符數 | token 數 | 字符/token |
|---|---|---|---|
| The quick brown fox jumps over the lazy dog. | 44 | 10 | 4.4 |
| 敏捷的棕色狐狸跳過了那隻懶狗。 | 15 | 16 | 0.94 |
| 你好,世界 | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
看出問題了嗎。同一句話,英文 10 個 token,中文 16 個。英文大約 4 個字符才 1 個 token,中文接近一個字 1 個 token。
這條對中文用戶非常不友好:網上流傳的「1 token ≈ 4 字符」是英文經驗值,你拿它估中文,會低估一半以上。
還有一個反直覺的:CVE-2026-109618 這種編號,15 個字符燒 8 個 token。數字和連字符會被切得很碎。所以日誌、哈希、ID 這類內容,比看起來貴得多。
二、一次請求的錢,花在四段上
我第一次看賬單時最困惑的不是貴,是明明只問了一句話,輸入卻有八千多 token。後來才明白,輸入不止你打的那句話。
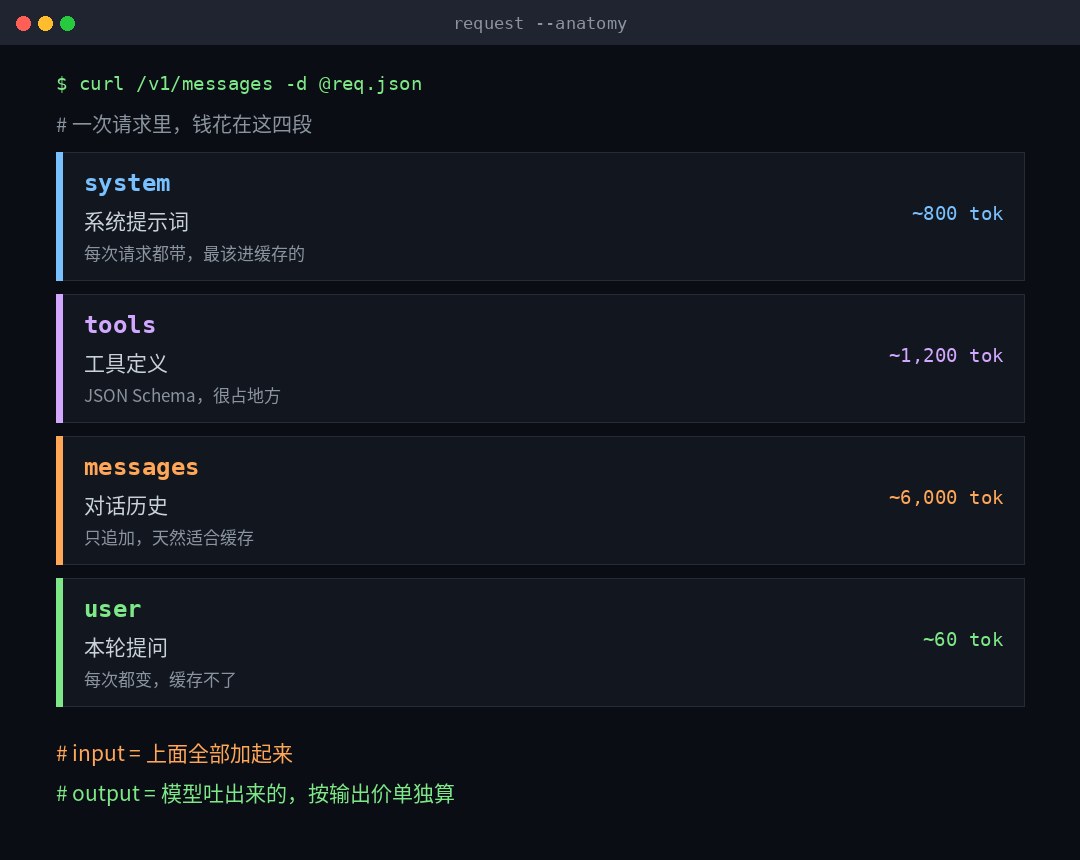
一次請求的輸入,通常是四段拼起來的:
| 段 | 英文名 | 是什麼 | 會不會變 |
|---|---|---|---|
| 系統提示詞 | system / instructions | 你是誰的設定、規則、輸出格式 | 基本不變 |
| 工具定義 | tools | 函數的 JSON Schema 和描述 | 很少變 |
| 對話歷史 | messages / history | 之前每一輪的問答,全帶上 | 只追加 |
| 本輪提問 | user | 你剛打的那句話 | 每次都變 |
我第一次被嚇到的那次,就是工具定義那一坨佔了 1,200 個 token。一個函數帶參數描述,JSON Schema 展開來特別佔地方。你寫了 20 個工具,光定義就能喫掉兩千。而且這部分你一個字都沒打,但它每次都收費。
這裏埋着一個後面要用的關鍵點:前三段都是「只追加、不修改」的結構,第四段每次都變。這個順序不是巧合,它決定了緩存能不能命中。
三、輸入、輸出,還有那個藏在輸出裏的
這三者的關係,官方口徑是這樣的:
- 輸入 token(input / prompt tokens):你發過去的一切,包含上面那四段。
- 輸出 token(output / completion tokens):模型生成的。注意——不只是你看到的那段文字。
- 推理 token(reasoning tokens):推理模型在給出答案前,內部想的那些。你看不到,但它按輸出價計費。
第三條是很多人賬單翻倍的真正原因。我用推理模型跑一個分類任務,看到答案只有 20 個字,賬單上輸出卻是 900 多。那 880 個看不見的 token,全是它在裏面琢磨。
所以有個看起來矛盾的現象是正常的:答案越短,不一定越便宜。
輸出價通常是輸入價的 5 倍左右(各家的具體倍率見後面那張表)。這也解釋了一個實操原則:能用輸入解決的,別讓它輸出。把答案模板、格式示例放進系統提示詞(便宜),別讓它自己長篇大論地組織(貴)。
四、緩存命中與未命中:這是全文最該記住的一節
它們到底是什麼
模型讀輸入的時候,會算一堆中間狀態(叫 KV state)。這部分算力最貴。
提示詞緩存(prompt caching)就是把某個前綴算出來的狀態存下來,下次遇到一樣的前綴,直接拿來用,不再重算。
於是就有了兩個詞:
- 緩存命中(cache hit):這次的前綴在緩存裏找到了,這部分輸入按折扣價收費。
- 緩存未命中(cache miss):沒找到,老老實實按原價重算一遍。
命中的條件,比你想的嚴
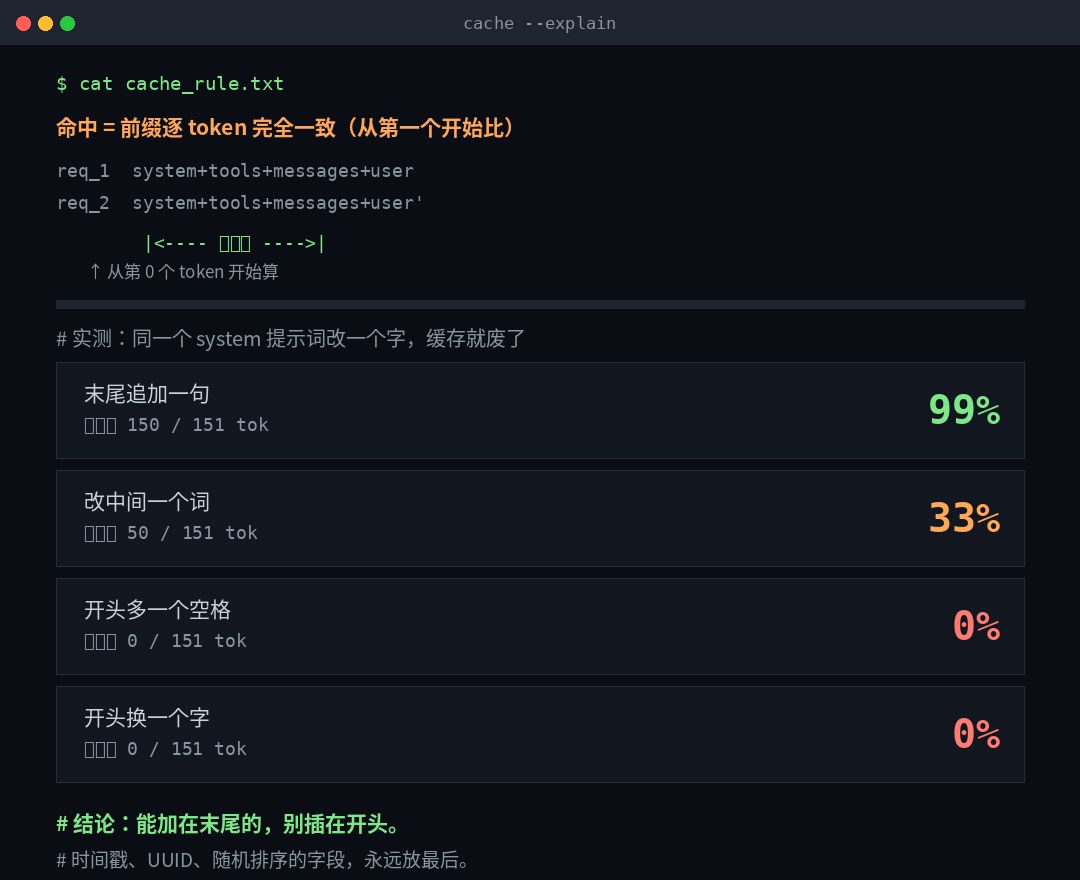
關鍵在「前綴」兩個字。不是「問了差不多的問題」,是從第 0 個 token 開始逐字一致。
我做了個實驗:拿一個 151 個 token 的中文系統提示詞,改不同位置,看能複用多少。
| 改動方式 | 可複用前綴 | 比例 |
|---|---|---|
| 末尾追加一句話 | 150 / 151 | 99% |
| 中間改一個詞 | 50 / 151 | 33% |
| 開頭多一個空格 | 0 / 151 | 0% |
| 開頭換一個字 | 0 / 151 | 0% |
看到那個「開頭多一個空格」了嗎。一個空格,緩存全廢,按原價重算 151 個 token。
這不是 bug,是原理:緩存存的是從開頭累積的狀態,第一個 token 變了,後面全部失效。
所以有一條可以立刻用上的規則:恆定內容放最前面,會變的內容放最後面。
最常見的翻車寫法是把當前時間、請求 ID、隨機排序的字段塞在系統提示詞開頭。那等於每次都在新起一個緩存。這些字段要麼挪到最末尾,要麼乾脆別放進去。
還有幾個容易忽略的門檻
- 有最小長度。太短的前綴根本不給緩存。OpenAI 是 GPT-5.6 及以後 1,024 token 起;Anthropic 按模型分檔,512 / 1,024 / 2,048 / 4,096 都有。不夠長的話不報錯,靜默不緩存,你只能從返回的用量字段看出來。
- 有存活時間。OpenAI 默認 30 分鐘(可到 12 小時);Anthropic 默認 5 分鐘,可升到 1 小時。而且這個時間從請求開始算,不是從回答結束算——回答如果流了 4 分鐘,5 分鐘檔只剩 1 分鐘窗口。
- 併發時會互相等。緩存條目要等第一個請求開始返回之後纔可用。同一秒發 10 個請求,這 10 個大概率都是未命中。
- 換了模型、換了工具、改了推理檔位,前綴就變了,命中率歸零。
命中率怎麼看
別靠猜。兩家都給用量字段:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Anthropic 那個特別直觀:兩個都返回 0,說明壓根沒進緩存——通常是因爲前綴沒到最小長度。
五、價格結構:寫要加錢,讀才便宜
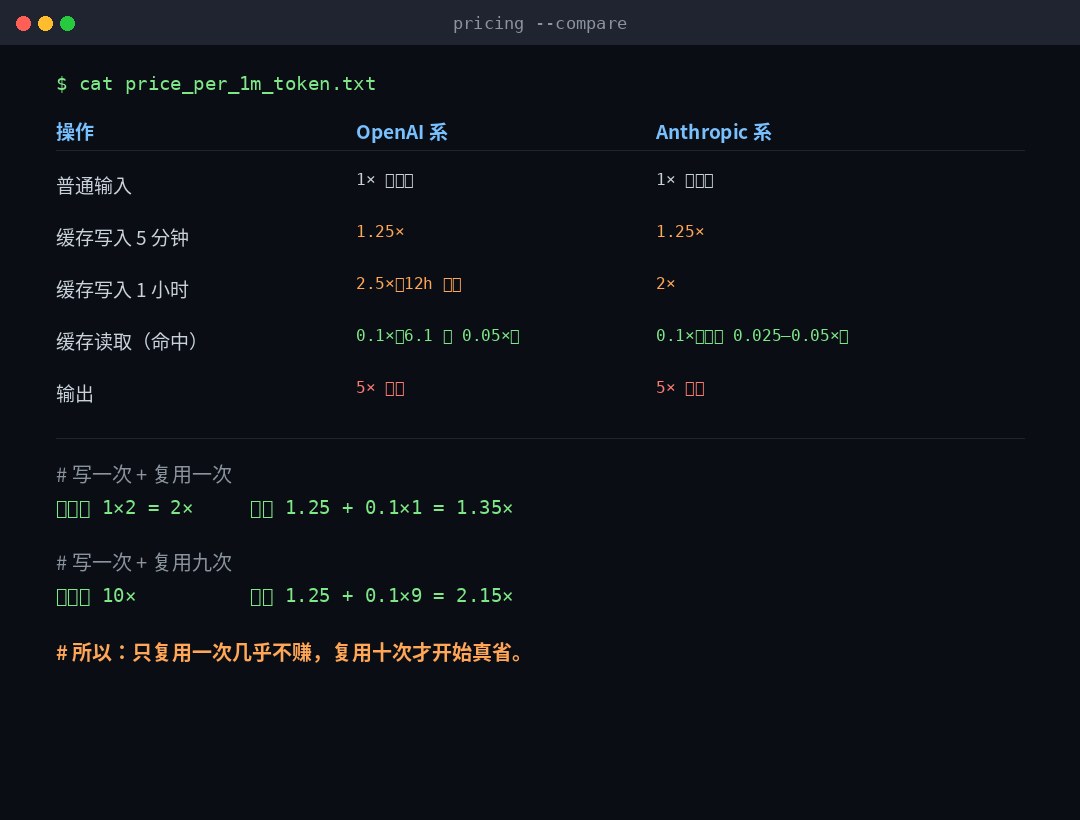
緩存不是免費的,這一點很多人漏掉。第一次寫進緩存,要加價;之後讀,纔打折。
| 操作 | OpenAI | Anthropic |
|---|---|---|
| 普通輸入 | 1×(基準) | 1×(基準) |
| 緩存寫入 · 短期檔 | 1.25×(30 分鐘) | 1.25×(5 分鐘) |
| 緩存寫入 · 長期檔 | 2.5×(12 小時) | 2×(1 小時) |
| 緩存讀取(命中) | 0.1×(GPT-6.1 系 0.05×) | 0.1×(部分模型 0.025–0.05×) |
| 輸出 | 約 5× | 約 5× |
拿最普通的 0.1× 讀、1.25× 寫算兩筆賬:
- 寫一次 + 複用一次:緩存 1.25 + 0.1 = 1.35×;不緩存是 1 + 1 = 2×。省 32%。
- 寫一次 + 複用九次:緩存 1.25 + 0.9 = 2.15×;不緩存是 10×。省 78%。
這條賬的意思是:只用一次的話,緩存幾乎不賺甚至略虧;複用十次以上,纔是真的省。那些「一次性的臨時對話」開緩存,純屬給自己找麻煩。
順帶一句:緩存的寫入是按 token 段算的,不是按次。加斷點本身不花錢,花的錢取決於你實際緩存了多長的內容。
六、提示詞、系統提示詞,到底怎麼分
這兩個詞經常被混着用,但在計費和權限上是兩回事。
| 名稱 | 英文 | 誰寫的 | 優先級 | 計費歸屬 |
|---|---|---|---|---|
| 系統提示詞 | system prompt / instructions | 平臺方或應用開發者 | 最高 | 輸入 token |
| 開發者消息 | developer message | 應用開發者 | 次高(高於用戶) | 輸入 token |
| 用戶提示詞 | user prompt | 終端用戶 | 低於上面兩者 | 輸入 token |
| 助手消息 | assistant message | 模型自己生成 | — | 輸出 token |
兩個容易踩的點:
- 「提示詞」是個大詞。它泛指你發給模型的所有文字指令,而「系統提示詞」只是其中最靠前、優先級最高的那一段。說「提示詞太長」時,往往真正的問題是系統提示詞和工具定義太長。
- role 也是要花錢的。每條消息包一層
{"role":...,"content":...},這層結構本身也算 token。消息條數多的時候,光包裝就能上千。
所以「清空對話重開」這個動作是有效的——不是玄學,是把歷史那一段砍掉了。但反過來也要注意:清空之後,之前緩存的對話歷史前綴也用不上了。
七、七個我踩過的坑,直接抄結論
- 拿「字符數 ÷ 4」估中文預算。錯。中文接近 1 字 1 token,你這麼估會少算一倍。要準就用
tiktoken實測,或者看返回的 usage。 - 以爲「問過類似問題」就能命中。不能。必須從第一個 token 起完全一致。
- 在系統提示詞開頭插時間戳。這是最常見的緩存殺手。挪到末尾。
- 看到答案短就以爲便宜。推理模型的思考過程按輸出價收費,答案 20 字、計費 900 token 是常態。
- 給一次性對話開緩存。一次複用只省 32%,但多了一層複雜度和調試成本。至少三次複用才值得。
- 不看用量字段就猜命中率。兩家的
cached_tokens/cache_read_input_tokens都是明碼返回的。 - 併發發請求想靠緩存提速。緩存要等第一個響應開始纔可用,同一秒發出去的請求基本都未命中。
八、照着做的一份清單
今天就能改的
- 把系統提示詞和工具定義裏所有會變的東西(時間、ID、用戶信息、隨機字段)挪到消息末尾。
- 工具按固定順序排列。順序變了前綴就變,白丟緩存。
- 先量一次:把系統提示詞 + 工具定義的 token 數打出來。超過 2,000 就值得優化了。
值得花半天做的
- 把一個長系統提示詞拆成「恆定段 + 易變段」,在恆定段末尾打緩存斷點。
- 用真實流量跑一輪,記錄
cached_tokens佔總輸入的比例。低於 30% 說明前綴設計有問題。 - 把輸出側也壓一壓:能要求「只輸出 JSON」就別讓它寫解釋,輸出價是輸入的五倍。
別做的
- 別爲了緩存把提示詞寫得九曲十八彎。緩存省的是錢,不是清晰度。
- 別在一次性腳本里加緩存邏輯,多出來的複雜度比省下的錢貴。
- 別假設不同模型之間緩存能通用。換模型就是換緩存,命中率歸零。
最後
這些名詞拆到最後,其實只講了一件事:模型按「它讀進去多少」和「它寫出來多少」收費,而緩存是唯一一個能把「讀」打折的機制。
所以真正該優化的不是提示詞寫得多漂亮,是把那堆每次都不變的東西,放在每次都不變的位置上。
你省不下來的錢,多半不是模型太貴,是你的前綴每次都在變。
最後留個最實用的動作:下次看到賬單異常,先別懷疑模型漲價,去看 cached_tokens 那一欄。它是不是 0,決定了你是在爲算力付錢,還是在爲重複付錢。