
Enter, output, cache life: nazwa na symbolu AI.
Zacznijmy od wyników:Są tylko dwa słowa w tych słowach, które naprawdę kosztują Cię więcej: "Cacheft" i "wyjście" token.Reszta to ich notatki.
Trzy razy w ciągu dwóch miesięcy, i to samo: myślę, że oszczędzam pieniądze i płacę pełną cenę za ten sam prefiks. To jest ten, w którym możesz odpowiedzieć na przynajmniej jedno pytanie...Dlaczego mam 8000 żetonów na rachunku, skoro powiedziałem tylko jedno słowo?
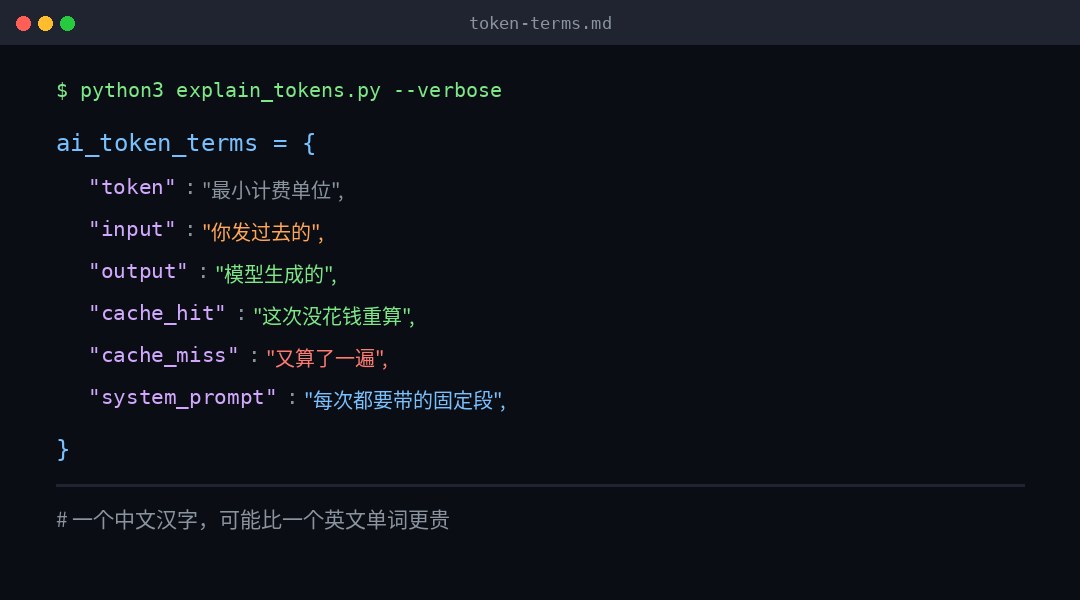
I. Token. Dlaczego Chińczycy są drożsi?
Token jest najmniejszą jednostką do modelowego przetwarzania tekstu. To nie jest słowo. To nie jest słowo.To kawałek cięty przez semantykę.Nie wiem. W tym samym zdaniu liczba bloków cięcia może różnić się w zależności od modelu do kodu.
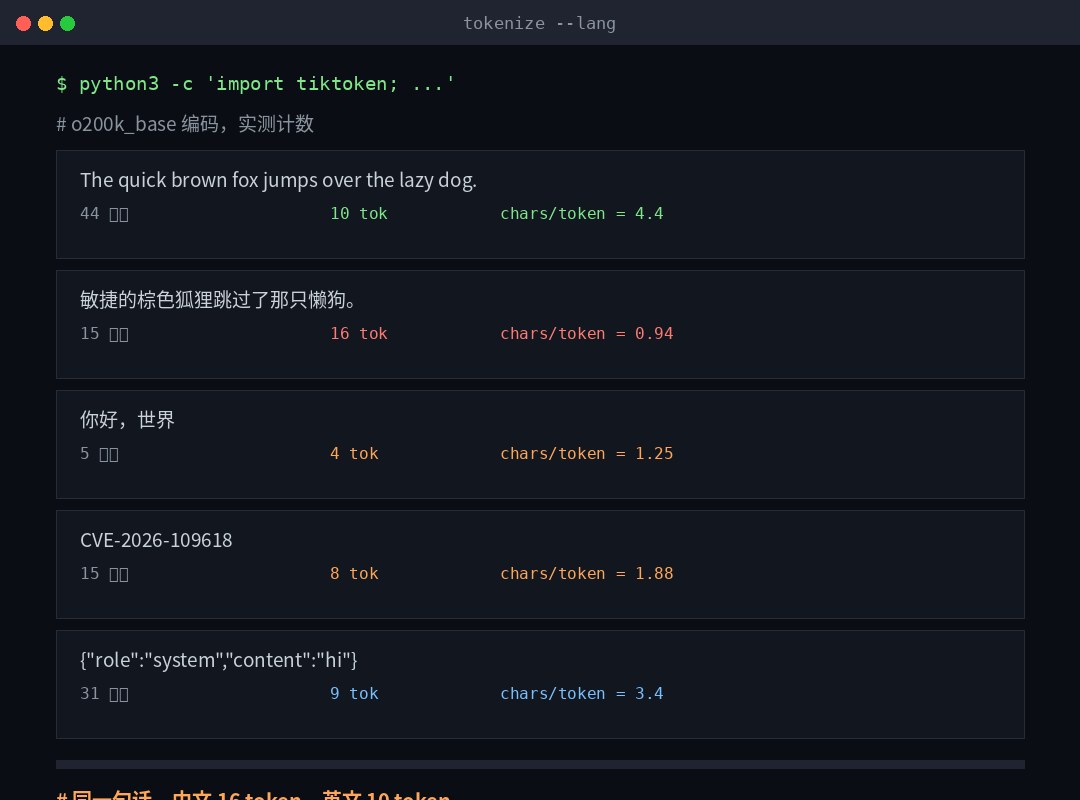
Wezmę to. o200k_base Kod faktycznie mierzył kilka grup, a różnica była większa niż oczekiwano:
| Tekst | Liczba znaków | Numer tokena | Znak / token |
|---|---|---|---|
| Szybkie brązowe pudełko skacze nad leniwym psem. | 44 | 10 | 4.4 |
| Szybki brązowy lis skoczył przez tego leniwego psa. | 15 | 16 | 0.94 |
| Witaj, świecie. | 5 | 4 | 1.25 |
| CVE- 2026- 109618 | 15 | 8 | 1.88 |
Zobacz problem.W tym samym zdaniu 10 żetonów po angielsku i 16 po chińsku.O 4 znaki w języku angielskimJedno słowo, jeden żetonNie wiem.
Jest to bardzo nieprzyjazne dla użytkowników chińskich: "1 token control4" to doświadczenie języka angielskiego.Nie docenisz ponad połowy po chińsku.
Istnieje przeciwna intuicja:CVE-2026-109618 Ten numer, 15 znaków spala 8 żetonów. Liczby i hifeny są bardzo źle cięte.Więc jest dużo droższy niż wygląda.
Dwa, jeden wniosek, cztery akapity.
Kiedy pierwszy raz spojrzałem na rachunek, nie był drogi.To tylko jedno słowo, ale 8000 tokena.Nie wiem. Wtedy stało się jasne, że bardziej niż ty.
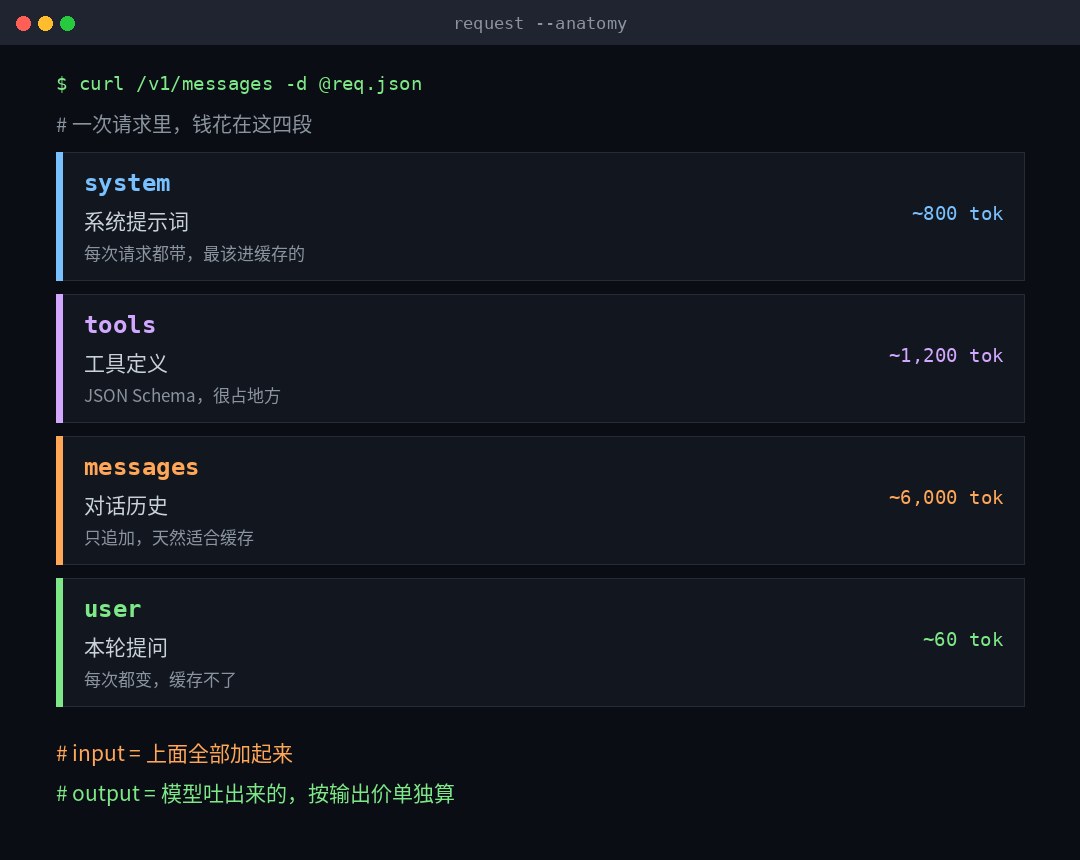
Wniosek jest zazwyczaj wprowadzany w czterech częściach:
| Punkt | Nazwa | O co chodzi? | Czy to się zmieni? |
|---|---|---|---|
| System Podpowiedź | System / włączenie | Kim jesteś, zasadami, formatem wyjściowym? | To w zasadzie to samo. |
| Definicja narzędzia | Nie sądzę. | Funkcja JSON Schema i opis | Bardzo rzadko. |
| Historia dialogu | Wiadomości / historia | Każda runda pytań i odpowiedzi przed tobą, weź je wszystkie. | Dodaj tylko |
| Pytania dotyczące tej rundy | Przepraszam. | To coś, co właśnie nazwałeś. | Za każdym razem. |
Pierwszy raz się bałem.Narzędzie definiuje ilość 1200 żetonówNie wiem. Funkcja z opisem parametrów, JSON Schema rozszerza się, aby zająć specjalne miejsce. Napisałeś 20 narzędzi, mógłbyś zjeść 2000 z definicji.I nie wpisałeś tu słowa, ale zawsze jest naładowane.
Jest za tym kluczowy punkt:Pierwsze trzy akapity są "dodatkowe i niezmienione", a czwarty akapit zmienia się za każdym razem.To nie przypadek. Określa, czy cache może zostać trafiony.
Trzy: wejście, wyjście i to w wyjściu.
Oficjalny kaliber tych trzech związków jest następujący:
- Wprowadź token (znaczniki wejścia / polityki): Wszystko przez co prześlesz zawiera cztery akapity powyżej.
- Wyjście: Modelowany. Uwaga...Nie tylko wiadomość, którą widziałeś.
- Token: Model rozumowania jest tym, co myśli zanim da odpowiedź. Nie widzisz, ale...W cenach produkcjiNie wiem.
Trzeci jest prawdziwym powodem dla wielu ludzi do podwojenia rachunków. Prowadzę pewnego rodzaju pracę z modelem teorii, i widzę 20 słów w odpowiedzi, i rachunek jest ponad 900.Ten niewidzialny symbol 880, jest tam.
Więc to normalne mieć sprzeczność:Im krótsza odpowiedź, tym tańsza.
Cena wyjściowa jest zwykle około pięciu razy większa od ceny wejściowej (patrz tabela poniżej dla każdego gospodarstwa domowego). Wyjaśnia to zasadę integralności:Można to rozwiązać za pomocą wejścia. Nie wypuszczaj tego.Umieść szablon odpowiedzi, przykład formatu, w podpowiedzi systemowej (poniżej), tak aby nie organizował się w taki sposób, że jest kosztowny.
Kakielina i nieatrakcyjne: to jest część całego tekstu, który należy zapamiętać
Co to jest?
Modele są liczone jako pośrednie, gdy są odczytywane. Ta część jest najdroższa.
Prompt cache to stan z góry ustalony.Następnym razem, gdy spotkamy się z tym samym przedrostkiem, użyjemy go bezpośrednio i nie będziemy już ponownie obliczać.
Były dwa słowa:
- Hit cache: Ten przedrostek został znaleziony w pamięci podręcznej. Ta część została wciśnięta i wciśnięta.Zniżka.Opłaty.
- Cache missNie mogę go znaleźć. Przelicz cenę.
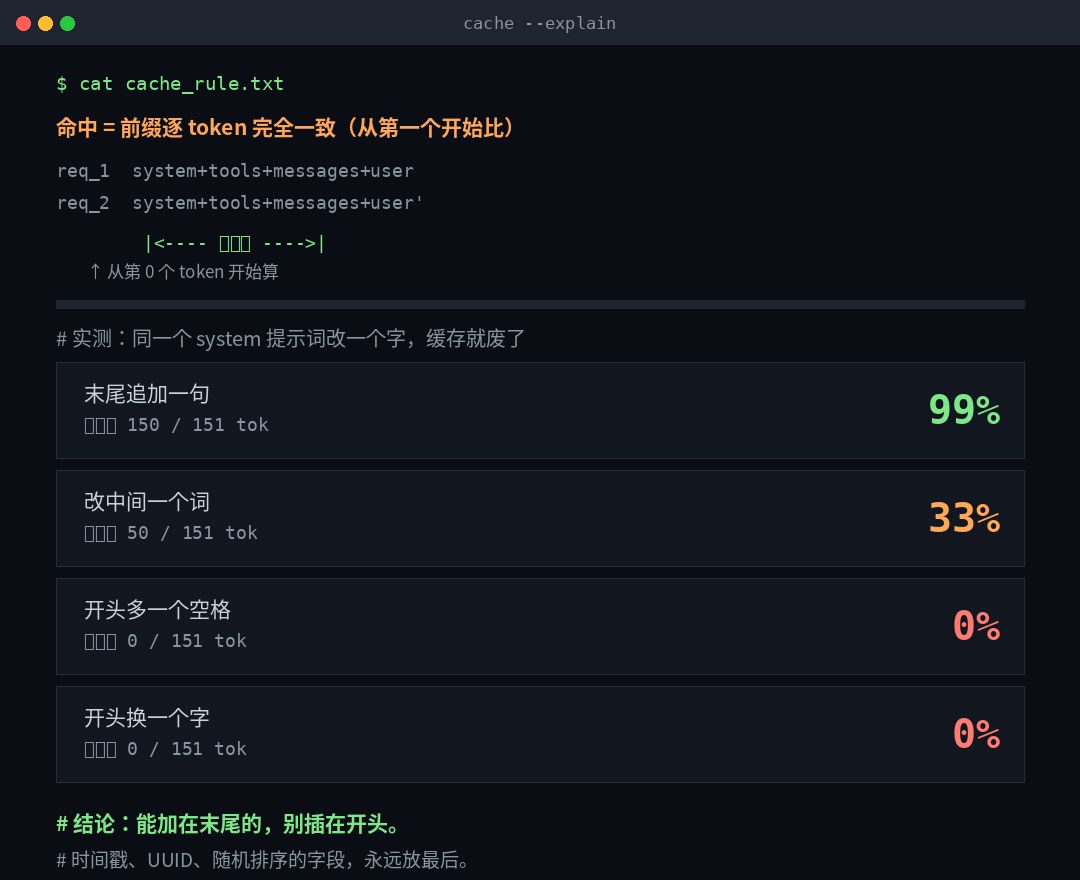
Warunki zabójstwa są trudniejsze, niż myślisz.
Kluczem jest słowo "przedrostek".Nie chodzi o to samo pytanie.
Zrobiłam eksperyment: wzięłam podpowiedź systemu tokena 151, zmieniłam ją na różne lokalizacje, i spojrzałam, jak bardzo może być ponownie wykorzystana.
| Zmiany | Prefiks wielokrotnego użytku | Procent |
|---|---|---|
| Dodaj zdanie na końcu | 150 / 151 | 99% |
| Zmień słowo w środku. | 50 / 151 | 33% |
| Jeszcze jedna przestrzeń na początku | 0 / 151 | 0% |
| Zacznij od słowa. | 0 / 151 | 0% |
Widzisz to "jeszcze jedno miejsce na początku"?Jedna przestrzeń, klatki, złomowane, przeliczane 151 żetonów w cenach oryginalnych.
To nie jest błąd, to zasada: Cache jest stanem akumulacji od początku, pierwszy znak zmienia się, a plecy są martwe.
Istnieje więc zasada, która może być zastosowana natychmiast:Stała zawartość jest z przodu, a zmienna w ostatnim.
Najczęstszym sposobem na rzucenie jest dodanie bieżącego czasu, żądanego ID, losowo posortowane pola na początku podpowiedzi systemowej. Za każdym razem to coś nowego.Pola te są albo przeniesione do końca, albo po prostu nie umieszczone.
Istnieje kilka progów łatwego zaniedbywania.
- Jest minimalna długość.Zbyt krótki przedrostek w ogóle nie daje bufora. OpenAI jest GPT- 5.6 i później 1,024 token; Anthropic segregated by model, zarówno w 512 / 1,024 / 2,048 / 4,096. Jeśli to nie wystarczy, to nie jest złe.Cisza., można zobaczyć tylko zwracając pole kwantowe.
- Jest czas na przetrwanie.Domyślny OpenAI 30 minut (do 12 godzin); Domyślny antropiczny 5 minut, do 1 godziny. I tym razem...Rozpocznij na życzenie, nie licząc od końca odpowiedzi -- jeśli odpowiedź działa w ciągu czterech minut, 5-minutowe gniazdo ma tylko jedno okno.
- Poczekamy na siebie.Czas wejścia do kabiny na pierwszą prośbęZacznij wracać.Więc jest dostępny. W tej samej sekundzie wysłano dziesięć wniosków, a wszystkie 10 zostało pominiętych.
- Zmieniłem modele, zmieniłem narzędzia, zmieniłem rozumowanie szczeliny.Przedrostek się zmienia i wskaźnik trafienia wynosi zero.
Jaka jest stawka?
Nie zgaduj. Obie rodziny dały im pole głośności:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antropiczny, specjalny intuicyjny:Obaj zwrócili 0, co oznacza, że nawet nie dotarli do schowka.- Zazwyczaj dlatego, że przedrostki nie są minimalne.
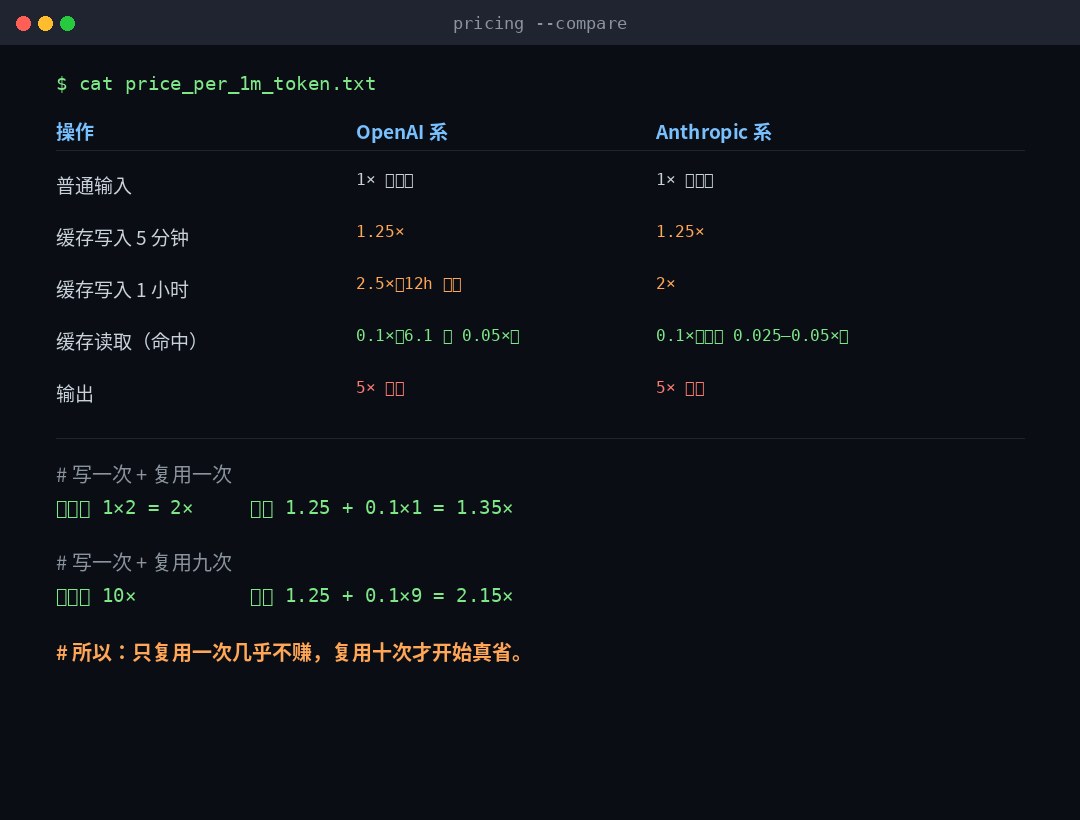
V. Struktura cen: pisanie więcej pieniędzy, aby mniej czytać
Cache nie jest za darmo, a wielu to przegapiło.Po raz pierwszy piszesz w pamięci podręcznej, musisz podnieść cenę, a następnie przeczytać, zanim dokonasz zniżki.
| Działanie | OpenAI | Antropina |
|---|---|---|
| Normalne wejście | 1x (wartość wyjściowa) | 1x (wartość wyjściowa) |
| Pisanie na kasku. Krótka szczelina | 1, 25 x (30 minut) | 1,25 x (5 minut) |
| Długoterminowe pisanie cache | 2, 5 x (12 godzin) | 2x (1 godzina) |
| Cache Read (Kategoria) | 0, 1 x(GPT- 6.1 wynosi 0,05 x) | 0, 1 x(Model częściowy 0,025 - 0,05 x) |
| Wyjście | Około 5x | Około 5x |
Weźmy normalną 0,1 x odczytu, 1,25 x pisać dwie książki:
- Napisz raz + ponowne użycie razCache 1, 25 + 0, 1 = 1,35 x; brak pamięci podręcznej to 1 + 1 = 2 x.Prowincja 32 procent.
- Napisz raz + powtórzyć dziewięć razy: Cache 1,25 + 0,9 = 2,15 x; nie cache to 10x.Prowincja 78 procent.
Oznacza to:W jednym przypadku pamięć podręczna była ledwo lub nawet nieznacznie utracona; tylko wtedy, gdy była powtarzana ponad dziesięć razy, oszczędności były prawdziwe.Te "jednorazowe tymczasowe rozmowy" to tylko problem.
Przy okazji:Pisanie cache jest oparte na segmencie tokena, a nie na numerze.Pęknięcie samo w sobie jest wolne, a pieniądze wydawane zależą od tego, ile naprawdę masz czasu.
VI. PUNISZTY, PUNISZTY SYSTEMU, min.
Te dwa terminy są często używane w sposób mieszany, ale różnią się pod względem kosztów i autorytetu.
| Nazwa | Angielski | Kto to napisał? | Priorytet | Przypisanie opłat |
|---|---|---|---|---|
| System Podpowiedź | Stympell / instytucje | Programista platformr lub aplikacji | Najwyższy | Wprowadź token |
| Wiadomość programisty | Nie jestem pewien, czy będę w stanie to zrobić. | Zastosuj programistę | Niższy (powyżej użytkowników) | Wprowadź token |
| Podpowiedź użytkownika | To nasza sprawa. | Użytkownik końcowy | Mniej niż dwa powyższe | Wprowadź token |
| Asystent wiadomości | Nie ma powodu, dla którego tu jesteś. | Modele generują siebie | Nie wiem. | Token wyjściowy |
Dwa proste punkty:
- Słowo "reklama" to wielkie słowo.Odnosi się ogólnie do wszystkich instrukcji tekstowych, które wysyłasz do modelu, a "systemowa wskazówka" jest tym, który jest najbardziej do przodu i najwyższy priorytet. Jeśli chodzi o "reklamy są zbyt długie", prawdziwym problemem jest często, że system jest zbyt długi, aby je zdefiniować.
- Rola jest również kosztowna.Każda wiadomość jest jedną warstwą
{"role":...,"content":...}A sama warstwa liczy się jako symbol. Kiedy będzie dużo wiadomości, będą tysiące rzeczy.
Dialog sprzątania działa, nie geniusz.Odetnij tę część historii.Nie wiem. Ale z kolei należy zauważyć, że po oczyszczeniu nie będą potrzebne historyczne przedrostki wcześniej prowadzonego dialogu.
Siedem czy siedem dołów, na które nadepnąłem, skopiuj wnioski.
- Użyj słowa "charakter" do oszacowania chińskiego budżetu.Źle. Chińczycy są blisko jednego słowa, a ty będziesz dwa razy niższy. Gotowe.
tiktokenOkreślając lub patrząc wstecz na użycie. - Pomyślałem, że oberwę, jeśli zadam podobne pytanie.Nie mogę. Musi być całkowicie spójny od pierwszego symbolu.
- Wstawia znacznik czasu na początku podpowiedzi systemowej.To najczęstszy zabójca. Przesuń się do końca.
- To tanie widzieć krótkie odpowiedzi.Proces myślenia modelu rozumowania jest kosztowany po cenie wyjściowej, odpowiedź 20 słów, opłata 900 token jest normalne.
- Kasa na jednorazowy dialog.Ponowne użycie zaoszczędziło tylko 32%, ale dodało warstwę złożoności i kosztów debugowania. Warto to zrobić przynajmniej trzy razy.
- Można odgadnąć szybkość trafienia bez patrzenia na pole pomiarowe.Dwa.
cached_tokens/cache_read_input_tokensWszyscy wrócili z czystym kodem. - Poprosił również o użycie pamięci podręcznej do zwiększenia prędkości.Cache będzie dostępny dopiero po rozpoczęciu pierwszej odpowiedzi, a prośby o tę samą sekundę są w dużej mierze pomijane.
VIII. Lista tego, co zostało zrobione
Możemy się dzisiaj zmienić.
- Zdefiniuj podpowiedzi i narzędzia systemoweWszystko, co się zmienia.Przenieś się na koniec wiadomości.
- Prasa narzędziowaStałe zamówienieZorganizować. Kolejność zmienia przedrostek, przedrostek zmienia.
- Pierwsza liczba: Wpisz liczbę żetonów w definicji narzędzia + systemu. Ponad 2000 jest warte optymalizacji.
To warte pół dnia.
- Rozmontuj podpowiedź systemu długowiecznego w "segmencie spójnym + zmiennym", z przerwą pamięci podręcznej na końcu stałego segmentu.
- Biegaj z prawdziwym korkiem. Nagranie.
cached_tokensProcent całkowitych nakładów. Mniej niż 30% wskazuje na problemy z projektowaniem prefiksu. - Naciśnij również stronę wyjściową: "tylko wyjście" nie jest dozwolone do wyjaśnienia, cena wyjściowa jest pięć razy wejście.
Nie rób tego.
- Nie pisz 9-30 napiwków do pamięci podręcznej.Cache to pieniądze, nie jasność.
- Nie dodawaj do skryptów one- off logiki caches, które są bardziej skomplikowane niż oszczędności.
- Nie zakłada się, że cache można stosować w różnych modelach.Modele przełączające zmieniają obudowy, bez trafień.
Nareszcie.
Słowa te są zabierane do końca i mówią tylko jedno:Model ładuje "ile czyta w" i "ile pisze", a cache jest jedynym mechanizmem, który może zdyskontować "czytaj".
Więc nie jest dokładnie tak piękna podpowiedź, prawda?Umieść stertę rzeczy, które nie zmieniają się za każdym razem. Chodźmy.Nie wiem.
Większość pieniędzy, których nie możesz zaoszczędzić, nie jest zbyt droga. Twój przedrostek zmienia się za każdym razem.
Następnym razem, gdy zobaczę nienormalny rachunek, nie wątp w wzrost cen modelu. cached_tokens Ta kolumna.To nie jest zero, decyduje czy płacisz za matematykę czy podwójnie.