
Enter, Output, Cache Life: Der Name auf der AI-Token-Rechnung.
Beginnen wir mit den Ergebnissen:Es gibt nur zwei Wörter in diesen Begriffen, die Sie wirklich mehr kosten: "Cacheft" und "Output" -Token.Der Rest sind ihre Notizen.
Ich wurde in zwei Monaten dreimal in Rechnung gestellt, und es ist dasselbe: Ich denke, ich spare Geld, und ich bezahle den vollen Preis für das gleiche Präfix. Hier können Sie mindestens eine Frage beantworten...Warum habe ich 8.000 Token auf der Rechnung, wenn ich nur ein Wort gesagt habe?
I. Zeichen. Warum ist Chinesisch teurer?
Token ist die kleinste Einheit für die Modelltextverarbeitung. Es ist kein Wort. Es ist kein Wort.Es ist ein Stück durch die Semantik geschnitten.Ich weiß es nicht. Im selben Satz kann sich die Anzahl der geschnittenen Blöcke von Modell zu Code unterscheiden.
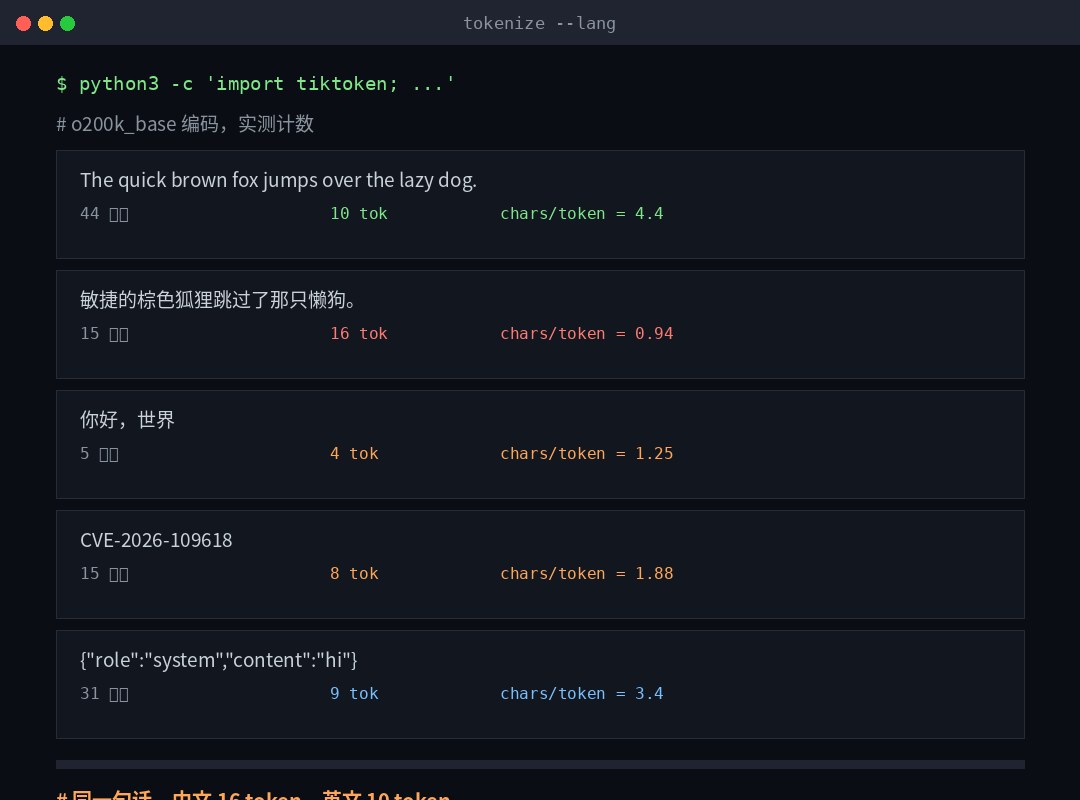
Ich nehme es. o200k_base Der Code maß tatsächlich mehrere Gruppen und der Unterschied war größer als erwartet:
| Text | Anzahl der Zeichen | Token-Nummer | Zeichen/Zeichen |
|---|---|---|---|
| Die schnelle braune Box springt über den faulen Hund. | 44 | 10 | 4.4 |
| Der schnelle braune Fuchs sprang über diesen faulen Hund. | 15 | 16 | 0.94 |
| Hallo Welt. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Sehen Sie das Problem.Im selben Satz, 10 Token in Englisch und 16 in Chinesisch.Über 4 Zeichen auf EnglischEin Wort, ein TokenIch weiß es nicht.
Dies ist für chinesische Benutzer sehr unfreundlich: Das "1 Token ≈ 4 Zeichen" ist eine englischsprachige Erfahrung.Sie werden mehr als die Hälfte davon auf Chinesisch unterschätzen.
Es gibt eine kontraintuitive:CVE-2026-109618 Diese Zahl, 15 Zeichen brennen 8 Token. Zahlen und Bindestriche werden sehr schlecht geschnitten.Es ist also viel teurer als es aussieht.
Zwei, ein Antrag, vier Absätze.
Als ich das erste Mal auf die Rechnung schaute, war es nicht teuer.Es ist nur ein Wort, aber 8.000 Token.Ich weiß es nicht. Dann wurde deutlich, dass mehr als Sie.
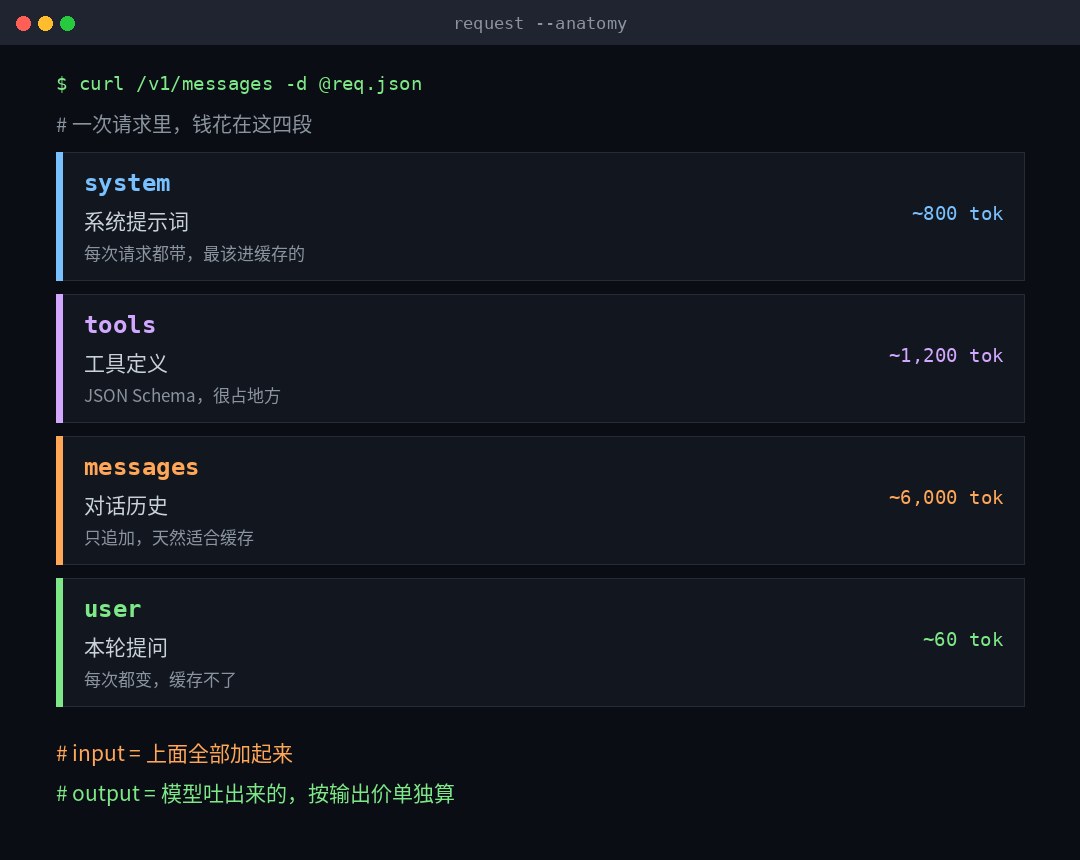
Die Eingabe einer Anfrage erfolgt in der Regel in vier Teilen:
| Absatz 3 | Englischer Name | Was ist das? | Wird sich das ändern? |
|---|---|---|---|
| Systemhinweis | System/Einschluss | Wer bist du, die Regeln, das Ausgabeformat? | Es ist im Grunde dasselbe. |
| Tool Definition | Ich glaube nicht. | Funktion JSON Schema und Beschreibung | Sehr selten. |
| Geschichte des Dialogs | Nachrichten / Geschichte | Jede Runde von Fragen und Antworten vor Ihnen, nehmen Sie sie alle. | Nur hinzufügen |
| Fragen für diese Runde | Es tut mir leid, Sir. | Das Ding, das du gerade angerufen hast. | Jedes Mal. |
Das erste Mal, dass ich Angst hatte, war es.Das Tool definiert die Menge von 1.200 TokenIch weiß es nicht. Eine Funktion mit Parameterbeschreibung, JSON Schema wird erweitert, um einen besonderen Platz einzunehmen. Du hast 20 Werkzeuge geschrieben, du könntest 2000 per Definition essen.Und Sie haben kein Wort in diesen Teil eingegeben, aber es ist immer aufgeladen.
Es gibt einen wichtigen Punkt dahinter:Die ersten drei Absätze sind "zusätzlich und nicht modifiziert" und der vierte Absatz ändert sich jedes Mal.Es ist kein Zufall. Es bestimmt, ob der Cache getroffen werden kann.
Drei: Input, Output und dieser im Output.
Das offizielle Kaliber dieser drei Beziehungen ist wie folgt:
- Eingeben von Token (Input / Policy Token)Alles, was Sie durchschicken, enthält die vier obigen Absätze.
- Output: Modelliert. Achtung ...Nicht nur den Text, den du gesehen hast.
- Token (Resonanz-Token)Das Argumentationsmodell ist das, was es denkt, bevor es die Antwort gibt. Du kannst nicht sehen, aber es...Zu ProduktionspreisenIch weiß es nicht.
Der dritte ist der wahre Grund für viele Menschen, ihre Rechnungen zu verdoppeln. Ich betreibe eine Art Job mit einem Theoriemodell, und ich sehe 20 Wörter in der Antwort, und die Rechnung ist mehr als 900.Dieses 880 unsichtbare Token ist alles drin.
Es ist also normal, einen Widerspruch zu haben:Je kürzer die Antwort, desto billiger desto weniger.
Der Outputpreis ist in der Regel etwa das Fünffache des Inputpreises (siehe Tabelle unten für jeden Haushalt). Dies erklärt ein Prinzip der Integrität:Es kann mit Input gelöst werden. Lass es nicht raus.Setzen Sie die Antwortvorlage, das Formatbeispiel, in den Systemhinweis (niedriger), so dass es sich nicht so organisiert, dass es teuer ist.
Cacheline und unattraktiv: Dies ist der Abschnitt des gesamten Textes, an den man sich erinnern sollte
Was sind sie?
Modelle werden beim Lesen als Zwischenmodelle gezählt. Dieser Teil ist der teuerste.
Prompt Cache ist ein präfixierter Zustand.Das nächste Mal, wenn wir das gleiche Präfix treffen, werden wir es direkt verwenden und nicht mehr neu berechnen.
Es gab also zwei Wörter:
- Cache-HitDieses Präfix wurde im Cache gefunden. Dieser Teil wurde betreten und gedrückt.Der Rabatt.Gebühren.
- Cache Miss: Ich kann es nicht finden. Berechnen Sie einfach den Preis neu.
Die Bedingungen des Treffers sind härter als Sie denken.
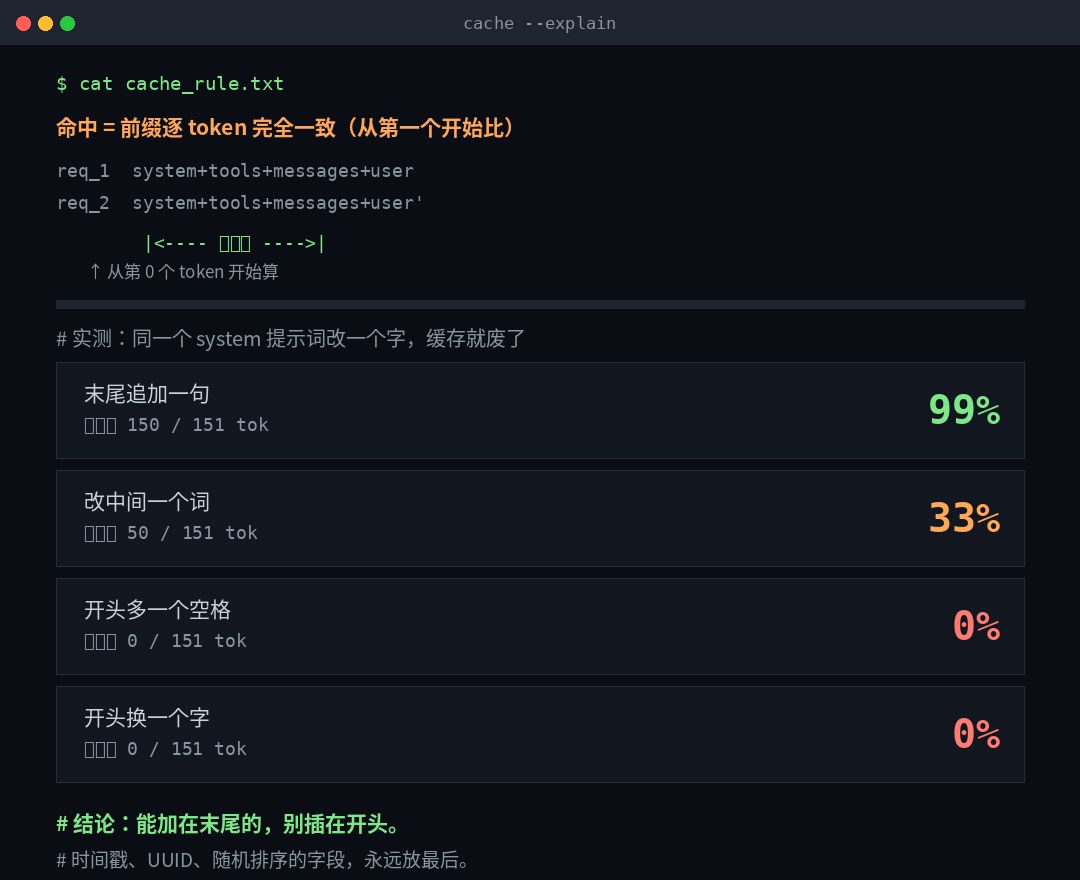
Der Schlüssel ist das Wort "Präfix".Es geht nicht darum, die gleiche Frage zu stellen.
Ich machte ein Experiment: Ich nahm einen 151-Token-System-Hinweis, änderte ihn an verschiedene Orte und schaute, wie viel er wiederverwendet werden konnte.
| Änderungen | Wiederverwendbares Präfix | Prozentsatz |
|---|---|---|
| Einen Satz am Ende hinzufügen | 150 / 151 | 99% |
| Ändern Sie das Wort in der Mitte. | 50 / 151 | 33% |
| Noch ein Platz am Anfang | 0 / 151 | 0% |
| Beginnen Sie mit einem Wort. | 0 / 151 | 0% |
Sehen Sie das "ein weiterer Raum am Anfang"?Ein Platz, Caches, verschrottet, neu berechnet 151 Token zu Originalpreisen.
Es ist kein Bug, es ist das Prinzip: Cache ist der Zustand der Akkumulation von Anfang an, das erste Token ändert sich und der Rücken ist tot.
Es gibt also eine Regel, die sofort angewendet werden kann:Der konstante Inhalt ist vorne und der variable Inhalt zuletzt.
Der häufigste Weg zum Flip ist das Einfügen der aktuellen Zeit, angeforderte ID, zufällig sortierte Felder am Anfang des Systemhinweises. Das ist jedes Mal wie ein neuer Cache.Diese Felder werden entweder bis zum Ende verschoben oder einfach nicht eingefügt.
Es gibt ein paar leicht zu vernachlässigende Schwellenwerte.
- Es gibt eine Mindestlänge.Ein zu kurzes Präfix gibt den Cache überhaupt nicht. OpenAI ist GPT-5.6 und später 1.024 Token; Anthropic ist nach Modell getrennt, beide in 512 / 1.024 / 2.048 / 4.096. Wenn es nicht lang genug ist, ist es nicht falsch.Schweigen., können Sie nur sehen, indem Sie das Quantenfeld zurückgeben.
- Es gibt Zeit zum Überleben.OpenAI Standard 30 Minuten (bis zu 12 Stunden); Anthropischer Standard 5 Minuten, bis zu 1 Stunde. Und dieses Mal...Beginnen Sie auf Anfrage, nicht ab dem Ende der Antwort zählen - wenn die Antwort in vier Minuten läuft, hat der 5-Minuten-Slot nur ein Minutenfenster.
- Wir warten aufeinander.Cache-Eintrag wartet auf erste AnfrageBeginn der RückkehrDann ist es verfügbar. Zehn Anfragen wurden in derselben Sekunde gesendet, und alle 10 wurden verpasst.
- Geänderte Modelle, veränderte Werkzeuge, veränderte Argumentations-Slots.Das Präfix ändert sich und die Trefferrate ist Null.
Was ist die Trefferquote?
Raten Sie nicht. Beide Familien gaben ihnen ein Volumenfeld:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Anthropisch, das besondere Intuitive:Beide gaben 0 zurück, was bedeutet, dass sie nicht einmal den Cache erreicht haben.Normalerweise, weil Präfixe nicht minimal sind.
V. Preisstruktur: Mehr Geld schreiben, um weniger zu lesen
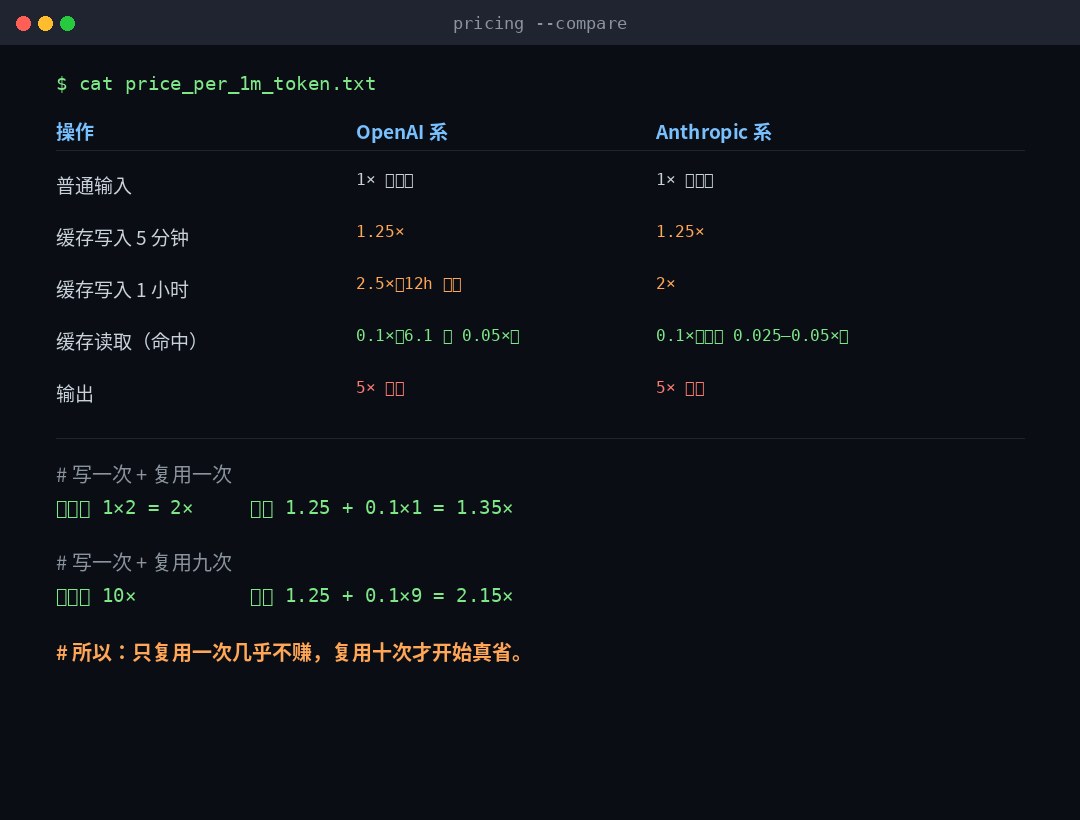
Cache ist nicht kostenlos, und viele haben es verpasst.Das erste Mal, wenn Sie in den Cache schreiben, müssen Sie den Preis erhöhen; dann lesen Sie es, bevor Sie einen Rabatt machen.
| Betrieb | OpenAI | Anthropisch |
|---|---|---|
| Normale Eingangsleistung | 1x (Baseline) | 1x (Baseline) |
| Cache schreiben. Short Slot | 1,25 x (30 Minuten) | 1,25 x (5 Minuten) |
| Cache Schreiben langfristig | 2,5 x (12 Stunden) | 2x (1 Stunde) |
| Cache Read (Kategorie) | 0,1 x(GPT-6.1 ist 0,05 x) | 0,1 x(Teilmodell 0.025 – 0.05 x) |
| Output | Über 5x | Über 5x |
Nehmen Sie die normale 0,1 x gelesen, 1,25 x schreiben zwei Bücher:
- Einmal schreiben + Einmal wiederverwendenCache 1,25 + 0,1 = 1,35 x;no Cache ist 1 + 1 = 2 x.Provinz 32 Prozent.
- Einmal schreiben + Neunmal wiederholenCache 1,25 + 0,9 = 2,15 x;not Cache ist 10x.Provinz 78 Prozent.
Dies bedeutet:In einem Fall war der Cache kaum oder sogar leicht verloren; Nur wenn er mehr als zehn Mal wiederholt wurde, waren die Einsparungen real.Diese "einmaligen temporären Gespräche" sind nur ein Problem.
Übrigens:Das Cache-Schreiben basiert auf dem Token-Segment, nicht auf der Zahl.Der Haltepunkt selbst ist frei und das ausgegebene Geld hängt davon ab, wie lange Sie tatsächlich haben.
VI. BESTIMMUNGEN, SYSTEMBESTIMMUNGEN, min.
Die beiden Begriffe werden oft vermischt verwendet, aber sie unterscheiden sich in Bezug auf Kosten und Autorität.
| Name | Englisch | Wer hat es geschrieben? | Priorität | Gebührenzuweisung |
|---|---|---|---|---|
| Systemhinweis | Stymprompt / Institutionen | Platformer oder Anwendungsentwickler | Höchster Wert | Enter-Token |
| Entwicklermeldung | Ich bin mir nicht sicher, ob ich das schaffen werde. | Apply Entwickler | Niedriger (über Benutzer) | Enter-Token |
| Benutzerhinweis | Es ist unser Geschäft. | Endverbraucher | Weniger als die beiden oben | Enter-Token |
| Assistentin | Es gibt keinen Grund, warum du hier bist. | Modelle erzeugen sich selbst | Ich weiß es nicht. | Ausgabe-Token |
Zwei einfache Punkte:
- Das Wort "Werbung" ist ein großes Wort.Es bezieht sich im Allgemeinen auf alle Textanweisungen, die Sie an das Modell senden, und der "systemale Hinweis" ist derjenige, der die vorderste und höchste Priorität hat. Wenn es um "Werbung ist zu lang" geht, ist das eigentliche Problem oft, dass das System zu lang ist, um sie zu definieren.
- Die Rolle ist auch teuer.Jede Nachricht ist eine Schicht
{"role":...,"content":...}Und die Schicht selbst zählt als Token. Wenn es viele Nachrichten gibt, werden es Tausende von Dingen sein.
Der Säuberungsdialog funktioniert also - nicht genial, ja.Schneiden Sie diesen Teil der Geschichte ab.Ich weiß es nicht. Aber im Gegenzug ist es wichtig zu beachten, dass nach der Klärung die historischen Präfixe des zuvor geführten Dialogs nicht benötigt werden.
Sieben oder sieben der Gruben, auf die ich getreten bin, kopieren die Schlussfolgerungen.
- Verwenden Sie das Wort "Charakter", um das chinesische Budget zu schätzen.Falsch. Chinesisch ist fast ein Wort, und Sie werden doppelt so kurz sein. Es ist fertig.
tiktokenDefinieren oder Rückblick auf die Nutzung. - Ich dachte, ich würde getroffen, wenn ich eine ähnliche Frage stellen würde.Kann nicht. Muss vom ersten Token an vollständig konsistent sein.
- Legt einen Zeitstempel am Anfang des Systemhinweises ein.Dies ist der häufigste Cache-Killer. Gehen Sie zum Ende.
- Es ist billig, kurze Antworten zu sehen.Der Denkprozess des Argumentationsmodells wird zum Ausgabepreis berechnet, 20 Wörter beantwortet, 900 Token berechnet ist normal.
- Cache für einmaligen Dialog.Die Wiederverwendung hat nur 32 Prozent eingespart, aber eine Ebene der Komplexität und der Debugging-Kosten hinzugefügt. Es lohnt sich mindestens dreimal.
- Sie können die Trefferrate erraten, ohne ein Messfeld zu betrachten.Zwei.
cached_tokens/cache_read_input_tokensSie alle kehrten in klarem Code zurück. - Er bat auch, den Cache zu verwenden, um die Geschwindigkeit zu erhöhen.Der Cache wird nicht verfügbar sein, bis die erste Antwort beginnt, und Anfragen für die gleiche Sekunde werden weitgehend verpasst.
VIII. Eine Liste dessen, was getan wurde
Wir können uns heute ändern.
- Definieren Sie Systemtipps und ToolsAlles, was sich ändert.Gehen Sie zum Ende der Nachricht.
- WerkzeugpresseFixed OrderArrangieren. Die Reihenfolge ändert das Präfix, das Präfix ändert sich.
- Erste Zählung: Geben Sie die Anzahl der Token im System + Tool-Definition ein. Mehr als 2.000 sind es wert, optimiert zu werden.
Es ist einen halben Tag wert.
- Zerlegen Sie einen Long-System-Hinweis in ein "konsistentes + variables Segment" mit einem Cache-Bruch am Ende des konstanten Segments.
- Laufen Sie mit echtem Verkehr herum. Aufzeichnung.
cached_tokensProzentsatz der gesamten Inputs. Weniger als 30% deuten auf Präfix-Designprobleme hin. - Drücken Sie auch die Ausgabeseite: Der "Output only" darf nicht erklärt werden, der Ausgabepreis ist fünfmal so hoch wie der Input.
Tun Sie es nicht.
- Schreiben Sie keinen neun-dreißig-Tipp für den Cache.Cache ist Geld, nicht Klarheit.
- Fügen Sie nicht zu einmaligen Skripts die Logik von Caches hinzu, die komplizierter sind als Einsparungen.
- Es wird nicht angenommen, dass Caches über verschiedene Modelle hinweg verwendet werden können.Das Wechseln von Modellen verändert Caches mit null Treffern.
Schließlich.
Diese Worte sind bis zum Ende genommen, und sie sagen nur eines:Das Modell lädt "wie viel es liest" und "wie viel es schreibt", und der Cache ist der einzige Mechanismus, der "lesen" diskontieren kann.
Es ist also nicht genau, wie schön der Hinweis ist, oder?Setzen Sie diesen Haufen von Dingen, die sich nicht jedes Mal ändern. Lass uns gehen.Ich weiß es nicht.
Das meiste Geld, das Sie nicht sparen können, ist nicht zu teuer. Ihr Präfix ändert sich jedes Mal.
Ich werde Sie mit der praktischsten Aktion verlassen: Das nächste Mal, wenn ich eine abnormale Rechnung sehe, zweifle nicht an der Preiserhöhung des Modells. cached_tokens Diese Spalte.Es ist nicht Null, entscheidet, ob Sie für Mathematik oder doppelt bezahlen.