
Skriv inn, ut, cache levetid: navnet på AI-tokenregningen.
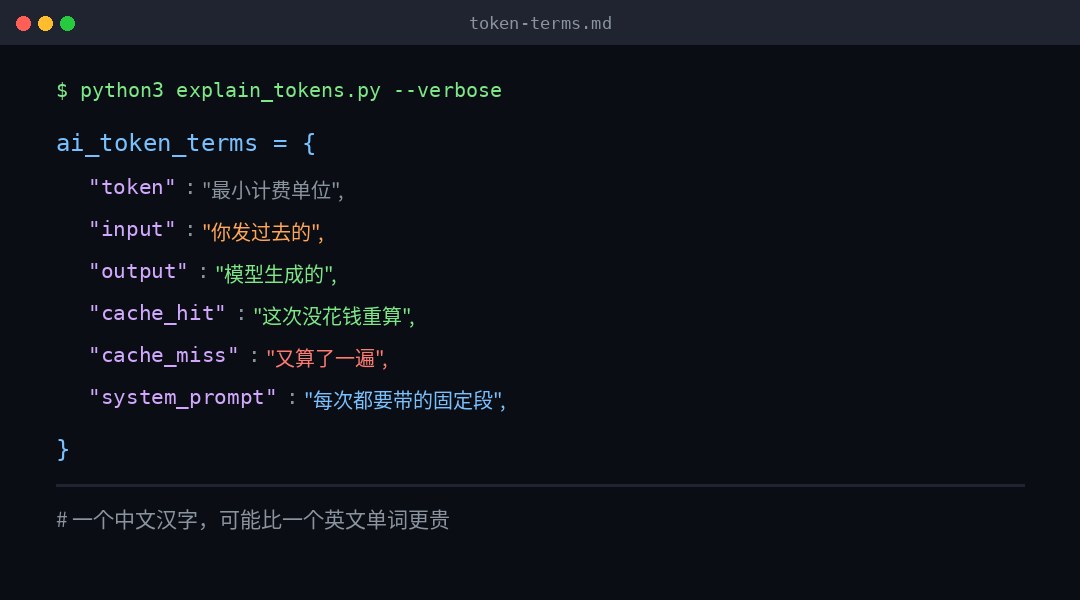
La oss begynne med resultatene:Det er bare to ord i disse termene som virkelig koster deg mer: - Cacheft - og -utgangs - token.Resten er deres notater.
Jeg har blitt fakturert tre ganger på to måneder, og det er det samme: Jeg tror jeg sparer penger, og jeg betaler hele prisen for det samme prefikset. Det er her du kan svare på minst ett spørsmål...Hvorfor har jeg 8000 tegn på regningen når jeg bare har sagt ett ord?
I. Token. Hvorfor er kinesisk dyrere?
Token er den minste enheten for modelltekstbehandling. Det er ikke et ord. Det er ikke et ord.Det er et stykke kuttet av semantikeren.Jeg vet ikke. I samme setning kan antall blokker skjære fra modell til kode.
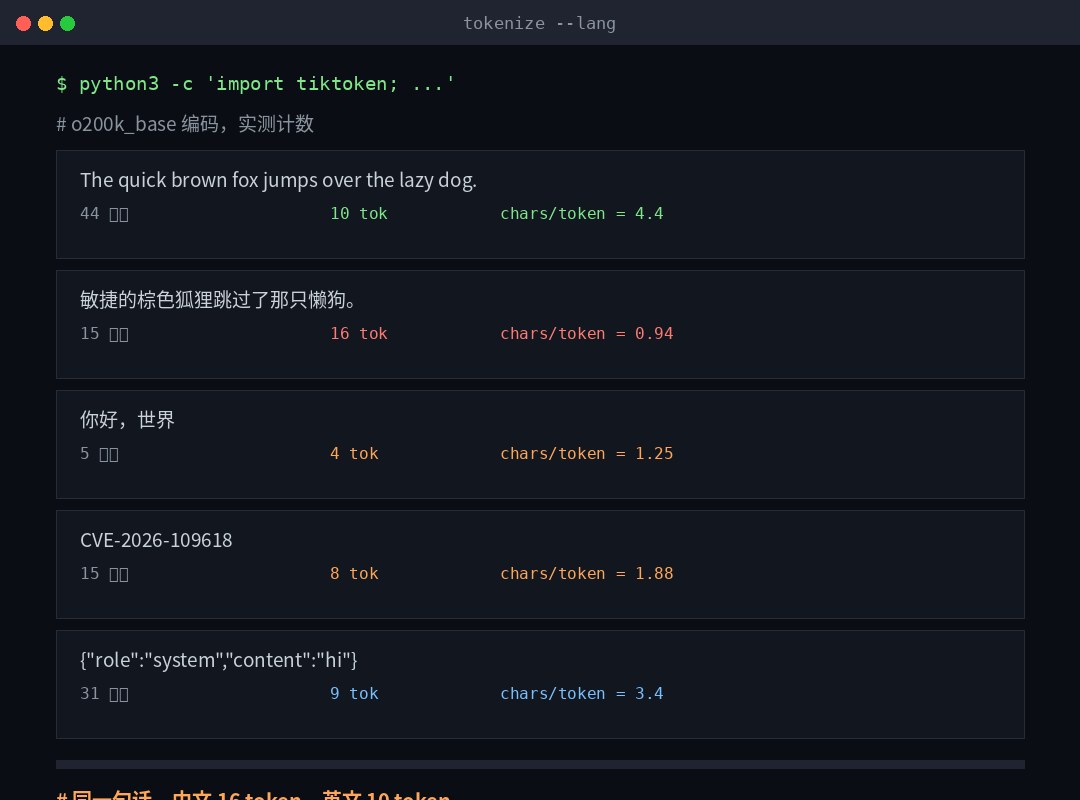
Jeg tar den. o200k_base Koden målte faktisk flere grupper og forskjellen var større enn forventet:
| Tekst | Antall tegn | Token nummer | Tegn/tegn |
|---|---|---|---|
| Den raske brune boksen hopper over den late hunden. | 44 | 10 | 4.4 |
| Den raske brune reven hoppet over den late hunden. | 15 | 16 | 0.94 |
| Hei, verden. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Se problemet.I samme setning, 10 tokens på engelsk og 16 på kinesisk.Om 4 tegn på engelskEtt ord, ett tegnJeg vet ikke.
Dette er svært uvennlig for kinesiske brukere: den "1 token ≈4-karakteren" er en engelskspråklig opplevelse.Du undervurderer mer enn halvparten av det på kinesisk.
Det er en kontraintuitiv:CVE-2026-109618 Dette tallet, 15 tegn brenner 8 tokens. Tal og bindestrek er kuttet veldig dårlig.Det er mye dyrere enn det ser ut til.
To, én forespørsel, fire avsnitt.
Første gang jeg så på regningen var det ikke dyrt.Det er bare ett ord, men 8 000 tegn.Jeg vet ikke. Da ble det klart at mer enn du gjorde.
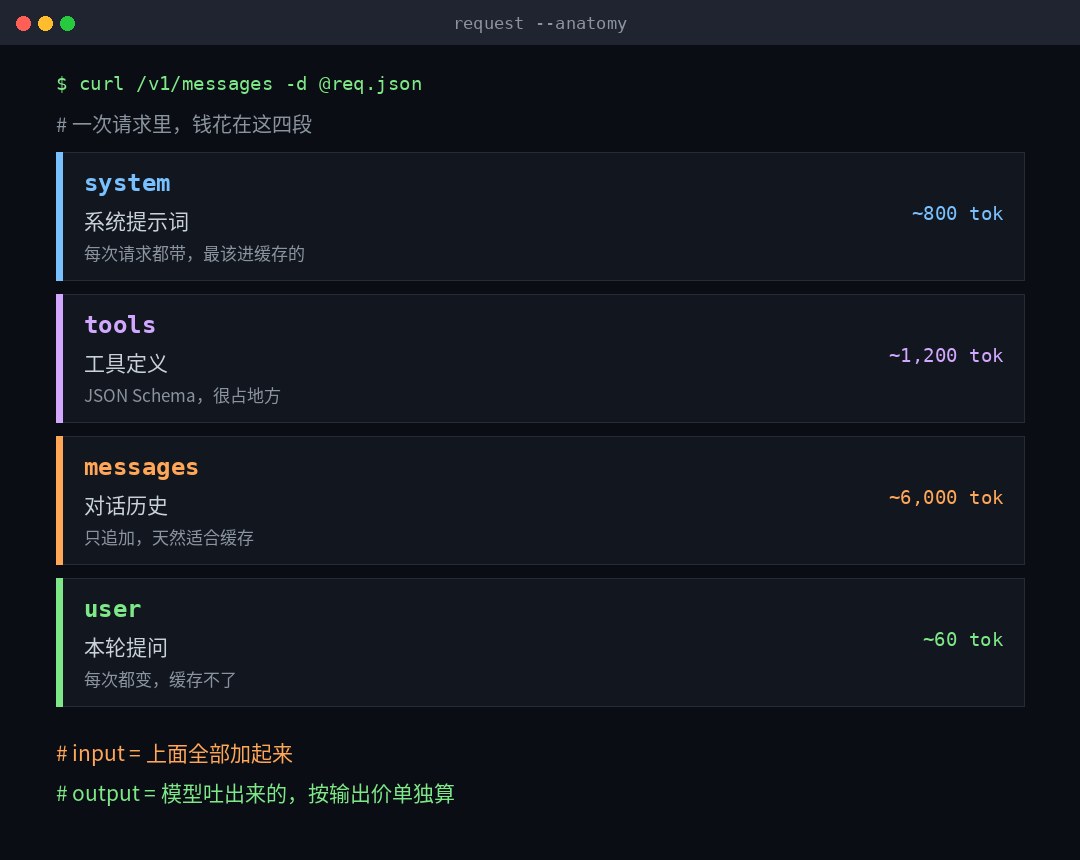
Inngangen fra en forespørsel gjøres vanligvis i fire stykker:
| Avsnitt | Engelsk navn | Hva er det? | Vil det endre seg? |
|---|---|---|---|
| Systemhint | System/inkludering | Hvem er du, reglene, utgangsformatet? | Det er i utgangspunktet det samme. |
| Verktøydefinisjon | Jeg tror ikke det. | Funksjon JSON skjema og beskrivelse | Svært sjelden. |
| Dialoghistorie | Meldinger / historie | Hver runde av spørsmål og svar før deg, ta dem alle. | Legg til kun |
| Spørsmål til denne runden | Jeg beklager, sir. | Tingen du nettopp ringte. | Hver gang. |
Første gang jeg var redd var det.Verktøyet definerer mengden av 1200 polletterJeg vet ikke. En funksjon med parameterbeskrivelse utvider JSON Schema seg til å skje spesielt. Du skrev 20 verktøy, du kan spise 2.000 per definisjon.Og du skrev ikke et ord i denne delen, men det er alltid tiltalt.
Det er et nøkkelpunkt bak det:De første tre avsnittene er \"tillegg og ikke-modifisert\" og det fjerde avsnittet endres hver gang.Det er ikke en tilfeldighet. Det avgjør om cache kan treffes.
Tre: inngang, utgang og den i utgangen.
Den offisielle kaliberen i disse tre relasjoner er som følger:
- Enter token (input / police tokens)Alt du sender gjennom inneholder de fire avsnittene ovenfor.
- UtgangModellert. Oppmerksomhet...Ikke bare teksten du så.
- Token (resonans)Begrunnelsesmodellen er det den tror før den gir svaret. Du kan ikke se, men det...Til utgangspriserJeg vet ikke.
Den tredje er den virkelige grunnen til at mange mennesker fordoble sine regninger. Jeg driver en slags jobb med en teorimodell, og jeg ser 20 ord i svaret, og regningen er mer enn 900.Den 880 usynlige polletten, den er der.
Så det er normalt å ha en motsigelse:Jo kortere svaret er jo billigere jo mindre.
Utgangsprisen er vanligvis rundt fem ganger inngangsprisen (se tabellen nedenfor for hver husholdning). Dette forklarer et prinsipp om integritet:Det kan løses med input. Ikke la det ut.Legg svarmalen, formateksemplet, i systemets hint (lavere), slik at det ikke organiserer seg på en slik måte at det er dyrt.
Cacheline og uattraktiv: dette er delen av hele teksten som bør huskes
Hva er de?
Modeller regnes som mellomliggende når de leses. Denne delen er den dyreste.
Bring cache er en prefiksert tilstand.Neste gang vi møter samme prefiks, vil vi bruke det direkte og ikke lenger reberegne.
Så det var to ord:
- Cache hitDette prefikset ble funnet i cache. Denne delen kom inn og presset.Rabatt.Priser.
- Cache miss- Jeg finner det ikke. Bare revurder prisen.
Betingelsene er tøffere enn du tror.
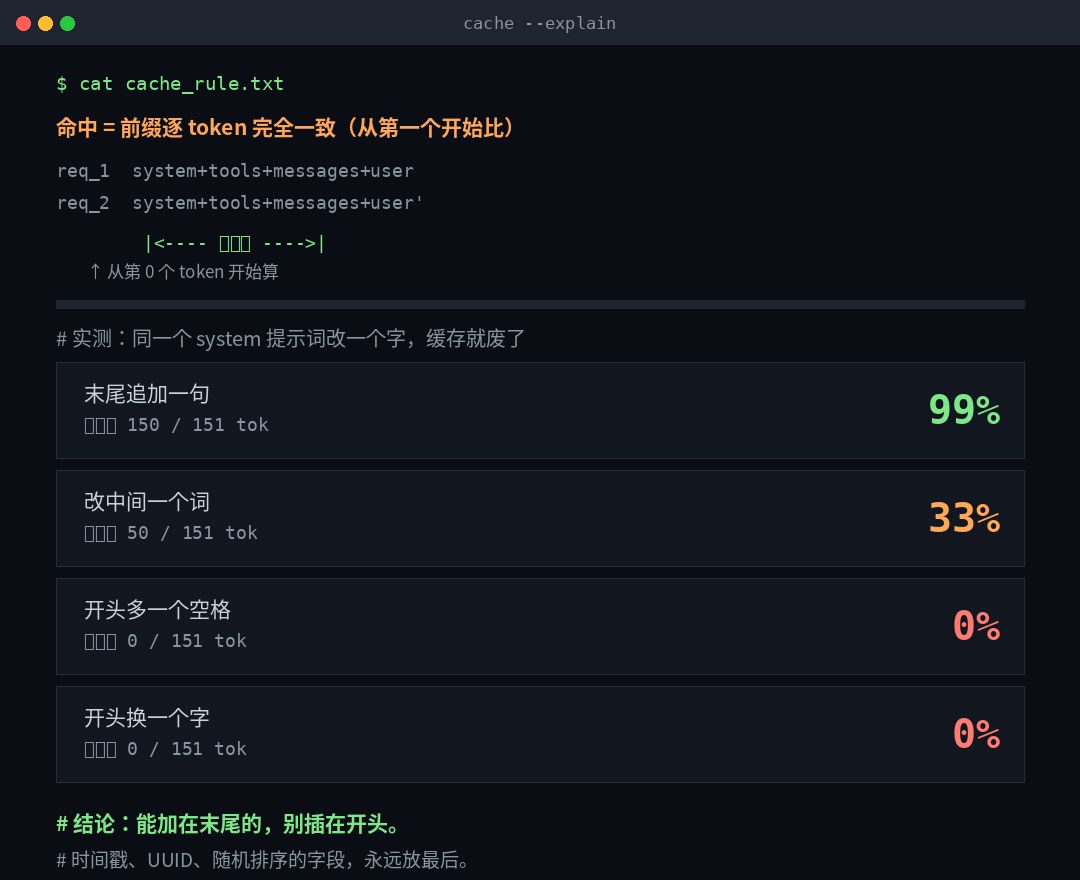
Nøkkelen er ordet " prefixDet handler ikke om å stille det samme spørsmålet.
Jeg gjorde et eksperiment: Jeg tok en 151 token system hint, endret det til ulike steder, og så på hvor mye det kunne gjenbrukes.
| Endringer | Reusable prefiks | Prosent |
|---|---|---|
| Legg til en setning i slutten | 150 / 151 | 99% |
| Endre ordet i midten. | 50 / 151 | 33% |
| En plass til i begynnelsen | 0 / 151 | 0% |
| Begynn med et ord. | 0 / 151 | 0% |
Se det " en plass til i begynnelsen"?Ett rom, caches, skrapet, reberegnet 151 tokens til opprinnelige priser.
Det er ikke en feil, det er prinsippet: Cache er tilstanden for akkumulering fra begynnelsen, den første token endringer, og ryggen er alle døde.
Så det finnes en regel som kan anvendes umiddelbart:Det konstante innholdet er foran og variabelt innhold i det siste.
Den vanligste måten å snu på er å sette inn gjeldende tid, etterspurt ID, tilfeldig sortert felt i begynnelsen av systemhinten. Det er som en ny cache hver gang.Disse feltene blir enten flyttet til slutten eller ikke satt i.
Det er et par enkle å fornærme terskelverdier.
- Det er en minste lengde.For kort et prefiks gir ikke cache i det hele tatt. OpenAI er GPT-5.6 og senere 1.024 token; Antropic er segregert etter modell, både i 512 / 1.024 / 2,048 / 4,096. Hvis det ikke er lenge nok, er det ikke galt.Stillhet.Du kan bare se ved å returnere kvantefeltet.
- Det er på tide å overleve.OpenAI standard 30 minutter (opp til 12 timer); Antropisk standard 5 minutter, opp til 1 time. Og denne gangen...Start på forespørsel, ikke teller fra slutten av svaret - hvis svaret kjører på fire minutter, 5-minutters spilleautomaten har bare ett minutts vindu.
- Vi venter på hverandre.Cache Entry venter på første forespørselStart returSå er det tilgjengelig. Ti forespørsler ble sendt i samme sekund, og alle ti ble savnet.
- Endrede modeller, endret verktøy, endret resonnement slots.Prefikset endres og hitraten er null.
Hva er hit rate?
Ikke gjett. Begge familier ga dem et volumfelt:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antropic, den spesielle intuitive:Begge returnerte 0, noe som betyr at de ikke engang nådde cache.- Vanligvis fordi prefiks ikke er minimale.
V. Prisstruktur: å skrive mer penger for å lese mindre
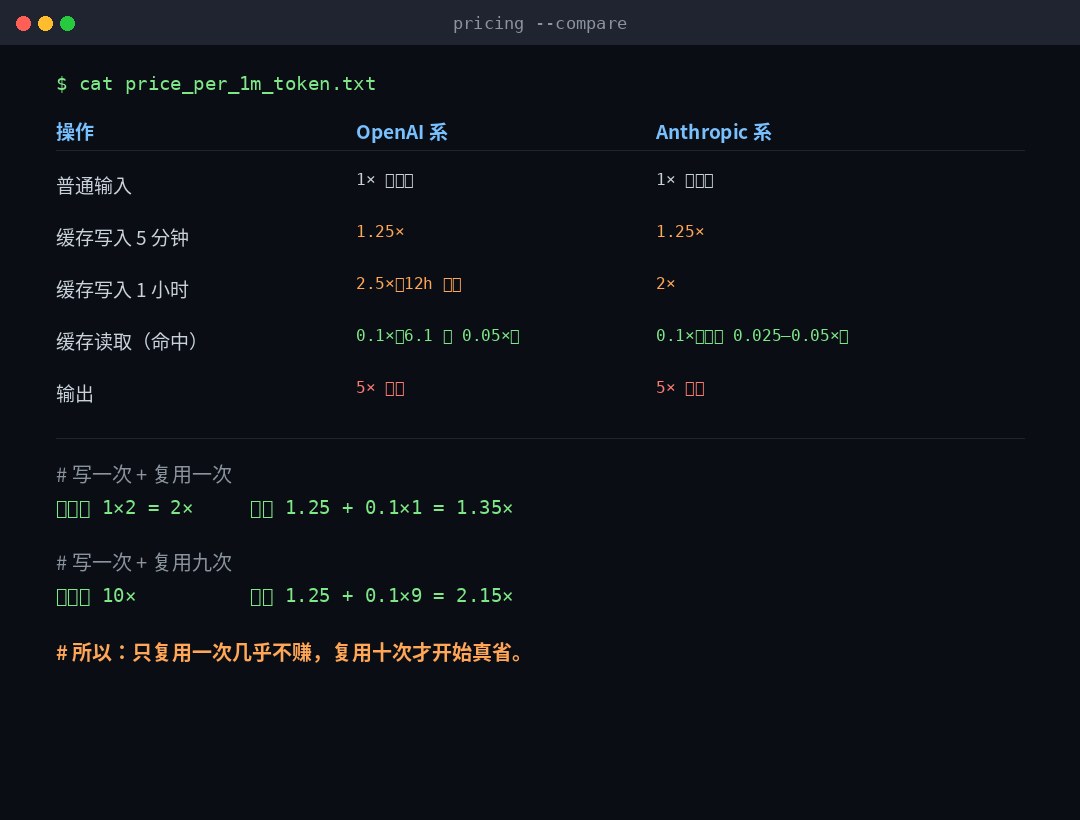
Cache er ikke gratis, og mange har savnet det.Første gang du skriver i cache, må du heve prisen; så lese den før du gjør en rabatt.
| Operasjon | OpenAI | Antropic |
|---|---|---|
| Normal inngang | 1x (baseline) | 1x (baseline) |
| Cacheskriving. Kort spor | 1.25 x (30 minutter) | 1.25 x (5 minutter) |
| Cacheskriving på lang sikt | 2,5 x (12 timer) | 2x (1 time) |
| Cache Les (kategori) | 0.1 x(GPT-6.1 er 0,05 x) | 0.1 x(delmodell 0,025 – 0,05 x) |
| Utgang | Om 5x | Om 5x |
Ta den normale 0.1 x lese, 1.25 x skrive to bøker:
- Skriv en gang + gjenbruk en gangCache 1.25 + 0.1 = 1.35 xIngen cache er 1 + 1 = 2 x.Provinsen 32 prosent.
- Skriv én gang + gjenta ni ganger: Cache 1,25 + 0,9 = 2.15 xIkke cache er 10x.Provinsen 78 prosent.
Dette betyr:I ett tilfelle var cache knapt eller til og med litt tapt; det var bare da det ble gjentatt mer enn ti ganger at sparene var ekte.De - en gangs midlertidige samtaler - er bare et problem.
Forresten:Cache-skriving er basert på tokensegmentet, ikke på tallet.Breakpoint i seg selv er gratis, og pengene brukt avhenger av hvor lenge du faktisk har.
VI. PUNIKASJONER, Systemstraffer, min
De to begrepene er ofte brukt i termingled, men de er forskjellige når det gjelder kostnader og autoritet.
| Navn | Norsk | Hvem skrev det? | Prioritet | Avgift tilskrivning |
|---|---|---|---|---|
| Systemhint | Stymprompt / institusjoner | Plattformr eller programutvikler | Høyeste | Angi token |
| Utviklermelding | Jeg er ikke sikker på at jeg kan gjøre det. | Bruk utvikler | Lavere (overbrukere) | Angi token |
| Brukerhint | Det er vår sak. | Sluttbruker | Mindre enn de to ovenfor | Angi token |
| Assisterende melding | Det er ingen grunn til at du er her. | Modeller genererer seg selv | Jeg vet ikke. | Utgangstoken |
To enkle poeng:
- Ordet " reklame" er et stort ord.Det refererer generelt til alle tekstinstruksjonene du sender til modellen, og den "systemale antydningen" er den som er den mest fremover og høyeste prioritet. Når det gjelder - reklame er for lang - er det virkelige problemet ofte at systemet er for lang til å definere dem.
- Rollen er også dyr.Hvert budskap er ett lag
{"role":...,"content":...}Og laget i seg selv teller som tegn. Når det er mye budskap, vil det være tusenvis av ting.
Så rengjøringsdialogen fungerer - ikke geni, ja.Klipp den delen av historien.Jeg vet ikke. Men i sin tur er det viktig å bemerke at etter å ha ryddet opp, vil de historiske prefiksene i den tidligere holdt dialog ikke være nødvendig.
7 eller 7 av gropene jeg gikk på, kopiere konklusjonene.
- Bruk ordet "tegner til å anslå det kinesiske budsjettet.Feil. Kinesisk er nær ett ord, og du vil være dobbelt så kort. Den er klar.
tiktokenDefining, eller se tilbake på bruk. - Jeg trodde jeg skulle bli truffet hvis jeg stilte et lignende spørsmål.Kan ikke. Må være helt konsekvent fra det første pollettet.
- Setter inn et tidsmerke i begynnelsen av systemets hint.Dette er den vanligste cache-morderen. Gå til slutten.
- Det er billig å se korte svar.Resonnementmodellens tenkningsprosessen koster til utgangspris, svarer 20 ord, ladning 900 token er normal.
- Cache for dialog én gang.Re-bruk sparte bare 32 prosent, men la til et lag av kompleksitets- og feilsøkingskostnader. Det er verdt det minst tre ganger.
- Du kan gjette rytmen uten å se på et målefelt.To.
cached_tokens/cache_read_input_tokensAlle kom tilbake i klar kode. - Han bad også om å bruke cache til å øke hastigheten.Cache vil ikke være tilgjengelig før den første responsen begynner, og forespørsler om samme sekund er i stor grad savnet.
VIII. En liste over hva som er gjort
Vi kan endre oss i dag.
- Definer systemtips og verktøyAlt som forandrer seg.Flytt til slutten av meldingen.
- VerktøypresseFast bestillingArrangere. Ordenenen endrer prefikset, prefikset endres.
- Første tall: Skriv ut antall polletter i systemet + verktøydefinisjon. Mer enn 2 000 er verdt å optimalisere.
Det er verdt en halv dag.
- Demontering av et langt system-hint i et "konsistent + variabelt segment " med en cache-pausepause i slutten av det konstante segmentet.
- Kjør rundt med ekte trafikk. Record.
cached_tokensProsentdel av totale innganger. Mindre enn 30 % indikerer prefiksdesignproblemer. - Trykk også på utgangssiden: -utgangspunktet kun - er ikke tillatt å forklare, utgangsprisen er fem ganger inngangen.
Ikke gjør det.
- Ikke skriv en nitti tip til cache.Cache er penger, ikke klarhet.
- Ikke legg til i one-off skript logikken til caches, som er mer komplisert enn besparelser.
- Det er ikke antatt at cache kan brukes på tvers av forskjellige modeller.Bytting modeller endrer cache, med null treff.
Endelig.
Disse ordene er tatt til slutt, og de sier bare én ting:Modellen koster " hvor mye den leser i" og " hvor mye den skriver" og cache er den eneste mekanismen som kan rabattere " lese."
Så det er ikke akkurat hvor vakkert hintet er.Sett den haugen som ikke endres hver gang. Kom igjen.Jeg vet ikke.
De fleste penger du ikke kan spare er ikke for dyrt. Prefiksen endres hver gang.
Jeg vil forlate deg med den mest praktiske handlingen: neste gang jeg ser en unormal regning, ikke tvil om modellens prisøkning. cached_tokens Den kolonnen.Det er ikke null, bestemmer om du betaler for matematikk eller dobbel.