
Ange, output, cache livet: namnet på AI-tokenräkningen.
Låt oss börja med resultatet:Det finns bara två ord i dessa termer som verkligen kostar dig mer: "Cacheft" och "output" token.Resten är deras anteckningar.
Jag har fakturerats tre gånger om två månader, och det är samma sak: Jag tror att jag sparar pengar, och jag betalar hela priset för samma prefix. Detta är den där du kan svara på minst en fråga...Varför har jag 8 000 tokens på räkningen när jag bara har sagt ett ord?
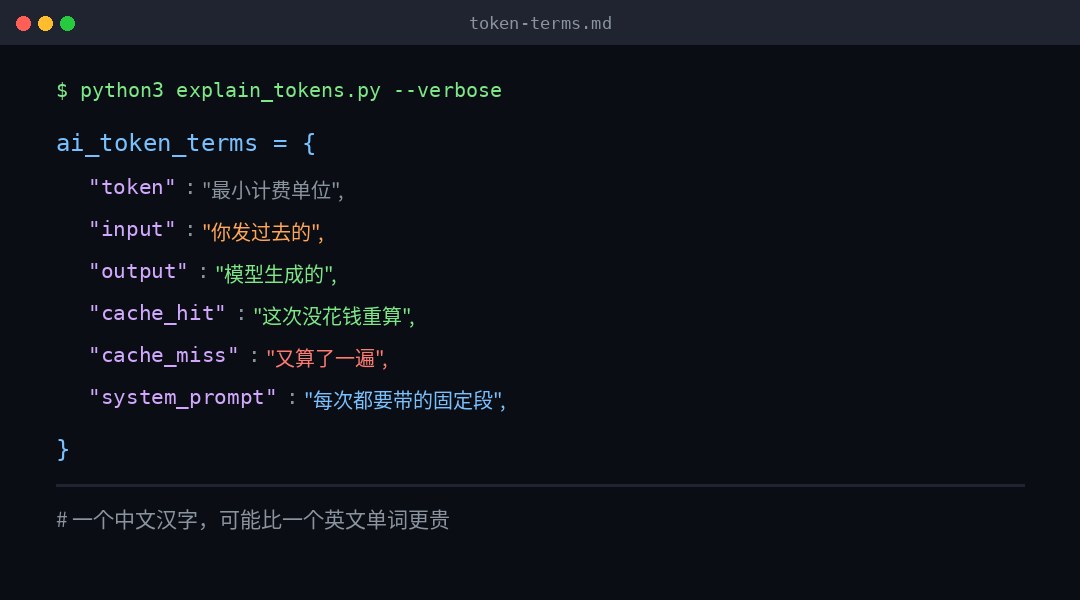
I. Token. Varför är kinesiska dyrare?
Token är den minsta enheten för modelltextbehandling. Det är inte ett ord. Det är inte ett ord.Det är en bit av semantiken.Jag vet inte. I samma mening kan antalet blockskärningar skilja sig från modell till kod.
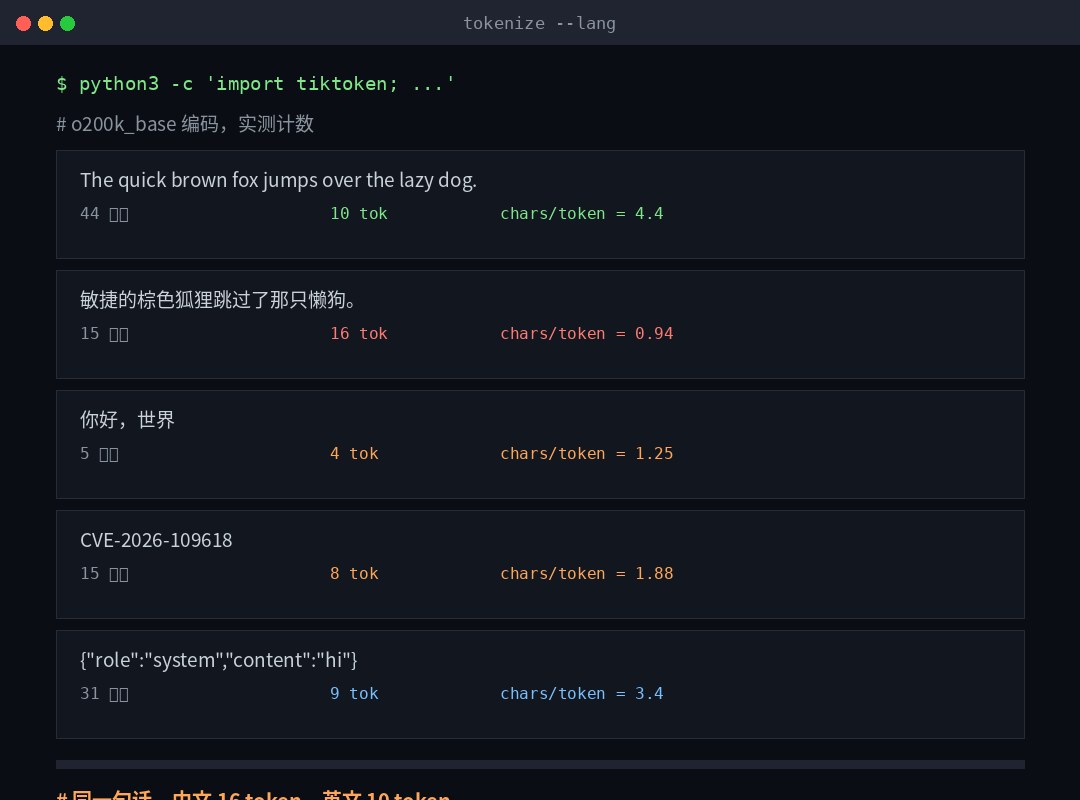
Jag tar det. o200k_base Koden mätte faktiskt flera grupper och skillnaden var större än väntat:
| Texttext | Antal tecken | Token Number | Karaktär/token |
|---|---|---|---|
| Den snabba bruna lådan hoppar över den lata hunden. | 44 | 10 | 4.4 |
| Den snabba bruna räven hoppade över den lata hunden. | 15 | 16 | 0.94 |
| Hej, världen. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Se problemet.I samma mening, 10 tokens på engelska och 16 på kinesiska.Om 4 tecken på engelskaEtt ord, ett tokenJag vet inte.
Detta är mycket ovänligt för kinesiska användare: "1 token ≈ 4-karaktären" är en engelskspråkig upplevelse.Du kommer att underskatta mer än hälften av det på kinesiska.
Det finns en motintuitiv:CVE-2026-109618 Detta nummer, 15 tecken bränner 8 tokens. Nummer och hyphens skärs mycket dåligt.Så det är mycket dyrare än det ser ut.
Två, en begäran, fyra stycken.
Första gången jag tittade på räkningen var det inte dyrt.Det är bara ett ord, men 8 000 token.Jag vet inte. Sedan blev det klart att mer än du gjorde.
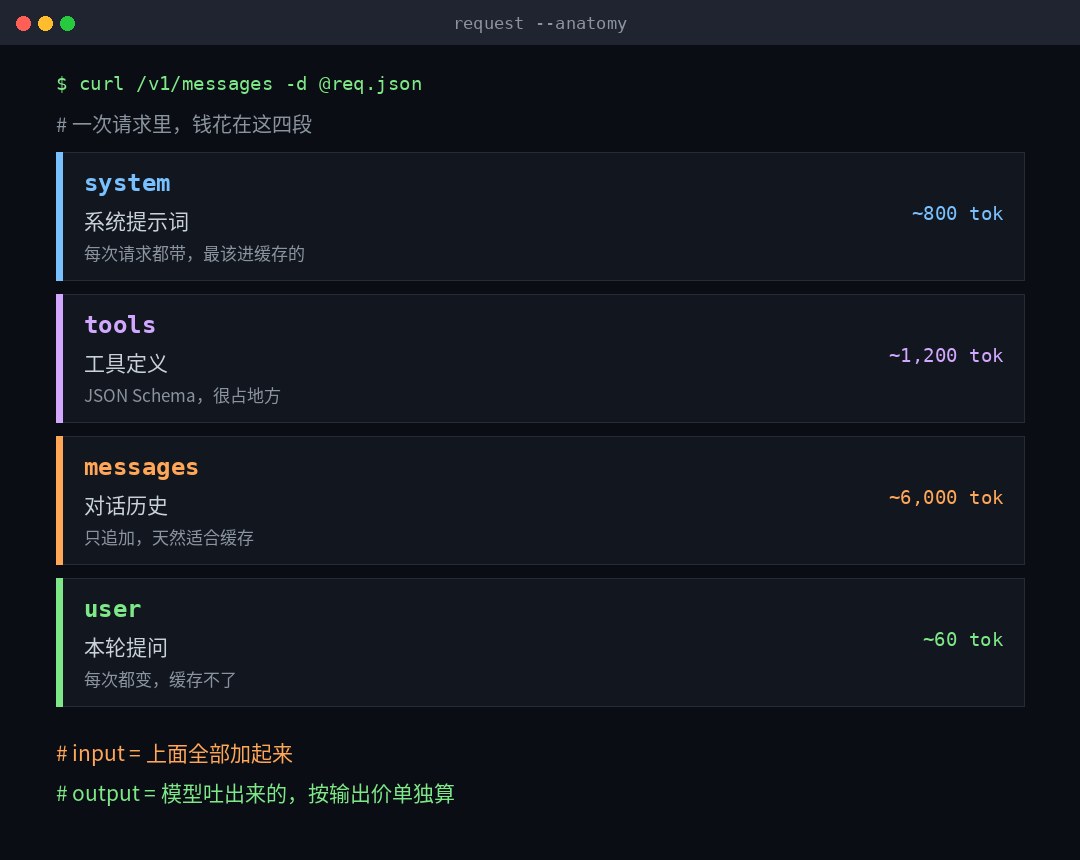
Inmatningen av en förfrågan görs vanligen i fyra delar:
| Punkt | Engelska namn | Vad är det? | Kommer det att förändras? |
|---|---|---|---|
| System Hint | System / inkludering | Vilka är du, reglerna, utdataformatet? | Det är i grunden samma. |
| Verktygsdefinition | Jag tror inte det. | Funktion JSON Schema och beskrivning | Mycket sällan. |
| Historia om dialog | Meddelanden/historien | Varje omgång av frågor och svar före dig, ta dem alla. | Lägg endast till |
| Frågor till denna runda | Jag är ledsen, herr. | Det där du bara ringde. | Varje gång. |
Första gången jag var rädd, det var.Verktyget definierar mängden 1 200 tokensJag vet inte. En funktion med parameterbeskrivning, JSON Schema expanderar för att ta speciell plats. Du skrev 20 verktyg, du kan äta 2 000 per definition.Och du skrev inte ett ord i den här delen, men det är alltid laddat.
Det finns en nyckelpunkt bakom det:De tre första styckena är ”extra och icke-modifierade” och fjärde stycket ändras varje gång.Det är inte en tillfällighet. Det avgör om cache kan drabbas.
Tre: ingång, utgång och den i utgången.
Den officiella kalibern i dessa tre relationer är följande:
- Ange token (input / policy tokens)Allt du skickar genom innehåller de fyra punkterna ovan.
- OutputModellerad. Uppmärksamhet...Inte bara texten du såg.
- Token (resoning tokens)Resonemangsmodellen är vad den tänker innan den ger svaret. Du kan inte se, men det...Till output priserJag vet inte.
Den tredje är den verkliga orsaken för många att dubbla sina räkningar. Jag kör ett slags jobb med en teorimodell, och jag ser 20 ord i svaret, och räkningen är mer än 900.880 osynlig token, det är allt där inne.
Så det är normalt att ha en motsägelse:Ju kortare svaret, desto billigare desto mindre.
Utgångspriset är vanligtvis cirka fem gånger ingångspriset (se tabellen nedan för varje hushåll). Detta förklarar en princip om integritet:Det kan lösas med ingång. Låt inte ut det.Sätt svarsmallen, formatexemplet, i systemint (lägre), så att den inte organiserar sig på ett sådant sätt att det är dyrt.
Cacheline och oattraktiv: detta är den del av hela texten som ska komma ihåg
Vad är de?
Modeller räknas som mellanliggande när de läses. Denna del är den dyraste.
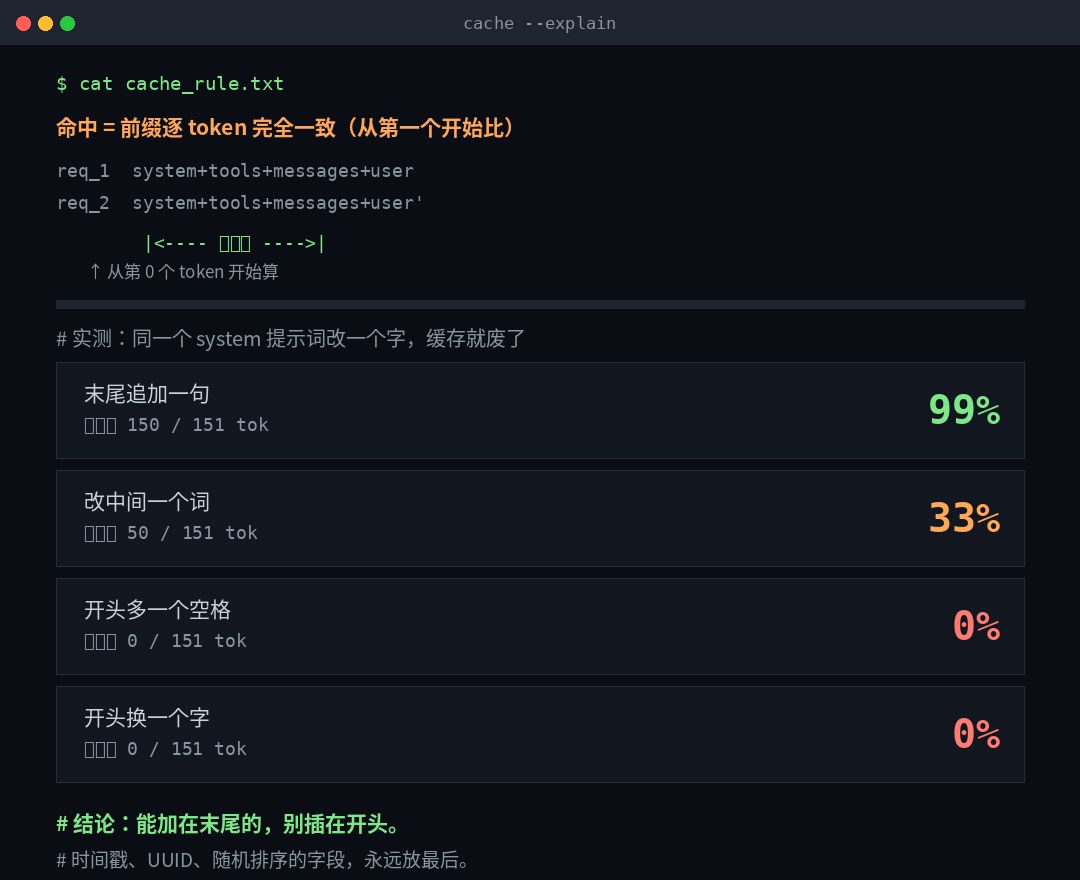
Prompt cache är ett prefixat tillstånd.Nästa gång vi möter samma prefix använder vi det direkt och beräknar inte längre.
Så det fanns två ord:
- Cache hitDenna prefix hittades i cache. Denna del kom in och pressades.rabatten.Avgifter.
- Cache missJag kan inte hitta det. Räkna bara priset.
Villkoren för träffen är hårdare än du tror.
Nyckeln är ordet "prefix".Det handlar inte om att ställa samma fråga.
Jag gjorde ett experiment: Jag tog en 151 token system antydan, ändrade den till olika platser, och tittade på hur mycket det kunde återanvändas.
| Förändringar | Återanvändbar prefix | Procentande |
|---|---|---|
| Lägg till en mening i slutet | 150 / 151 | 99% |
| Ändra ordet i mitten. | 50 / 151 | 33% |
| Ytterligare ett utrymme i början | 0 / 151 | 0% |
| Börja med ett ord. | 0 / 151 | 0% |
Se det "ett mer utrymme i början"?Ett utrymme, cachar, skrotade, omräknade 151 tokens till ursprungliga priser.
Det är inte en bugg, det är principen: Cache är ackumulationstillståndet från början, de första tokenförändringarna och ryggen är alla döda.
Det finns en regel som kan tillämpas omedelbart:Det konstanta innehållet är på framsidan och det variabla innehållet i det sista.
Det vanligaste sättet att vända är att infoga den aktuella tiden, begärt ID, slumpmässigt sorterade fält i början av systemet ledtråd. Det är som en ny cache varje gång.Dessa fält flyttas antingen till slutet eller helt enkelt inte sätta in.
Det finns ett par lättanslutna trösklar.
- Det finns en minsta längd.För kort ger ett prefix inte cache alls. OpenAI är GPT-5.6 och senare 1,024 token; Anthropic segregeras av modell, både i 512 / 1,024 / 2,048 / 4,096. Om det inte är tillräckligt länge är det inte fel.Tystnad.Du kan bara se genom att returnera kvantfältet.
- Det finns tid för överlevnad.OpenAI standard 30 minuter (upp till 12 timmar); Antropisk standard 5 minuter, upp till 1 timme. Och den här gången...Börja på begäran, räknar inte från slutet av svaret - om svaret går på fyra minuter, har 5-minuters slot bara ett minuters fönster.
- Vi väntar på varandra.Cache Entry Waits för första begäranBörja återvändaSedan är det tillgängligt. Tio förfrågningar skickades i samma sekund, och alla 10 missades.
- Ändrade modeller, ändrade verktyg, ändrade resonemangsslots.Prefixet förändras och träffhastigheten är noll.
Vad är hit rate?
Gissa inte. Båda familjerna gav dem ett volymfält:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antropisk, den speciella intuitiva:Båda återvände 0, vilket innebär att de inte ens nådde cache.- Vanligtvis eftersom prefix inte är minimala.
V. Prisstruktur: att skriva mer pengar för att läsa mindre
Cache är inte gratis, och många har missat det.Första gången du skriver i cache, måste du höja priset; sedan läsa det innan du gör en rabatt.
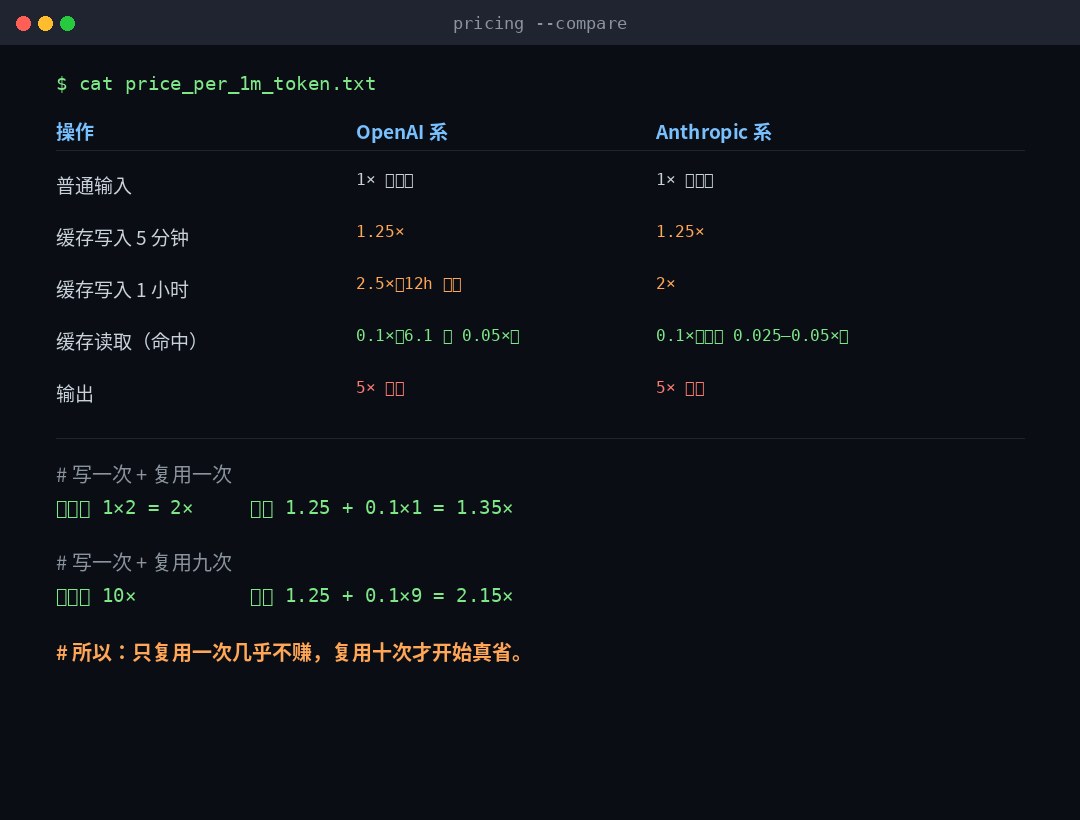
| Operation | OpenAI | Antropisk |
|---|---|---|
| Normal input | 1x (baslinje) | 1x (baslinje) |
| Cache skriver. Kort slot | 1,25 x (30 minuter) | 1,25 x (5 minuter) |
| Cache skriver långsiktigt | 2,5 x (12 timmar) | 2x (1 timme) |
| Cache Read (Kategori) | 0,1 x(GPT-6.1 är 0,05 x) | 0,1 x(Partiell modell 0,025 – 0,05 x) |
| Output | Om 5x | Om 5x |
Ta det normala 0,1 x läs, 1,25 x skriv två böcker:
- Skriv en gång + återanvändning en gångCache 1.25 + 0.1 = 1,35 x; ingen cache är 1 + 1 = 2 x.Provins 32 procent.
- Skriv en gång + upprepa nio gångerCache 1.25 + 0.9 = 2.15 xinte cache är 10x.Provinsen 78 procent.
Detta innebär:I ett fall var cachen knappt eller till och med något förlorad, det var först när det upprepades mer än tio gånger att besparingarna var verkliga.De "engångs tillfälliga samtal" är bara ett problem.
Förresten:Cache-skrivning bygger på token-segmentet, inte på antalet.Själva brytpunkten är gratis, och pengarna beror på hur länge du faktiskt har.
PUNISHMENTS, SYSTEM PUNISHMENTS, min
De två villkoren används ofta blandade, men de är olika när det gäller kostnad och auktoritet.
| Namnnamn | engelska engelska | Vem skrev den? | Prioritet | Fee attribution |
|---|---|---|---|---|
| System Hint | Stymprompt / institutioner | Platformer eller Application Developer | Högsta | Ange token |
| Utvecklare meddelande | Jag är inte säker på att jag kommer att kunna göra det. | Applicera utvecklare | Lägre (över användare) | Ange token |
| Användarintrång | Det är vår verksamhet. | Slutanvändare | Mindre än de två ovan | Ange token |
| Biträdande budskap | Det finns ingen anledning till varför du är här. | Modeller genererar sig själva | Jag vet inte. | Output Token |
Två enkla poäng:
- Ordet "reklam" är ett stort ord.Det hänvisar i allmänhet till alla textinstruktioner som du skickar till modellen, och "systemanvisningen" är den som är den mest framåt och högsta prioritet. När det gäller "reklam är för lång", är det verkliga problemet ofta att systemet är för lång för att definiera dem.
- Roll är också dyrt.Varje meddelande är ett lager
{"role":...,"content":...}Och själva lagret räknas som token. När det finns många meddelanden kommer det att vara tusentals saker.
Så rengöringsdialogen fungerar - inte geni, ja.Skär av den delen av historien.Jag vet inte. Men i sin tur är det viktigt att notera att efter att ha klarat upp kommer de historiska prefixen i den tidigare dialogen inte att behövas.
Sju eller sju av groparna jag klev på, kopiera slutsatserna.
- Använd ordet "karaktär" för att uppskatta den kinesiska budgeten.Fel. Kinesiska är nära ett ord, och du kommer att vara dubbelt så kort. Det är klart.
tiktokenDefiniera, eller titta tillbaka på användning. - Jag trodde jag skulle bli träffad om jag ställde en liknande fråga.Kan inte. Måste vara helt konsekvent från första token.
- Infogar en tidsstämpel i början av systemets ledtråd.Detta är den vanligaste cache mördaren. Flytta till slutet.
- Det är billigt att se korta svar.Resonemangsmodellens tankeprocess kostas till utgångspris, svara på 20 ord, ladda 900 token är normalt.
- Cache för engångsdialog.Återanvändning sparade endast 32 procent, men lade till ett lager av komplexitet och felsökningskostnader. Det är värt det minst tre gånger.
- Du kan gissa träfffrekvensen utan att titta på ett mätfält.Två.
cached_tokens/cache_read_input_tokensAlla återvände i klar kod. - Han bad också att använda cachen för att öka hastigheten.Cache kommer inte att vara tillgänglig förrän det första svaret börjar, och förfrågningar om samma sekund saknas till stor del.
VIII. En lista över vad som har gjorts
Vi kan förändras idag.
- Definiera system tips och verktygAllt som förändras.Flytta till slutet av meddelandet.
- VerktygspressFast orderArrangera. Ordern ändrar prefixet, prefixet ändras.
- Första räkna: Skriv ut antalet tokens i system + verktygsdefinitionen. Mer än 2000 är värt att optimera.
Det är värt en halv dag.
- Demontering av ett långsystem antyder ett "konsekvent + varierande segment", med en cachebrytning i slutet av det konstanta segmentet.
- Kör runt med riktig trafik. Record.
cached_tokensAndelen totala ingångar. Mindre än 30% indikerar prefix designproblem. - Tryck på utgångssidan också: "endast utgången" får inte förklara, utgångspriset är fem gånger ingången.
Gör det inte.
- Skriv inte ett nio tredje tips för cache.Cache är pengar, inte klarhet.
- Lägg inte till enstaka skript logiken av caches, som är mer komplicerade än besparingar.
- Det antas inte att caches kan användas över olika modeller.Switching modeller förändrar caches, med noll träffar.
Slutligen.
Dessa ord tas till slutet, och de säger bara en sak:Modellen laddar "hur mycket det läser in" och "hur mycket det skriver", och cache är den enda mekanismen som kan diskontera "läs".
Så det är inte exakt hur vacker ledtråden är, är det?Sätt den högen av saker som inte förändras varje gång. Låt oss gå.Jag vet inte.
De flesta pengar du inte kan spara är inte för dyrt. Ditt prefix ändras varje gång.
Jag lämnar dig med den mest praktiska åtgärden: nästa gång jag ser en onormal räkning, tvivla inte på modellens prisökning. cached_tokens Den kolumnen.Det är inte noll, bestämmer om du betalar för matematik eller dubbel.