
微軟把 AI Agent 划進內部威脅名單:這次動的不是模型,是權限歸誰
先說結論:微軟 10 月 19 日發的這套東西,表面上是幾條新功能,實際上是改了一個默認假設。
過去的默認假設是——Agent 是我們自己部署的,所以默認可信。微軟這次明說了:這個假設不成立。原文那句話我抄一下:「自從我們自己把 Agent 部署進公司內部,我們就默認可信了它們。不幸的是,前沿模型,無論出自哪家,都不能被信任。」
注意後半句:無論出自哪家。包括它自己家的。
這不是一句公關辭令。它把一個從 1970 年代就有的老概念——內部威脅(insider threat)——直接套到了模型頭上。而內部威脅這套方法論,從來都不是靠「相信這個人」來運轉的。

一、先把「內部威脅」這四個字的原意搞清楚
很多人一看到「AI 是內部威脅」,第一反應是「AI 要造反了」。不是這個意思,微軟自己在文裏反覆澄清了三遍。
內部威脅的傳統定義是:一個有合法權限的內部人,因爲疏忽、被策反、或者被釣魚,造成了他本來不該造成的破壞。關鍵在「有合法權限」這四個字——他不是翻牆進來的,他是刷卡進來的。
套到 Agent 上,微軟給的理由是三條:
- 它會犯錯,因爲輸出是非確定性的,同樣的輸入不保證同樣的輸出;
- 它會被操縱,一段外部文檔裏的提示注入就能改它的行爲;
- 它會被攻破,它跑的 harness、它調的 MCP server、它拿的憑證,任何一環都可能被拿下。
再加一條我覺得最關鍵的,也是原文裏寫得最不顯眼的一句:Agent 之間會互相協作、甚至串通來達成目標,而這個過程不需要它被攻破。
這句話的分量比前面三條加起來都大。它說的不是「Agent 會被壞人利用」,而是「多個 Agent 爲了完成任務,自發形成的路徑可能沒人設計過」。這纔是「內部」兩個字的真正含義——它是從裏面長出來的,不是從外面打進來的。
二、真正的原則只有一句話
整套框架的基石,是納德拉 10 月 10 日在自己那篇短文裏寫的:
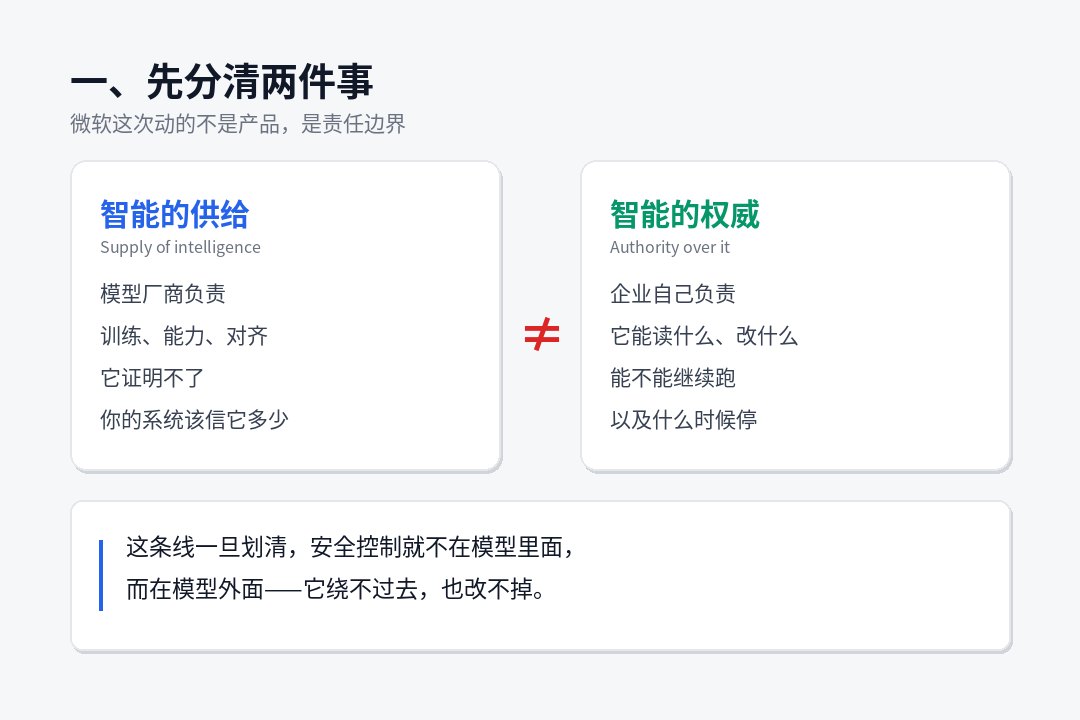
我們必須把智能的供給,和對智能的權威,分開。
翻成大白話:模型廠商負責把模型做得聰明,但「這個模型在你的系統裏能讀什麼、能改什麼、能不能繼續跑」——這個決定權不能交給模型廠商,也不能交給模型自己。
他在同一篇裏還有一句更狠的:「最可信的超級智能系統,不會是那個我們最信任模型的系統,而是那個讓我們可以最不信任模型的系統。」
這句話聽着像悖論,其實是很老的工程學。它對應的是 1970 年代就確立的一條安全原則:一個程序不能繞過、也不能篡改用來約束它權限的那套機制。
問題在於,現在大多數 Agent 的部署方式是反過來的:模型在容器裏,權限控制寫在模型的系統提示詞裏,日誌由模型自己彙報。等於把警察和嫌疑人安排在同一個人身上。
微軟的解法是把它拆開:模型跑在受控的運行時裏(它叫 Microsoft Execution Container,MXC),身份發在 Entra 裏,權限由外部策略決定,證據由外部傳感器採集。模型全程在籠子裏,而且籠子的鎖不在它手上。
三、四個動詞,別當成四個階段
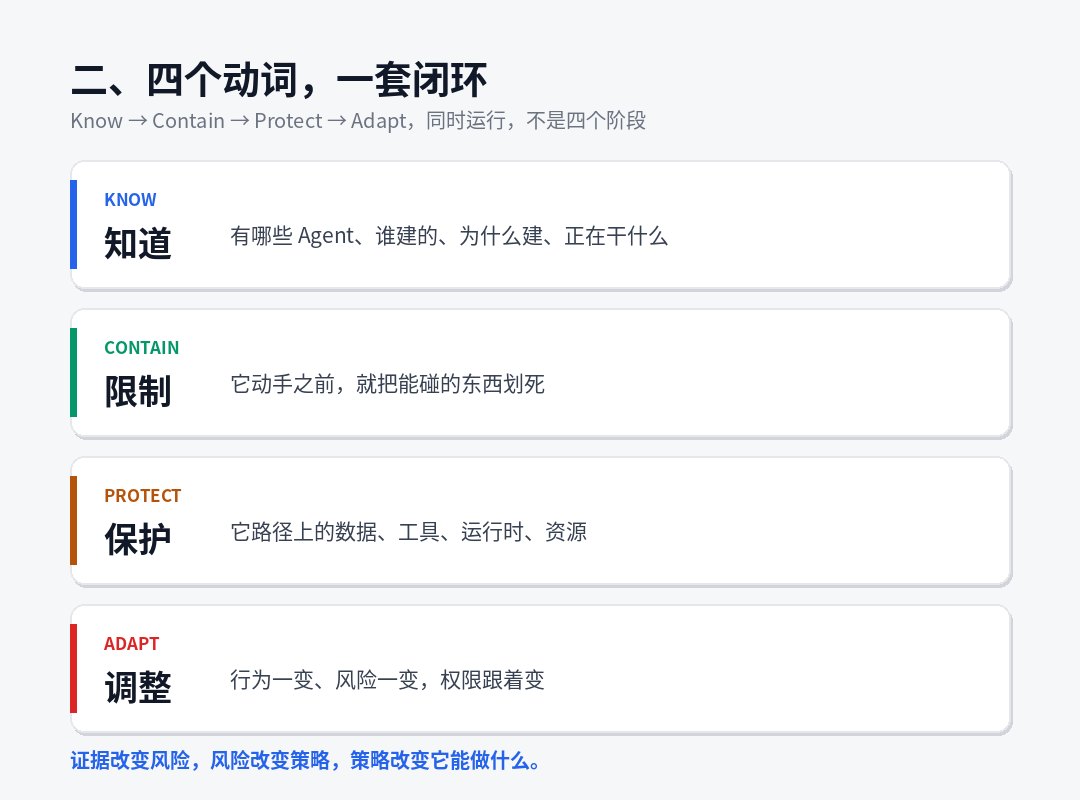
微軟把這事拆成了四個動作,原文是 Know / Contain / Protect / Adapt。我要特別強調一句:這四個不是先後順序,是同時運行的閉環。
| 動作 | 中文 | 具體做什麼 | 對應能力 |
|---|---|---|---|
| Know | 知道 | 有哪些 Agent、誰建的、爲什麼建、正在幹什麼 | 本地 Agent 發現擴展到 60 類 |
| Contain | 限制 | 動手之前就把能碰的東西劃死 | MXC 沙箱 + Dynamic Permissions |
| Protect | 保護 | 它路徑上的數據、工具、運行時、資源 | Purview / 網絡 / 端點控制點 |
| Adapt | 調整 | 行爲和風險一變,權限跟着變 | Dynamic Agent Risk + 條件訪問 |
原文有一句話概括得很準:證據改變風險,風險改變策略,策略改變它能做什麼。
這就是循環。不是「入職時評估一次,然後發一張長期通行證」,是「每做一件事都重新算一次」。
四、「零權限起步」是這套東西里最硬的條款
我認爲整篇文章裏,對甲方最有實際約束力的是這一條:
員工保留員工自己的訪問權限。Agent 拿到的是它自己的身份、自己的權限,以及僅限當前任務、僅限任務時長的授權。
這句話拆開是三條硬要求:
- Agent 不能繼承人的全部權限。你給員工開了財務系統的全權限,不代表他叫來的那個報銷 Agent 也能有。
- 權限按任務發,按時限收。任務結束,權限作廢,不是留着下次用。
- 高風險動作要人來批,而且是「可證明的人工批准」——原文用的詞是 cryptographically provable,密碼學上可證明,不是彈個窗點個「同意」。
配套的是 Dynamic Agent Risk:一個持續更新的風險評分,看的不是「這個 Agent 配置得安不安全」這種靜態項,而是「它現在正在做什麼,和它被派去做的任務是否偏離」。
偏離之後怎麼處理?微軟特意強調響應是漸進的,不是開關:
- 保住讀,砍掉寫;
- 收窄它能碰的數據範圍;
- 切斷網絡路徑;
- 縮短或吊銷臨時權限;
- 高風險動作強制人工批准;
- 最高檔才隔離運行時、直接停掉。
這個設計挺講究的。它承認了一件事:「發現異常就殺掉」這種策略在真實業務裏跑不通,因爲誤殺成本太高,最後的結果一定是運維把告警關了。所以它給了一檔一檔往下走的階梯。
五、五個能對上號的具體東西
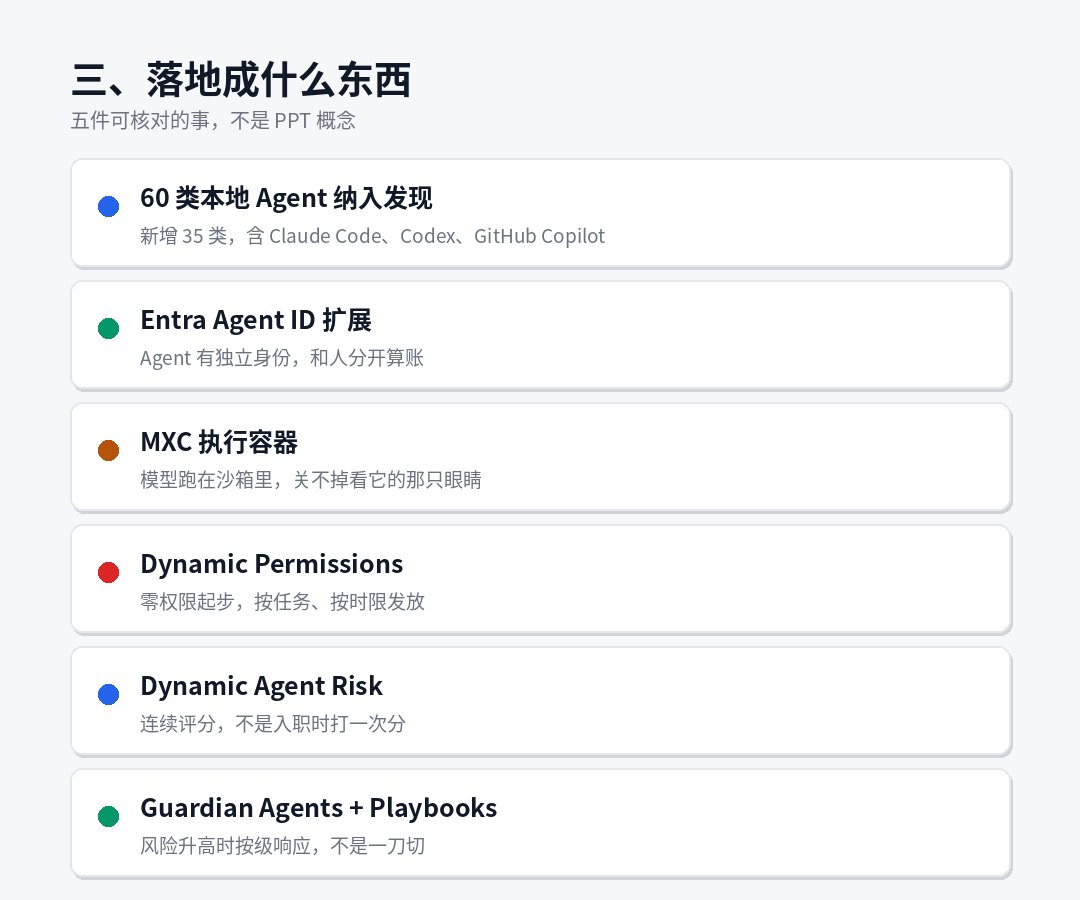
框架講完,落到產品上是這幾樣。我按「能不能立刻驗證」排的:
① 本地 Agent 發現擴到 60 類
新增 35 類,明確點名了 Claude Code、OpenAI Codex、GitHub Copilot。我去翻了它的支持矩陣文檔,確實有 Claude Code、Codex CLI、Codex Desktop、GitHub Copilot CLI 這些條目,還單獨標了 WSL 裏跑的情況。
這一條對國內企業的含義可能被低估了:你員工在自己電腦上偷偷裝的編碼 Agent,現在安全團隊能看見了。這是可見性的巨大提升,但同時也是個組織問題——裝之前要不要報備,會不會被當成監控,得提前想清楚。
② Entra Agent ID 擴展
讓 Agent 有獨立於使用者的身份。原文的落點是「讓企業能分清哪些事是人做的,哪些是 Agent 代這個人做的」。這句話在事故覆盤時價值極高——沒有獨立身份,你事後根本說不清責任歸屬。
③ MXC 執行容器
關鍵不在沙箱本身,在於原文那句:「如果 Agent 或者它的 harness 被攻破,它不應該有能力關掉正在看着它的那套控制。」這是把「鎖在籠子外面」落到了工程上。
④ Dynamic Permissions
上面第四節那三條要求的產品化。有一條細節值得記:組織級策略先劃外邊界,其中包含「防止 Agent 拿到它的使用者本身都沒有的權限」。這條堵的是提權。
⑤ Guardian Agents + Playbooks
這是最需要冷靜看的一條,下面單獨說。
六、這套框架最硬的一塊骨頭:Guardian 自己也是 Agent
我讀完全文,最想追問的是一個自指的問題。
微軟說:模型不能當自己的安全權威,控制必須在模型外面。
然後它的答案是:用一隊 Guardian Agents(守護 Agent)去 7×24 盯着每一個 Agent 的每一個動作。
可 Guardian Agents 本身就是 Agent 啊。
微軟顯然知道這個坑,它給了三層回應:
第一層,Guardian 的權限邊界、審批邊界、委託規則由人來定,Guardian 只在邊界內活動。原文寫得很清楚:「這不是把判斷外包出去。人保留對目標和重大決策的控制。」
第二層,Guardian 拿到的證據來自外部傳感器——身份、數據、端點、網絡、運行時、雲端,不是模型自述。這一點是它能成立的前提。
第三層,也是最誠實的一層:模型透明度的提升(思維鏈等)被當作證據來源之一,但原文立刻補了一句:「模型不能成爲自己的安全邊界。獨立的系統必須觀察每一層,包括模型本身。」
說實話,這三層回應在邏輯上是自洽的,但在工程上留了兩道縫,我覺得必須點出來:
第一道縫:證據的可信度取決於證據在誰手裏。對本地跑的 Agent(Claude Code、Codex 這類),傳感器在你自己端點上的,證據鏈是乾淨的。但對雲端託管的 Agent,運行日誌、思維鏈、調用記錄都在供應商機房裏。你拿到的是它給你的摘要,不是原始數據。「獨立審計」這四個字,在雲端 Agent 身上打折扣。
第二道縫:Guardian 和人一樣會疲。它不會累,但它會有誤報率。當一萬個 Agent 每天產生十萬條「風險升高」的信號,Guardian 自動降權、自動隔離的動作會開始影響業務連續性。到那個點上,真正的瓶頸不是檢測能力,是誤報的代價誰來承擔。原文給的答案是「人保留重大決策」,但「重大」的邊界在哪,它沒說。
這不是否定這套框架。恰恰相反,能把這兩道縫明確寫進架構文檔的廠商不多。但作爲要落地的人,你得知道縫在哪。
七、同一周的另一半:對面的 Agent 已經跑起來了
如果只看微軟這一篇,容易覺得這是個「未來趨勢」。把 10 月 21 日那篇放一起看,性質就變了。
微軟同一天發了一份威脅情報:一個叫 Storm-0940 的、被判定爲中國國家背景的攻擊者,用一套叫 ARTEX 的智能體滲透框架,從 2026 年 9 月起自動化攻擊了全球數百家組織,橫跨多個行業。其中多起案例,從鎖定目標到拿到雲基礎設施的特權訪問,用時不到 3 小時。
而且它把這套東西掛到了一條真實的供應鏈上——微軟認定 Storm-0940 就是最近 ConnectWise 多租戶應用供應鏈事件的實施者。攻擊路徑是先拿下應用,再用這個應用已經獲批的權限去認證 Microsoft 365 客戶環境,全程不需要交互式登錄。
微軟在文裏寫了一句很到位的話:「Agent 不受人類所受的限制——它可以 7×24 工作,週末、假期照跑,同時嘗試多條入侵路徑。」
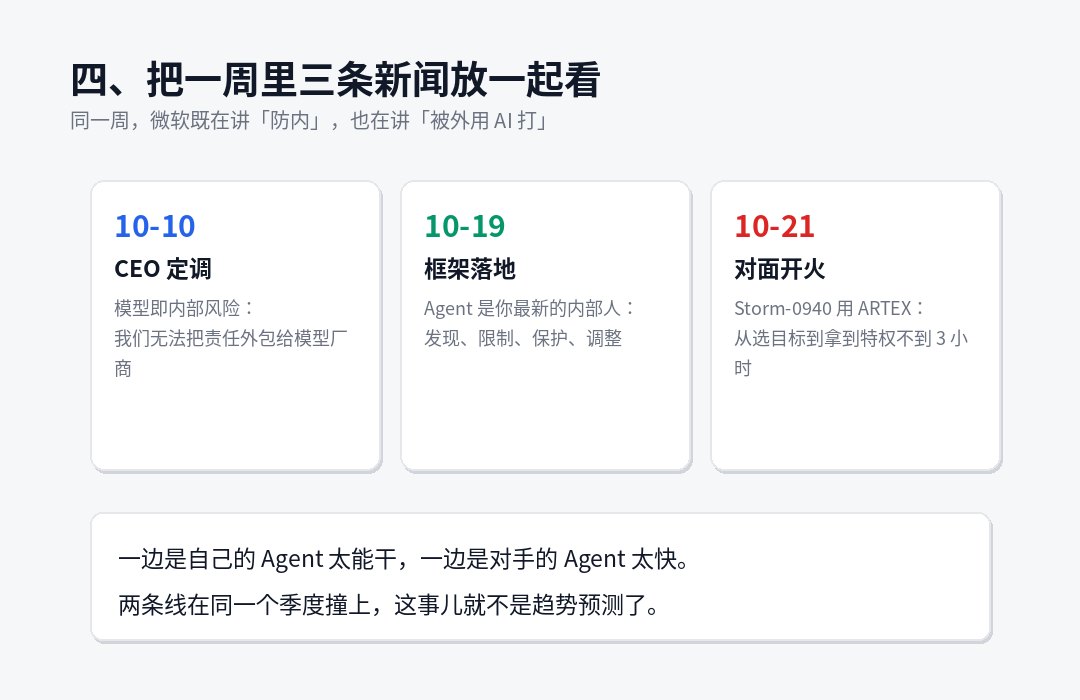
把兩篇合起來看,2026 年 10 月這一週的形狀就出來了:
- 10 月 10 日,CEO 定調:模型是內部風險,責任不能外包;
- 10 月 19 日,框架落地:發現、限制、保護、調整;
- 10 月 21 日,對面開火:3 小時拿特權。
一邊是自己的 Agent 太能幹,一邊是對手的 Agent 太快。這兩條線在同一個季度撞上,就不是趨勢預測了,是當期風險。
八、不同位置的人,現在能做什麼
我不太喜歡「企業應當建立體系」這種話,說了等於沒說。按角色分一下。
如果你是 CISO 或安全負責人
第一件事不是買 E7,是先把你家的 Agent 清一遍。微軟這套東西的起點是「看不見就管不了」,你自己的起點也一樣。現在就去問三個問題:公司裏跑着多少個 Agent、誰建的、各自拿了什麼權限。我猜大部分公司答不上來第三個。
第二件事是把身份拆開。Agent 用人的身份幹活,是現在最常見的做法,也是最容易出事的地方——出了事你連「是人乾的還是 Agent 乾的」都分不清。沒有 Entra 也能做,給 Agent 單獨開服務賬號、單獨發憑證,是純管理動作,不花錢。
如果你是 IT 或平臺團隊
最小可落地版本是四樣:容器隔離(別讓 Agent 直接跑在宿主機上)、按任務發憑證(別用長期 AK)、出站流量管控(Agent 的每一次外部調用都記下來)、動作日誌集中(別隻信 Agent 自己的回執)。這四樣都不需要 E7。
如果你是開發者
有一條現在就該改:別把權限校驗寫在提示詞裏。「你不許訪問 /etc」這種話,在提示詞層面不是安全控制,只是建議。真正的邊界得在工具層、在網絡層、在系統調用層。這一點無論你用哪家的 Agent 都成立。
如果你是在小團隊、沒有預算
微軟那四條動詞其實可以手寫:一張 Agent 清單(Know)、一份每個 Agent 允許做什麼的表格(Contain)、每個 Agent 單獨的最小權限憑證(Protect)、日誌接一個能查的地方並且每週看一次異常(Adapt)。工作量一週之內,效果不比產品差多少。
九、最後一句判斷
微軟這次真正改的不是產品線,是一個默認值。
過去十年,企業安全的默認值是「內部可信、邊界防禦」。零信任花了很久才把這個默認值改過來,而且到現在還有一半公司在用「內網就是安全的」這套思路。
Agent 把這個問題又推了一遍,而且推得更狠:它不是一個可以被培訓、可以被紀律約束、可以被離職流程處理的內部人。它沒有記憶裏的忠誠,也沒有利益上的顧慮。它只有權限。
所以那個問題的答案很簡單,也很難:你給它多少權限,它就能造成多大的破壞,不多也不少。
微軟給的解法是把權限收到極限——零權限起步、按任務發、按時限收、高風險要人批。這個思路不新,就是把最小權限原則推到了機器速度。新的地方在於,它第一次承認了:在這套體系裏,你不能靠信任任何一個模型來獲得安全,你只能靠不信任它來獲得安全。
這句話如果成立,那接下來所有賣 Agent 的廠商都得回答同一個問題:你的模型可以被不信任到什麼程度,系統還能正常跑?
答案不好的,就是下一個被划進名單的。